
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Условия подготовки русского текста меняют вердикт детектора, даже когда модель и задание остаются прежними. В препринте Stanislav Kirichenko, который не прошёл рецензирование и приводит замеры самого автора, из четырёх способов оценки три сдвинули результат в одну сторону, а модель-оценщик — в противоположную. Детектор в продукте может измерять особенности пайплайна вместо происхождения текста.
Для основного сравнения одну модель просили выполнить одно задание в разных формулировках. Менялись требования к стилю и структуре, но не источник текста. Машинность оценивали по интерпретируемому индексу признаков, обученному классификатору, метрике на открытой русскоязычной модели без дополнительного обучения и модели-оценщику.
Все способы заметили смену условий, но не согласились, какой вариант выглядит более машинным. Значит, общий сдвиг оценки ещё не подтверждает авторство: разные процедуры реагируют на разные сочетания лексики, структуры и формата.
Особенно заметно вмешательство источника и предобработки. Один идентификатор источника отделил человеческие тексты от машинных с AUROC 1,000 — это площадь под ROC-кривой, где единица означает полное разделение классов. В другом тесте удаление маркеров выделения не изменило полный текст ни на один символ, однако предобработка иначе провела границу между заголовком и обычным текстом, после чего уверенный вердикт «машинный» сменился на «человеческий».
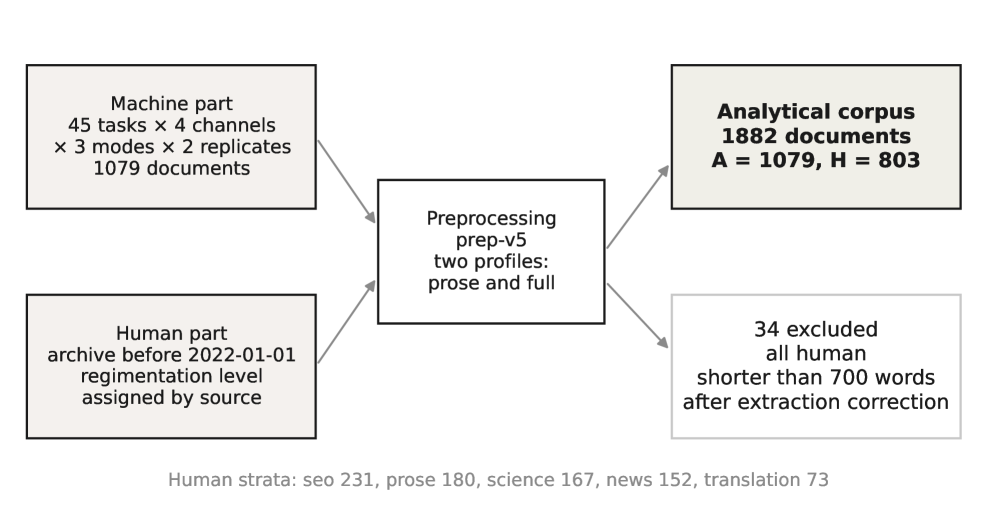
Проверка охватывает корпус из 1882 русскоязычных документов: машинную часть по 45 заданиям в трёх режимах и архивную человеческую часть, включая академическую прозу и переводы. Все процедуры работали на одном корпусе, поэтому результат показывает зависимость внутри этой системы измерения, а не универсальную величину ошибки для любого детектора.
Для продукта это меняет роль такого инструмента: его безопаснее использовать как сигнал для проверки, а не как доказательство. Порог придётся настраивать на тех же источниках, форматах и этапах обработки, которые будут в рабочем контуре; замена шаблона или парсера требует повторной проверки.
Источники
Иллюстрация: рисунок из статьи «Same Origin, Different Verdicts: Text Production Conditions Confound Machine-Generated Text Detection in Russian», Stanislav Kirichenko, CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


