
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
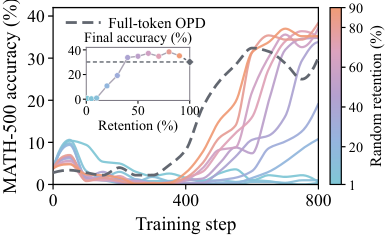
Меньшая часть подсказок учителя может обучить языковую модель лучше, чем полный набор. В препринте DIAL-OPD, который не проходил рецензирование, авторы получили прирост средней точности до 5,25 процентного пункта при сохранении 40% токенов. Для команд это повод сначала проверить отбор обучающих сигналов, а не сразу увеличивать модель-учителя.
Большое расхождение не всегда означает полезный сигнал
Работа посвящена дистилляции на ответах ученика, или OPD. Модель-ученик генерирует решение, а модель-учитель оценивает вероятность каждого сгенерированного токена. Разница между оценками превращается в обучающий сигнал: ученик повышает вероятность токенов, которые учитель считает уместнее, и снижает вероятность ошибочных.
Практический вариант OPD не запрашивает у учителя распределение вероятностей по всему словарю. Он использует только вероятности токенов, которые уже выбрал ученик. Это экономит память и обмен данными, но делает сигнал шумнее: один токен представляет расхождение двух полных распределений.
Простой способ выбрать важные токены — оставить позиции с наибольшим отношением вероятностей учителя и ученика. Проблема в том, что такое отношение не учитывает абсолютный масштаб. Токен может получить высокий вес, хотя обе модели считают его почти невозможным.
Такие позиции авторы называют low-low токенами: и учитель, и ученик дают им низкую вероятность. В одном из разборов они занимали 20,6% выбранных позиций, но несли 49,8% суммарного обучающего сигнала. Когда их заменили более вероятными токенами, модель быстрее начала улучшаться и закончила обучение с более высокой точностью.
DIAL-OPD учитывает и расхождение, и уверенность моделей
DIAL-OPD добавляет к величине расхождения среднюю вероятность токена у учителя и ученика. Если обе модели почти исключают токен, его итоговая оценка снижается. Если одна модель уверена, а другая нет, метод может сохранить позицию как полезный пример разногласия.
За баланс отвечает параметр β. Слабое взвешивание оставляет слишком много low-low токенов, а сильное отбрасывает содержательные расхождения, где одна модель распознала правильный шаг. Лучший результат дало умеренное значение: оно убирало шум, но сохраняло исправления, влияющие на ход решения.
Отбор выполняется отдельно внутри каждого ответа. Все токены остаются в контексте, поэтому модель видит решение целиком, но функция потерь учитывает только позиции с наивысшей оценкой. Маска пересчитывается на каждом шаге по свежим ответам ученика.
Разбор отдельных примеров показывает, зачем нужен масштаб вероятности. Метод отбрасывал служебный идентификатор и лишний переход к уже найденному ответу, хотя они получили большой сигнал. При этом он сохранял слово из правильной формулы и цифру с арифметической ошибкой: их сигнал был слабее, но они меняли корректность рассуждения.
Сначала отбор сигналов, затем увеличение учителя
При одинаковой доле сохранённых токенов DIAL-OPD превзошёл лучший другой способ отбора на величину до 18% относительно его средней точности. На AIME25 метод вдвое увеличил долю задач, для которых хотя бы один из нескольких ответов оказался верным.
Главный результат для выбора архитектуры обучения связан с размером учителя. DIAL-OPD с моделью-учителем вдвое меньшего размера обошёл сильнейший вариант обучения по всем токенам с более крупным учителем. Максимальный разрыв средней точности составил 1,76 процентного пункта, причём эффект сохранился для обоих размеров ученика.
Проверка охватила четыре пары моделей Qwen3 и семь математических наборов задач. Учеников обучали на DeepScaleR, а затем оценивали на задачах от школьной арифметики до олимпиадной математики. Поэтому результат напрямую относится к дистилляции рассуждающих моделей на математике, где ответы длинные и отдельная ошибка способна испортить всю цепочку.
Работа меняет порядок экспериментов для команд, которые уже используют OPD. Перед переходом на более крупного учителя стоит сравнить обучение по всему ответу с отбором токенов по расхождению и абсолютной вероятности. Такой тест не требует менять исходную функцию потерь: DIAL-OPD добавляет расчёт оценки и маску выбранных позиций.
Долю сохранённых токенов нельзя напрямую считать экономией вычислений. Чтобы выбрать позиции, система всё равно получает вероятности учителя и ученика для каждого токена ответа, а эксперименты сравнивали качество при фиксированном числе обновлений. Практический выигрыш здесь подтверждён в точности и требуемом размере учителя, но не в итоговой стоимости обучения.
Источники
Иллюстрация: рисунок из статьи «DIAL-OPD: Learning More from Fewer Tokens in On-Policy Distillation», Anhao Zhao, Haoran Xin, Junlong Tong и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


