
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Для диффузионных моделей лучший способ обновлять веса меняется вместе с задачей: универсального победителя не оказалось. Команда из CISPA, KAUST, MBZUAI и EPITA сравнила семь оптимизаторов в четырёх постановках, хотя препринт не рецензирован и все числа получили сами авторы. AdamW остался надёжной отправной точкой, но на отдельных задачах Muon, MARS-M и SOAP дали лучший результат.
Как оптимизаторы поставили в равные условия
Оптимизатор превращает вычисленные градиенты в обновления весов модели. От него зависят скорость обучения, устойчивость процесса и итоговое качество, но диффузионные модели обычно наследуют AdamW из предыдущих работ без прямого сравнения с альтернативами.
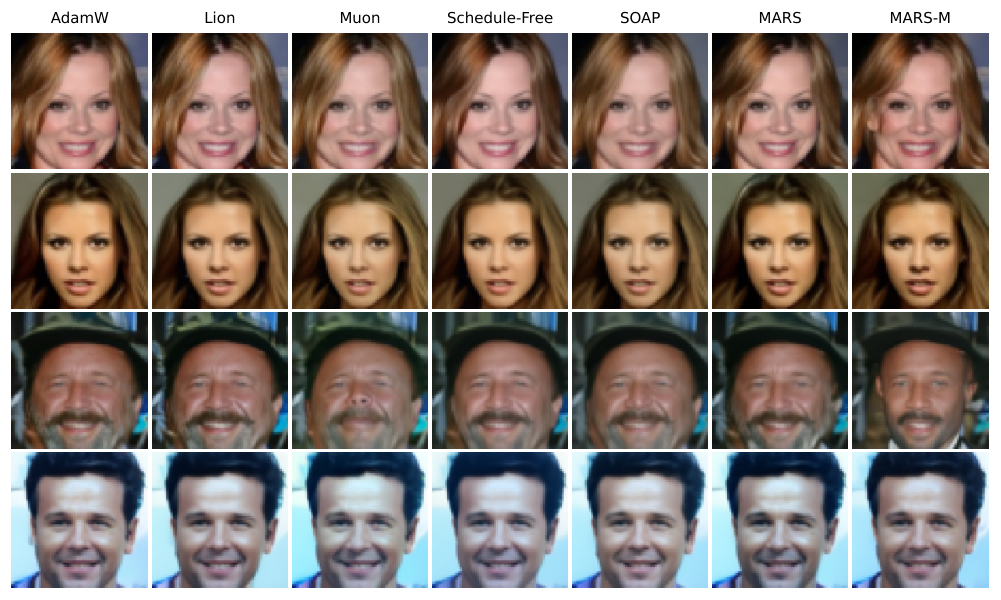
В тест вошли AdamW, Lion, Muon, SOAP, MARS, MARS-M и Schedule-Free. Их проверяли на маскированной диффузии для text8, равномерной диффузии для молекул QM9, языковой задаче LM1B и гауссовой диффузии изображений CelebA-64.
Каждый оптимизатор получил одинаковую процедуру подбора гиперпараметров. Сначала конфигурации обучали на 20% полного бюджета, затем выбранный вариант запускали заново с полным бюджетом и тремя начальными состояниями модели. Подбор и итоговое обучение заняли около 1400 GPU-часов.
Такой протокол отделяет свойства оптимизатора от качества настройки. Если тщательно подобрать только новый метод, а AdamW оставить с параметрами из другой работы, преимущество может объясняться не алгоритмом, а неравными условиями.
Границы сравнения заданы четырьмя конкретными сочетаниями модели, датасета и формулировки диффузии. Для каждой задачи использовали один размер модели и один размер пакета, а крупнейшая модель содержала 137 млн параметров. LM1B обучали с сокращённым относительно исходной работы бюджетом, поэтому её порядок оптимизаторов авторы считают предварительным.
AdamW проиграл там, где различия уже нельзя списать на разброс
На text8 и CelebA-64 ни одна альтернатива не обошла настроенный AdamW. На QM9 впереди оказались SOAP, Lion и Muon, но преимущество по перплексии составило менее 0,3%. Перплексия показывает, насколько уверенно модель предсказывает данные; меньшее значение означает лучший результат.
Самый заметный разрыв появился на LM1B. Muon и MARS-M снизили перплексию относительно AdamW на шесть-семь пунктов. При этом SOAP, который лидировал на QM9, здесь оказался хуже базового варианта.
Места не переносились между постановками. MARS-M лидировал на одних задачах и отставал на других, а Lion оказался конкурентоспособен на QM9, но нестабилен на LM1B. Schedule-Free завершил все задачи последним, хотя на ранних этапах некоторых запусков опережал остальные методы: отсутствие завершающего снижения скорости обучения изменило итоговый порядок.
Функция потерь также не всегда предсказывала качество сгенерированных объектов. На QM9 порядок по перплексии расходился с метрикой сходства с реальными молекулами, а на CelebA-64 — с FID, который сравнивает распределения признаков настоящих и созданных изображений. Поэтому выбирать оптимизатор только по кривой обучения рискованно.
Что менять в плане обучения диффузионной модели
AdamW можно оставить базовым вариантом, если команда не готова оплачивать отдельное исследование оптимизаторов. Работа не показывает, что его нужно заменить повсеместно: после равного подбора параметров он выиграл или разделил первое место на половине постановок.
Для нового обучения с нуля разумнее включить Muon, MARS-M и SOAP в короткий сравнительный этап. Все три метода хотя бы раз обошли AdamW, но ни один не сохранил преимущество на разных формулировках диффузии. Результаты с авторегрессионных языковых моделей здесь служат списком кандидатов, а не готовым рецептом.
Сравнивать варианты нужно при одинаковом бюджете подбора, а победителя затем переобучать на полном бюджете. Для генерации изображений и молекул к функции потерь стоит добавить метрику качества образцов: иначе команда может выбрать модель, которая лучше оптимизирует учебную цель, но создаёт менее подходящие результаты.
Следует учитывать и время работы. У Muon и SOAP дополнительные матричные операции слабо меняли расчётное число операций, но увеличивали фактическое время шага. Если обучение ограничено сроком или стоимостью GPU, итоговый тест должен сравнивать не только качество после одинакового числа шагов, но и качество при одинаковом времени.
Источники
Иллюстрация: рисунок из статьи «Optimizers for Diffusion Models: A Controlled Benchmark», Arman Bolatov, Egor Shulgin, David Li и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


