
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
У диффузионных моделей увеличение числа параметров может ухудшать работу задолго до привычного пика ошибки: сеть начинает запоминать обучающие примеры вместо общей структуры данных. Raphaël Urfin, Tony Bonnaire, Giulio Biroli и Marc Mézard показали, что ухудшение начинается при p≈n, а пик сдвигается к p≈nm, хотя работу не рецензировали и числа получили сами авторы. Поэтому отсутствие видимого пика не подтверждает, что выбранный размер модели безопасен без ранней остановки или другой регуляризации.
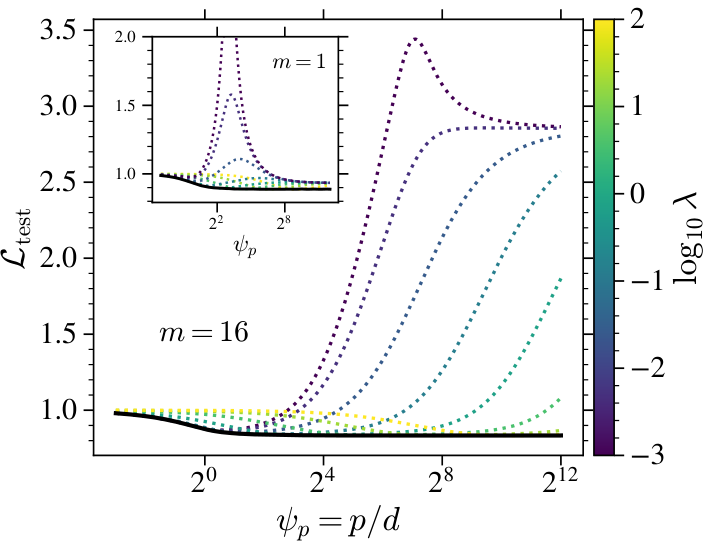
В обозначениях работы p — число параметров, n — число обучающих примеров, m — число вариантов шума для каждого примера. В обычной регрессии ошибка сначала падает, затем достигает пика, когда модель точно подгоняет обучающие данные, и снова снижается. У диффузионной модели пик возникает лишь около p≈nm, но ошибка на новых данных начинает расти уже около p≈n и после второго снижения остаётся выше прежнего минимума.
Причина — в цели, к которой ведёт обучение. Модель всё точнее восстанавливает поле, указывающее, как удалить шум вокруг конкретных обучающих примеров, а не поле всего распределения данных. Разброс предсказаний после пика уменьшается, как в обычной регрессии, но систематическая ошибка продолжает расти: модель приближается к режиму запоминания.
Штраф за сумму квадратов весов в теоретической модели и ранняя остановка U-Net убрали пик из ошибки на новых данных. При правильно подобранной регуляризации крупные модели оказались лучше всех вариантов без неё. Практический вывод касается не отказа от больших моделей, а режима обучения: размер нужно выбирать вместе с моментом остановки или явным штрафом.
Механизм проверяли аналитически на двухслойной модели со случайными признаками и экспериментально на U-Net. Сети обучали на полутоновых изображениях CelebA размером 32×32: выборки содержали от 512 до 8192 изображений, а модели — примерно от 29 тысяч до 240 миллионов параметров. Шумы для каждой картинки фиксировали; проверка охватывает один датасет и модели указанного масштаба.
Источники
Иллюстрация: рисунок из статьи «Double Descent and Malign Overfitting in Diffusion Models», Rapha\"el Urfin, Tony Bonnaire, Giulio Biroli и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


