
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Модель вознаграждения научили выдавать не один балл за ответ, а несколько правдоподобных оценок и степень разногласия между ними. В нерецензированном препринте команды Tsinghua University, The Chinese University of Hong Kong и University of Illinois Urbana-Champaign, где все числа получили сами авторы, DRM сравнялась с сопоставимыми моделями или обошла их и улучшила последующее обучение с подкреплением по человеческой обратной связи (RLHF).
Оценка становится распределением, а не баллом
Обычная модель вознаграждения получает запрос и ответ, а возвращает одно число. Оно неизбежно смешивает разные представления о полезности, безопасности и точности, хотя оценщики могут систематически не соглашаться друг с другом.
DRM вместо готового балла строит распределение возможных оценок. Оно может иметь несколько пиков: например, одна группа оценщиков считает ответ приемлемым, а другая — плохим. Среднее значение по-прежнему можно передать стандартному алгоритму RLHF, но модель также отдаёт разброс и нижнюю границу вероятной оценки.
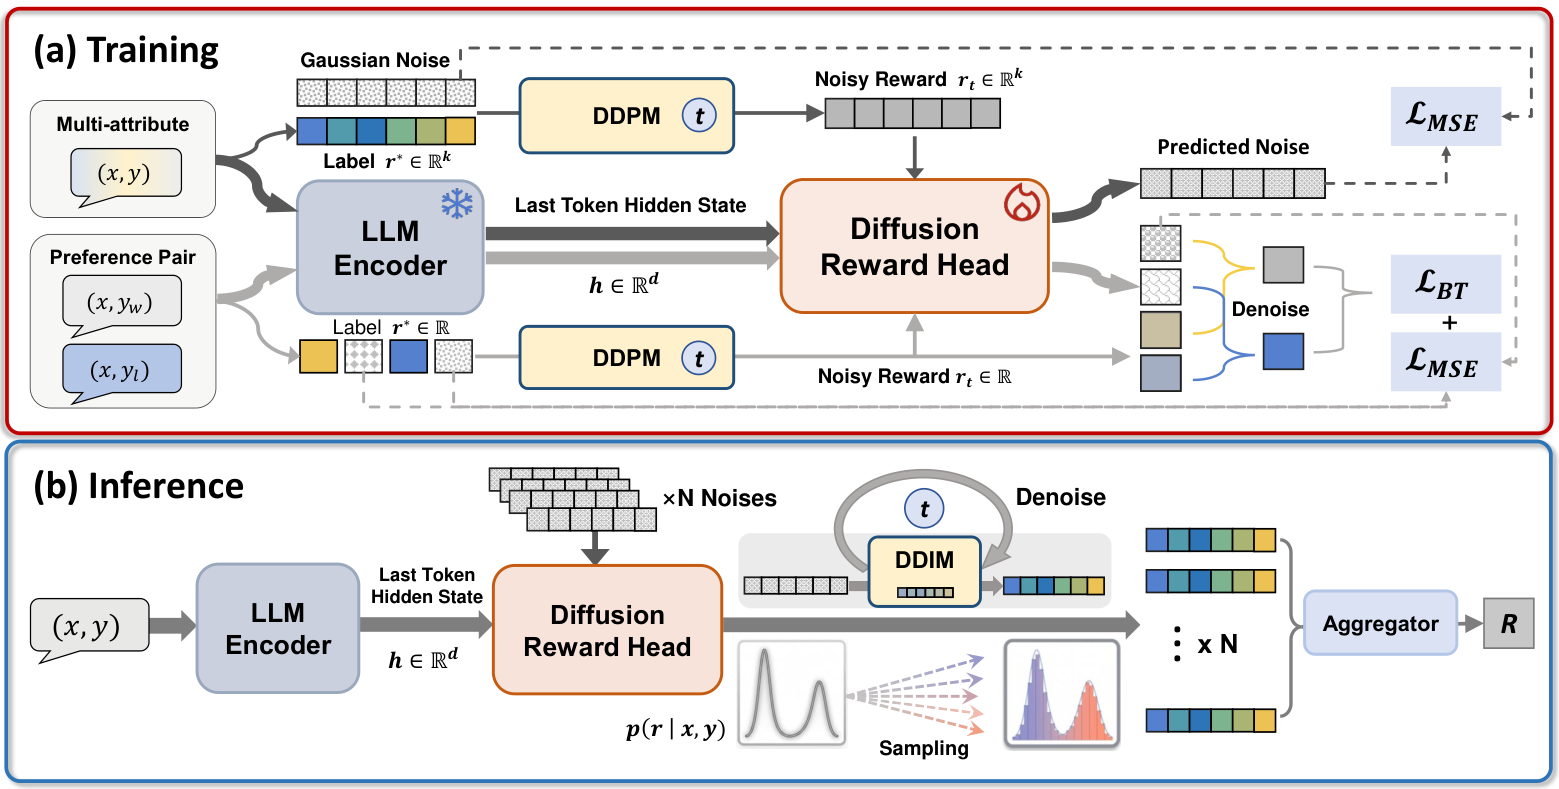
Архитектура состоит из замороженного языкового кодировщика масштаба 8B и небольшой диффузионной головы. Кодировщик превращает пару «запрос — ответ» в скрытое представление, после чего голова начинает со случайного шума и поэтапно восстанавливает из него вектор награды. В отличие от моделей, которые заранее предполагают нормальное распределение или фиксированный набор квантилей, DRM не ограничивает итоговую форму одной заданной семьёй.
Одна схема поддерживает два вида данных. Для размеченных характеристик голова учится восстанавливать оценки только по доступным полям; корпус DRM-Multi содержал 569 тысяч примеров по 19 характеристикам. Для пар предпочтений DRM-Pref использовала 273 тысячи пар Tulu3 и дополнительную функцию потерь, которая требует ставить выбранный ответ выше отвергнутого.
Во время вывода DRM несколько раз запускает обратный диффузионный процесс для одного ответа. Получившийся набор значений можно усреднить, использовать для оценки неопределённости или свести к консервативной награде, которая учитывает нижнюю границу распределения.
Больше выборок точнее разделяют ответы
DRM проверили на пяти наборах задач, которые охватывают диалоги, выполнение инструкций, математику, код, фактическую точность и безопасность. Сравнение включало обычные скалярные модели, модели с заранее заданным видом распределения и генеративных судей; при прямом сравнении данные и языковой кодировщик совпадали.
На RewardBench v2 вариант DRM-Multi поднялся с 56,5% при одной выборке награды до 65,6% при 32 выборках. DRM-Pref вырос с 64,4% до 65,7%. Дополнительные вычисления здесь уточняют оценку уже готового ответа, а не расширяют набор ответов, из которого система выбирает лучший.
Повторные человеческие оценки показали, что при большем разногласии DRM чаще строит распределения с несколькими пиками. Обычная скалярная модель сводила тот же сигнал к точке, а генеративный судья давал в основном одновершинный результат: случайность генерации вердикта не стала моделью человеческого несогласия.
Распределение оказалось полезно не только для визуального анализа. Отбрасывание примеров с высокой неопределённостью улучшало решения модели вознаграждения, а консервативная агрегация помогала не выбирать ответ только из-за высокого среднего балла. При обучении политики DRM также дала лучший результат, чем сопоставимые варианты награды.
Границы проверки узкие: использовался один замороженный кодировщик, фиксированный масштаб данных и несколько сотен тысяч открытых примеров. DRM не превзошла сильнейшие открытые скалярные модели по абсолютному результату, поэтому работа пока показывает преимущество постановки при сопоставимых условиях, а не универсальную замену существующих моделей.
Когда DRM меняет архитектурный план
Для систем, где награду можно проверить формально, например по тестам программы или точному математическому ответу, распределение человеческих предпочтений не решает основной задачи. DRM нацелена на общие диалоги и другие случаи, где полезность зависит от нескольких допустимых взглядов.
Если продукт уже обучает собственную модель вознаграждения, работа предлагает заменить только её выходную голову, сохранив языковой кодировщик. Представления запросов и ответов можно вычислить заранее, а диффузионную часть обучать отдельно. Это снижает стоимость эксперимента по сравнению с полным переобучением кодировщика.
Цена такого перехода проявляется во время вывода: один ответ приходится оценивать несколько раз. Команда получает новый регулятор между скоростью и точностью, но для фильтрации больших потоков запросов скалярная модель останется проще. DRM рациональнее применять там, где ошибочная награда влияет на обучение политики, отбор сложных примеров или рискованные продуктовые решения.
Перед сменой архитектуры полезно проверить не только среднюю точность на внутреннем наборе, но и связь разброса DRM с реальным несогласием оценщиков. Если разные выборки лишь добавляют шум, дополнительная стоимость не окупится. Если распределение выделяет спорные ответы и улучшает итоговую политику, его можно использовать для отказа от сомнительных оценок и более осторожной оптимизации.
Источники
Иллюстрация: рисунок из статьи «Diffusion Reward Models», Xiangyang Wang, Bingxiang He, Zeyuan Liu и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


