
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Speech-LLM научили сохранять способность выполнять новые голосовые инструкции после обучения только распознаванию речи. В работе IIIT Delhi, Microsoft Research India и National University of Singapore метод DirectSpeech2LLM обошёл каскадную систему на транскрибации и приблизился к ней на незнакомых задачах, хотя препринт не рецензирован и все числа получили сами авторы. Для команд это повод проверить прямой ввод речи в LLM до того, как собирать отдельный набор инструкций под каждую задачу.
Почему модель заучивает инструкцию транскрибации
Обычная Speech-LLM соединяет речевую модель с языковой через обучаемый проекционный модуль. Во время настройки на автоматическое распознавание речи система привыкает связывать любой звуковой ввод с одной операцией: превратить его в текст.
После этого новая инструкция не обязательно меняет поведение. Модель может получить просьбу перевести запись или определить эмоцию, но продолжить транскрибацию. В работе это называют переобучением на инструкции: исходная LLM умела выполнять разные команды, однако речевой вход сузил её поведение до одной задачи.
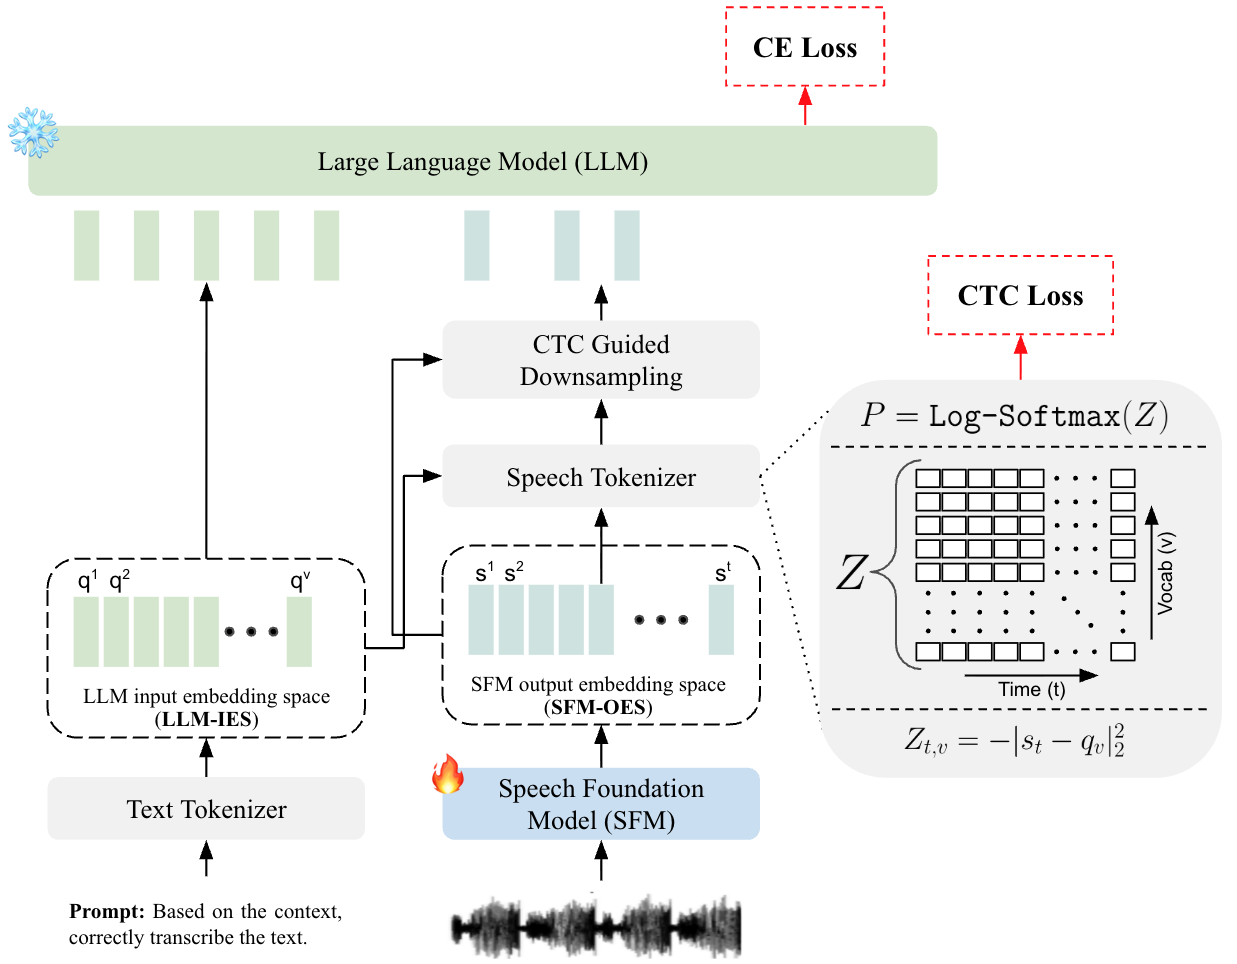
DirectSpeech2LLM связывает выход речевой модели не с произвольным пространством нового адаптера, а с матрицей входных векторных представлений LLM. Параметры самой LLM не меняются, поэтому речевой модуль должен приспособиться к уже существующей геометрии токенов, а не создать собственный код, понятный только транскрибации.
Для этого метод вычисляет оценки токенов как расстояния между представлением каждого звукового кадра и входными представлениями LLM. Функция потерь CTC сопоставляет длинную последовательность кадров с короткой последовательностью текстовых единиц без заранее размеченных границ между звуками.
Затем соседние кадры, которым назначен один токен, усредняются. Так модель одновременно приближает речь к знакомым LLM представлениям и сжимает её по смысловым границам, а не через фиксированный интервал. Отдельный адаптер между речевой моделью и LLM не нужен.
Обучение проходит в два этапа. Сначала речевой модуль осваивает выравнивание через CTC, затем получает обратную связь от языковой модели через обычную ошибку предсказания следующего токена. LLM на обоих этапах остаётся замороженной.
Перенос сохранился на переводе и распознавании эмоций
Систему обучали на 960 часах английской речи LibriSpeech и только на задаче транскрибации. Проверка охватила распознавание речи на LibriSpeech и VoxPopuli, перевод с английского на немецкий и китайский на CoVoST2, а также классификацию эмоций на IEMOCAP. В качестве основы использовали Qwen3-4B и Phi3.1-3.8B.
На знакомой задаче DirectSpeech2LLM превзошёл каскад, который сначала получает текст, а затем передаёт его LLM. На переводе и распознавании эмоций модель выполнила новые инструкции без обучения на примерах этих задач и приблизилась к верхней границе каскадной системы.
Главная проверка метода — удаление дополнительной функции, которая явно притягивает речевые представления к токенам LLM. У DirectSpeech2LLM качество перевода с английского на немецкий снизилось по BLEU с 19,97 до 19,69. У Wav2Prompt удаление аналогичной функции снизило результат с 13,8 до 5,4 на другой языковой паре, поэтому абсолютные оценки этих методов напрямую сравнивать нельзя, но разница в чувствительности заметна.
Это означает, что основную геометрическую привязку уже создаёт модифицированная CTC. Команде не приходится точно подбирать вес отдельной регрессионной ошибки, без которой альтернативный подход терял способность переносить инструкции.
Ещё один источник переобучения оказался связан с пустым токеном CTC. Когда его представление всегда стояло в начале последовательности, модель связывала эту позицию с транскрибацией. Удаление пустого представления или перенос в конец во время вывода восстанавливали выполнение новых инструкций. Это небольшая деталь реализации, способная изменить результат без повторного обучения.
Что меняется в планах речевого продукта
Работа не даёт основания сразу заменять производственный каскад прямой Speech-LLM. Эксперименты ограничены английским обучающим корпусом, двумя семействами LLM и выбранными наборами для транскрибации, перевода и эмоций. Многоязычное и полноценное многозадачное обучение изучено лишь частично, а роль пустого представления в передаче голоса, интонации и других акустических признаков пока неясна.
Зато DirectSpeech2LLM меняет порядок архитектурных экспериментов. Если продукт должен принимать речь и выполнять разные команды, сначала можно проверить выравнивание с замороженными входными представлениями LLM, динамическое сжатие через CTC и вывод без пустого токена. Лишь после этого стоит компенсировать слабый перенос синтетическими инструкциями или отдельными наборами для каждой задачи.
Один и тот же речевой модуль можно использовать как самостоятельный CTC-транскрибатор, дополнить статистической языковой моделью или подключить напрямую к LLM. Это позволяет сравнивать каскадный и сквозной варианты без полной смены речевой основы.
Практическая ценность метода не в гарантированной замене каскада, а в более дешёвой гипотезе для прототипа: сохранить языковую модель замороженной, не добавлять проекционный адаптер и проверить перенос на реальных инструкциях продукта. Если он сохраняется, команде не придётся учить речевую систему заново для каждой следующей команды.
Источники
Иллюстрация: рисунок из статьи «DirectSpeech2LLM: A Simple End-to-End Framework to Mitigate Prompt Overfitting in Speech-LLMs», Hemant Yadav, Sunayana Sitaram, Roger Zimmermann и др., CC0 1.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


