
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Система сохранила точность ответов, когда контекст вырос до миллиона токенов. В препринте National University of Singapore и Adobe Research, который не рецензировался, а все числа получили сами авторы, DISCO сравнялась по качеству с обработкой полного контекста моделью Gemini-3-Pro-Preview и сократила расходы более чем на 80%. Вместо покупки всё более длинного окна команды могут распределить чтение документов между небольшими моделями, оставив сложные рассуждения центральной.
Длинный текст читают исполнители, а ответ строит управляющая модель
DISCO исходит из того, что поиск фактов и рассуждение требуют разных ресурсов. Когда одна LLM одновременно просматривает большой документ, выделяет свидетельства и связывает их в ответ, качество падает задолго до формального предела окна. Авторы называют это распадом контекста (context rot).
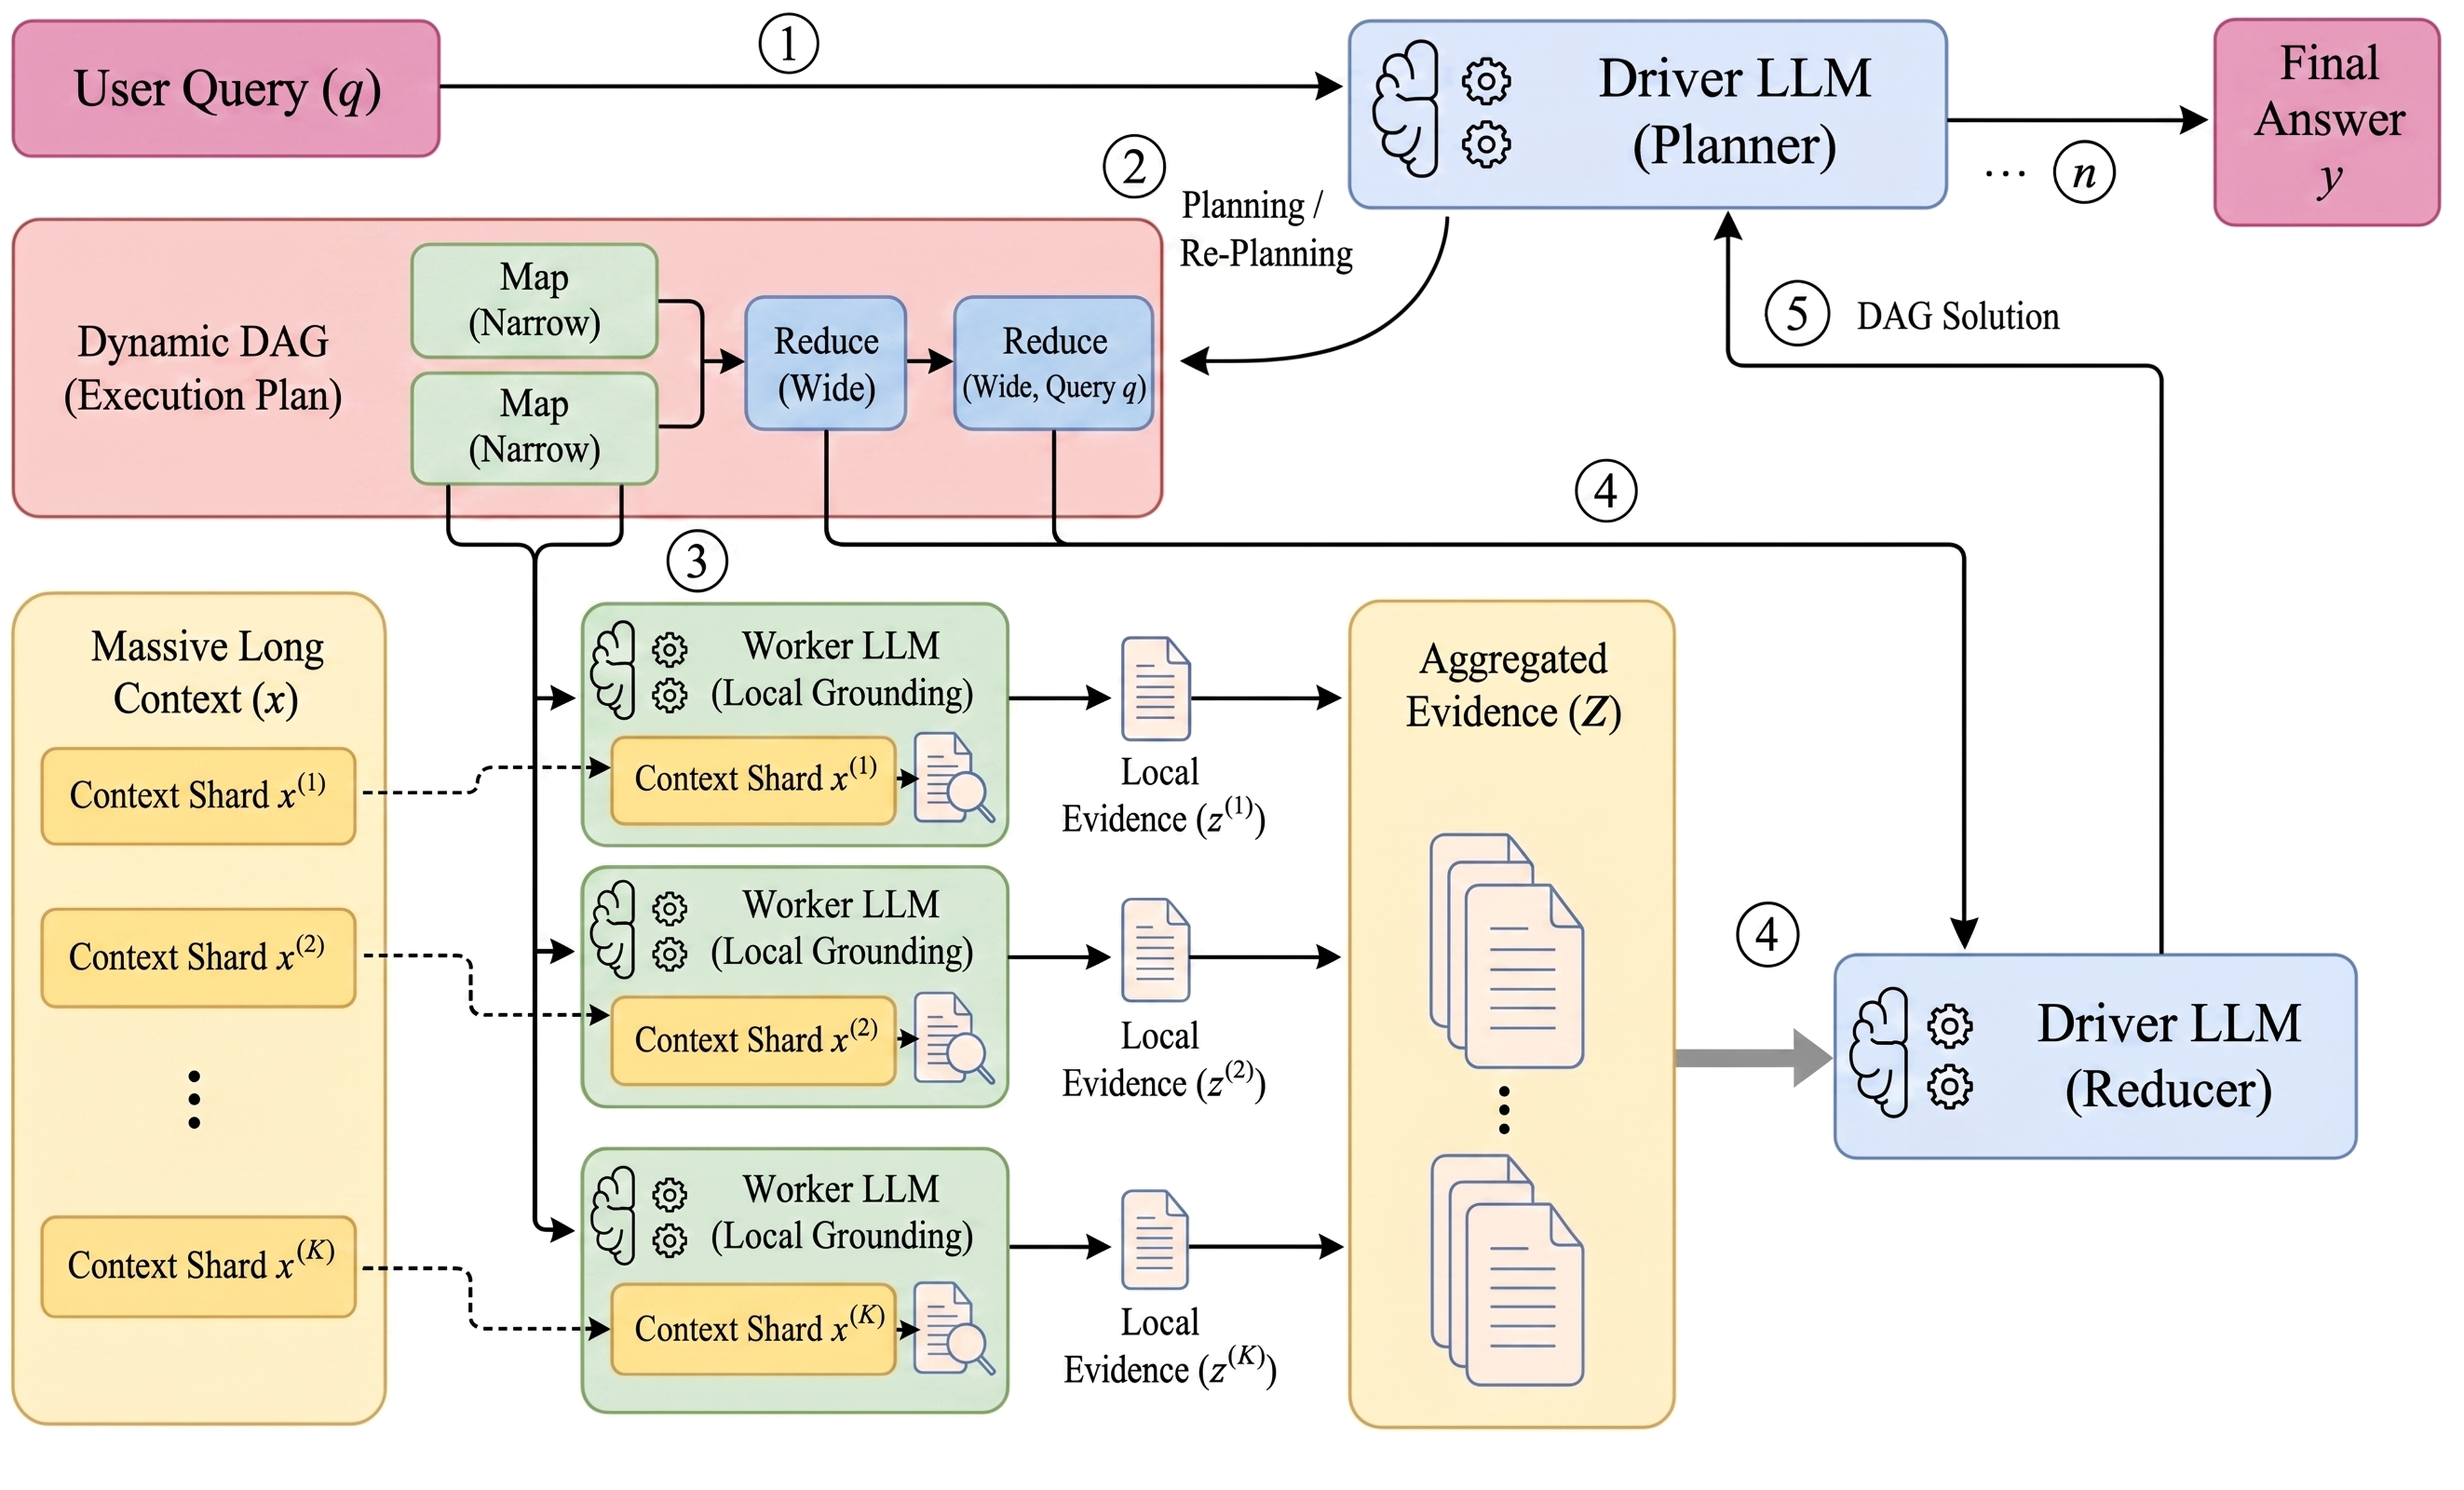
Система делит исходный текст на непересекающиеся фрагменты и закрепляет каждый за небольшой моделью-исполнителем. Исполнитель хранит свой фрагмент и получает узкие задания: найти дату, упоминание сущности, условие договора или другой конкретный факт. Ему не поручают выводы, которые требуют сопоставить несколько частей документа.
Управляющая модель не видит исходный текст. Она превращает вопрос в граф задач без циклических зависимостей: независимые поисковые операции запускаются параллельно, а последующие узлы объединяют найденные свидетельства. Если данных не хватает, модель уточняет план и отправляет исполнителям новые задания.
Такое устройство защищает рассуждение от лишнего текста. С ростом корпуса система добавляет параллельные операции над фрагментами, а не загружает весь объём в окно самой дорогой модели. В отличие от обычного поиска по сходству, исполнители читают текст как LLM и могут извлечь факт, который не совпадает с формулировкой вопроса.
Управляющую модель дополнительно обучают методом GRPO. Награда учитывает правильность ответа, связь ответа с найденными свидетельствами и корректность графа. Итоговый результат влияет и на промежуточные шаги, поэтому модель учится составлять планы, которые не требуют лишних повторов.
Параллельное чтение удержало качество на самых длинных заданиях
На самом длинном варианте RULER-QA базовая DISCO получила 78,4% правильных ответов, а стандартный RAG — 10,9%. Этот тест искусственно распределяет связанные факты по большому контексту, поэтому он проверяет не только поиск отдельного фрагмента, но и рассуждение по нескольким свидетельствам.
На длинной части LongBench v2 система с Qwen3-14B обошла передачу полного контекста той же модели на 9,8 процентного пункта. Обучение управляющей модели с подкреплением дополнительно улучшило результаты на LongBench v2 и ∞Bench, но не оказалось универсально полезным: на самом длинном задании RULER-QA вариант без него ответил точнее.
Работу проверяли на LongBench v2, RULER-QA и ∞Bench. Первый набор включает вопросы по длинным документам, второй создаёт контролируемые многошаговые задачи, третий проверяет ответы по книгам и выбор варианта. Управляющими моделями служили Qwen3-8B, Qwen3-14B и Gemini-3-Pro-Preview, а основным исполнителем — Qwen3-4B с фрагментами по 4096 токенов.
Задержку измеряли при фиксированном пуле из 8 GPU H100: половину выделили управляющей модели, половину — параллельным исполнителям. Поэтому вывод о масштабировании относится к системе с доступной параллельной инфраструктурой, а не к последовательному запуску всех ролей на одном ускорителе.
Командам стоит проектировать конвейер, а не выбирать окно по паспорту
Работа меняет планы продуктов, где один запрос требует прочитать большой корпус и связать факты из разных его частей. К таким сценариям относятся анализ архивов, технической документации, договоров и истории операций. Здесь заявленный размер окна модели сам по себе не гарантирует, что она найдёт нужные свидетельства и сохранит способность рассуждать.
Архитектурное решение состоит не в том, чтобы заменить одну большую модель множеством одинаковых агентов. Небольшие исполнители должны получать атомарные задания и возвращать свидетельства с привязкой к своим фрагментам. Управляющей модели нужны план, история выполнения и компактный набор фактов, но не исходный корпус.
Эксперименты также подсказывают, куда направлять вычислительный бюджет. Увеличение управляющей модели дало больший прирост точности, чем увеличение исполнителей. Более крупные исполнители сокращали число повторных поисков, но не обеспечивали сопоставимого роста качества, поэтому начинать имеет смысл с сильной модели для планирования и дешёвых моделей для локального чтения.
Для пилота важны три прикладные метрики: сколько нужных фактов теряется при извлечении, сколько раз управляющая модель перестраивает план и во сколько обходится готовый ответ с учётом параллельных запусков. Если основная ошибка возникает уже на локальном поиске, увеличение центральной модели её не исправит. Если свидетельства найдены, но вывод неверен, дополнительные ресурсы стоит отдавать управляющей модели или её обучению.
Источники
Иллюстрация: рисунок из статьи «DISCO: Distributed Long Context Scaling with Grounding-Reasoning Disaggregation», Guanzheng Chen, Viet Dac Lai, Subhojyoti Mukherjee и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


