Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Знание, которое LLM выучила на одном языке, может остаться недоступным на другом из-за того, как текст представлен в словаре модели. Adam Gaber, Uriel Dolev, Elisabeth Fittschen и их соавторы улучшили межъязыковой перенос до 14 раз, объединив токенные пространства языков. Хотя препринт не рецензирован и числа получили сами авторы, результат предлагает пересмотреть устройство словаря при обучении многоязычных моделей с нуля.
Как отделили влияние языка от влияния токенов
Обычный корпус не позволяет точно установить, на каком языке модель встретила конкретный факт и сколько раз его повторили. Поэтому в обучение добавили 2048 вымышленных фактов о придуманных организациях и людях. Для каждого подготовили разные формулировки на нескольких языках, а затем проверили знание отдельными вопросами с вариантами ответа.
Перенос измеряли показателем CLeq. Он сравнивает пользу от встречи с фактом на другом языке с пользой от той же встречи на языке вопроса. Так рост общей языковой способности не маскируется под перенос знаний: если модель просто стала лучше читать арабский, но не использует факты из английской части корпуса, CLeq не вырастет.
Чтобы убрать различия в грамматике, письменности и содержании корпусов, исследователи создали две копии английского. Тексты и разбиение на токены остались одинаковыми, но каждой копии назначили отдельные идентификаторы словаря. Модель получала две одинаковые последовательности, которые различались только номерами токенов.
Модели обучали с нуля в масштабах 360 млн и 7 млрд параметров. Помимо искусственной пары английского проверяли английский с арабским и русским; арабский корпус был машинным переводом английского, а русский состоял из исходных веб-текстов. Эксперименты охватывают двуязычное предобучение и сравнительно простые факты вида «сущность — свойство», а не диалоги или составные рассуждения.
Одинаковая структура не связывает знания автоматически
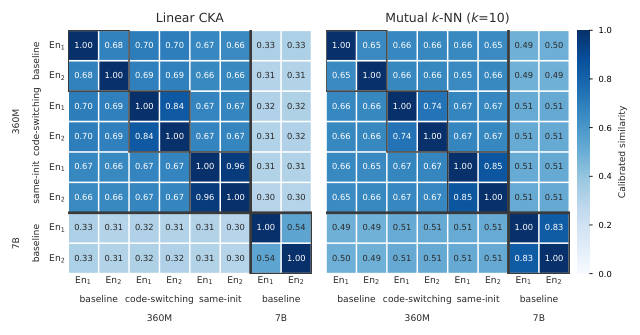
Две копии английского почти не переносили факты между собой, хотя читали структурно одинаковые данные. Их векторные пространства получились похожими по форме, но модель не сопоставила соответствующие токены. Она независимо выучила две версии одной закономерности вместо общей версии.
Даже одинаковые начальные векторные представления не решили задачу полностью: в ходе обучения соответствующие токены расходились. Значит, стандартное предобучение не только не создаёт связь между раздельными пространствами, но и ослабляет уже заданное соответствие, если архитектура не удерживает его явно.
Эффект оказался пороговым. Когда совместно обучали половину компонентов у соответствующих токенов, CLeq поднялся до 82,7%; при меньшей доле связи перенос оставался слабым. Случайное объединение идентификаторов тоже не помогало: общие токены должны обозначать близкие по смыслу элементы.
Для естественных языков применили пословное преобразование WWT. Оно заменяет каждое слово его словарным соответствием в английском токенном пространстве, а незнакомые слова обратимо транслитерирует. В английско-арабской паре CLeq вырос с 0,9% до 12,6%, при этом модель также стала лучше предсказывать следующий токен в обычном тексте.
Что меняется в планах многоязычных команд
Работа меняет планы прежде всего для команд, которые предобучают собственную базовую модель. Токенизатор здесь стоит рассматривать не только как средство сжатия текста: от распределения идентификаторов зависит, сможет ли модель использовать факт за пределами языка, на котором его встретила.
Формально общий словарь ещё не означает общее пространство знаний. Если разные письменности занимают почти непересекающиеся части словаря, модель может построить отдельные представления даже внутри одной архитектуры. При проектировании корпуса и токенизатора стоит измерять не только качество каждого языка, но и пользу, которую факт на одном языке приносит ответу на другом.
WWT пока выглядит скорее проверкой механизма, чем готовой заменой обычного токенизатора. Преобразование сохраняет порядок слов и грамматику исходного языка, но увеличивает длину последовательностей, а значит, повышает стоимость вывода. Кроме того, эксперимент объединял по два языка и не показывает, сколько языков можно поместить в одно пространство без взаимных помех.
Для продуктов поверх чужого API вывод превращается в критерий оценки поставщика, а не в немедленную смену архитектуры. Высокое качество ответов на каждом языке отдельно не доказывает, что модель переносит между ними внутренние знания. Это особенно существенно, если документы поступают на одном языке, а пользователи задают вопросы на другом.
Главный практический сдвиг состоит в месте проверки: межъязыковой перенос нужно тестировать уже во время предобучения. Последующая настройка инструкциями может улучшить ответы, но работа показывает, что исходное разделение знаний возникает раньше — на уровне того, какими токенами модель видит языки.
Источники
Иллюстрация: рисунок из статьи «Why Pretraining Fails to Share Cross-Lingual Knowledge», Adam Gaber, Uriel Dolev, Elisabeth Fittschen и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.