
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
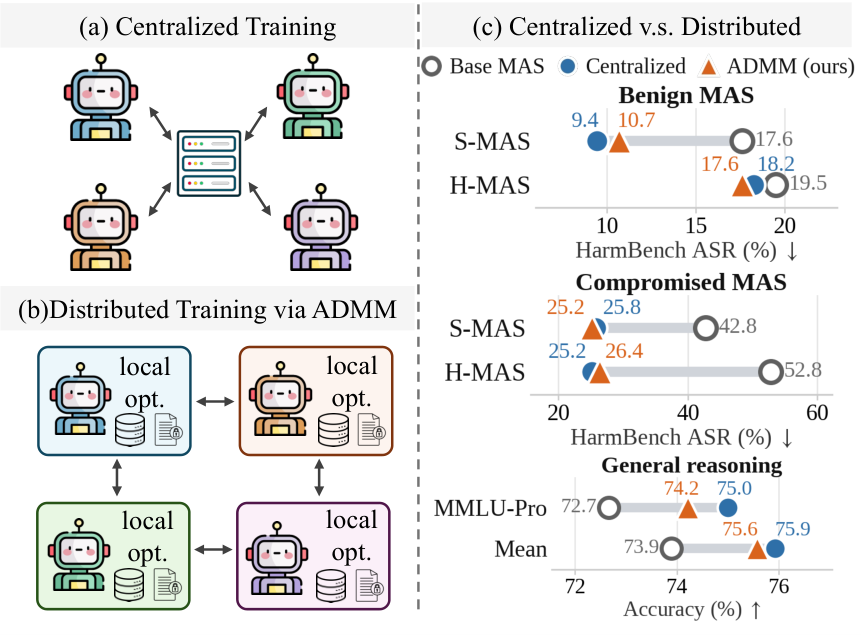
Мультиагентную систему научили совместно обучаться без центрального процесса, который собирает истории действий, сигналы обучения и состояния оптимизаторов. В препринте Michigan State University и University of Michigan, который не рецензировали и где числа получили сами авторы, такой подход снизил долю успешных атак HarmBench максимум на 26,4 процентного пункта и приблизился по качеству рассуждений к централизованному обучению.
Для команд это вариант архитектуры, в которой роли работают на разных устройствах или в разных организациях, но всё же улучшают общую модель. Локальными остаются данные и состояние обучения, однако узлы обмениваются параметрами.
Согласование заменяет центральный тренер
При централизованной схеме один процесс видит траектории всех агентов, рассчитывает обновления и хранит общее состояние оптимизатора. Это упрощает координацию ролей, но требует собрать учебную информацию в одном месте. Независимое обучение решает проблему централизации, однако каждый агент тогда улучшает собственный результат без гарантии, что вся система станет работать лучше.
Авторы представили обучение как сумму локальных задач с условием согласованности. У каждого агента есть копия общей модели, свой набор траекторий и целевая функция, связанная с его ролью. При этом копии должны сходиться к одним параметрам.
Для согласования применили метод переменных направлений множителей (ADMM). Обучение чередует два шага: сначала каждый узел обновляет модель по локальным данным, затем узлы сближают полученные параметры. Дополнительная поправка запоминает накопившееся расхождение между копиями, поэтому процесс не сводится к периодическому усреднению весов.
Точное согласование выполняет кольцевой коллективный обмен: узлы передают части параметров по кругу и совместно вычисляют итоговое значение. Есть и приближённый режим, в котором каждый участник обменивается данными только с соседями. Во всех вариантах траектории, обучающие сигналы и состояние оптимизатора не покидают узел.
Безопасность сохранилась при испорченном звене
Метод проверяли на общей модели Qwen3-8B в двух конфигурациях. В последовательной системе роли решали задачу, проверяли ответ, исправляли его и принимали окончательное решение. В иерархической несколько анализаторов передавали результаты одному синтезатору.
Эксперименты охватывали настройку безопасности и обычные задачи на рассуждение. Качество оценивали по MMLU-Pro и среднему результату на шести наборах задач. Безопасность измеряли через HarmBench: метрика показывает, в какой доле случаев вредоносный запрос успешно обходит защиту.
В основном сценарии все агенты были настроены на безопасное поведение. В более жёстком варианте один участник оставался скомпрометированным: в последовательной схеме это был первый решающий агент, а в иерархической — синтезатор, который формировал общий ответ. Именно в таких условиях распределённое обучение уменьшило долю успешных атак максимум на 26,4 процентного пункта относительно исходной системы.
На задачах рассуждения ADMM приблизился к результату общего тренера, но не превзошёл его с заявленным устойчивым отрывом. Два упрощения сработали хуже: обучение ролей без согласования и обычное периодическое усреднение параметров не воспроизвели полный результат. Значит, выигрыш связан не только с обменом весами, но и с тем, как метод учитывает прежние расхождения между локальными обновлениями.
Когда схема меняет архитектурный план
Работа влияет на планы команд, которым нельзя передавать локальные траектории и состояние обучения общему тренеру. Вместо единого контура можно разместить узел рядом с каждым источником данных и согласовывать копии модели. Это подходит для системы, где роли разделены между устройствами, подразделениями или организациями.
При этом ADMM не устраняет передачу модельных параметров. Если ограничения запрещают обмен не только данными, но и весами, предложенная схема проблему не решает. Она также рассчитана на локальные копии одной общей модели, поэтому результаты нельзя напрямую переносить на систему, где каждая роль использует отдельную модель или собственную архитектуру.
Для агентов, которые уже обучаются в одном вычислительном контуре, работа не показывает причины отказываться от центрального тренера ради качества. Распределённая схема достигает сопоставимого результата, но добавляет локальные состояния, раунды согласования и обмен параметрами. Её преимущество проявляется там, где границы хранения данных важнее простоты учебного контура.
Практическая проверка должна воспроизводить отказ, ради которого выбирают такую архитектуру. Для системы безопасности это агент без защитной настройки; для распределённого продукта — узел с локальными данными и ограниченным каналом связи. Сравнивать стоит не только итоговую точность, но и долю успешных атак, время согласования и объём передаваемых параметров.
Главный результат работы — не новый способ распределить вычисления одной модели, а способ разделить обучение по функциональным ролям. Каждый агент учится на собственном участке процесса, а система сохраняет общую цель без хранилища всех учебных данных в одном месте.
Источники
Иллюстрация: рисунок из статьи «Train Locally, Learn Together: Distributed Multi-Agent Training via ADMM», Yiwei Chen, Changsheng Wang, Yicheng Lang и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


