
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Многошаговых агентов научились быстрее обучать на ответах большой модели-учителя без новой функции потерь и изменений оптимизатора. В работе University of Chicago, Meituan LongCat Interaction Team и партнёров метод DivOPD поднял среднюю лучшую долю успешно завершённых задач с 77,4% до 84,4% и ускорил достижение заданного качества в 1,87 раза по времени GPU обучающего процесса, хотя препринт не рецензирован и все числа получили сами авторы. Это превращает сборку пакета из системной детали в отдельную часть алгоритма обучения.
Почему очередь теряет уже собранный опыт
При дистилляции на собственных траекториях (on-policy distillation) модель-ученик действует в среде, а замороженная модель-учитель оценивает её ответы в состояниях, куда она действительно попала. Так ученик разбирает собственные ошибки, а не только повторяет заранее записанные правильные последовательности.
В асинхронной системе генераторы продолжают строить траектории, пока отдельный процесс обновляет модель. Траектории отличаются по длине и скорости: агент может ждать инструмент, сделать несколько коротких действий или надолго застрять на одной задаче. Между генерацией и обучением версия модели меняется, поэтому слишком старые шаги приходится удалять.
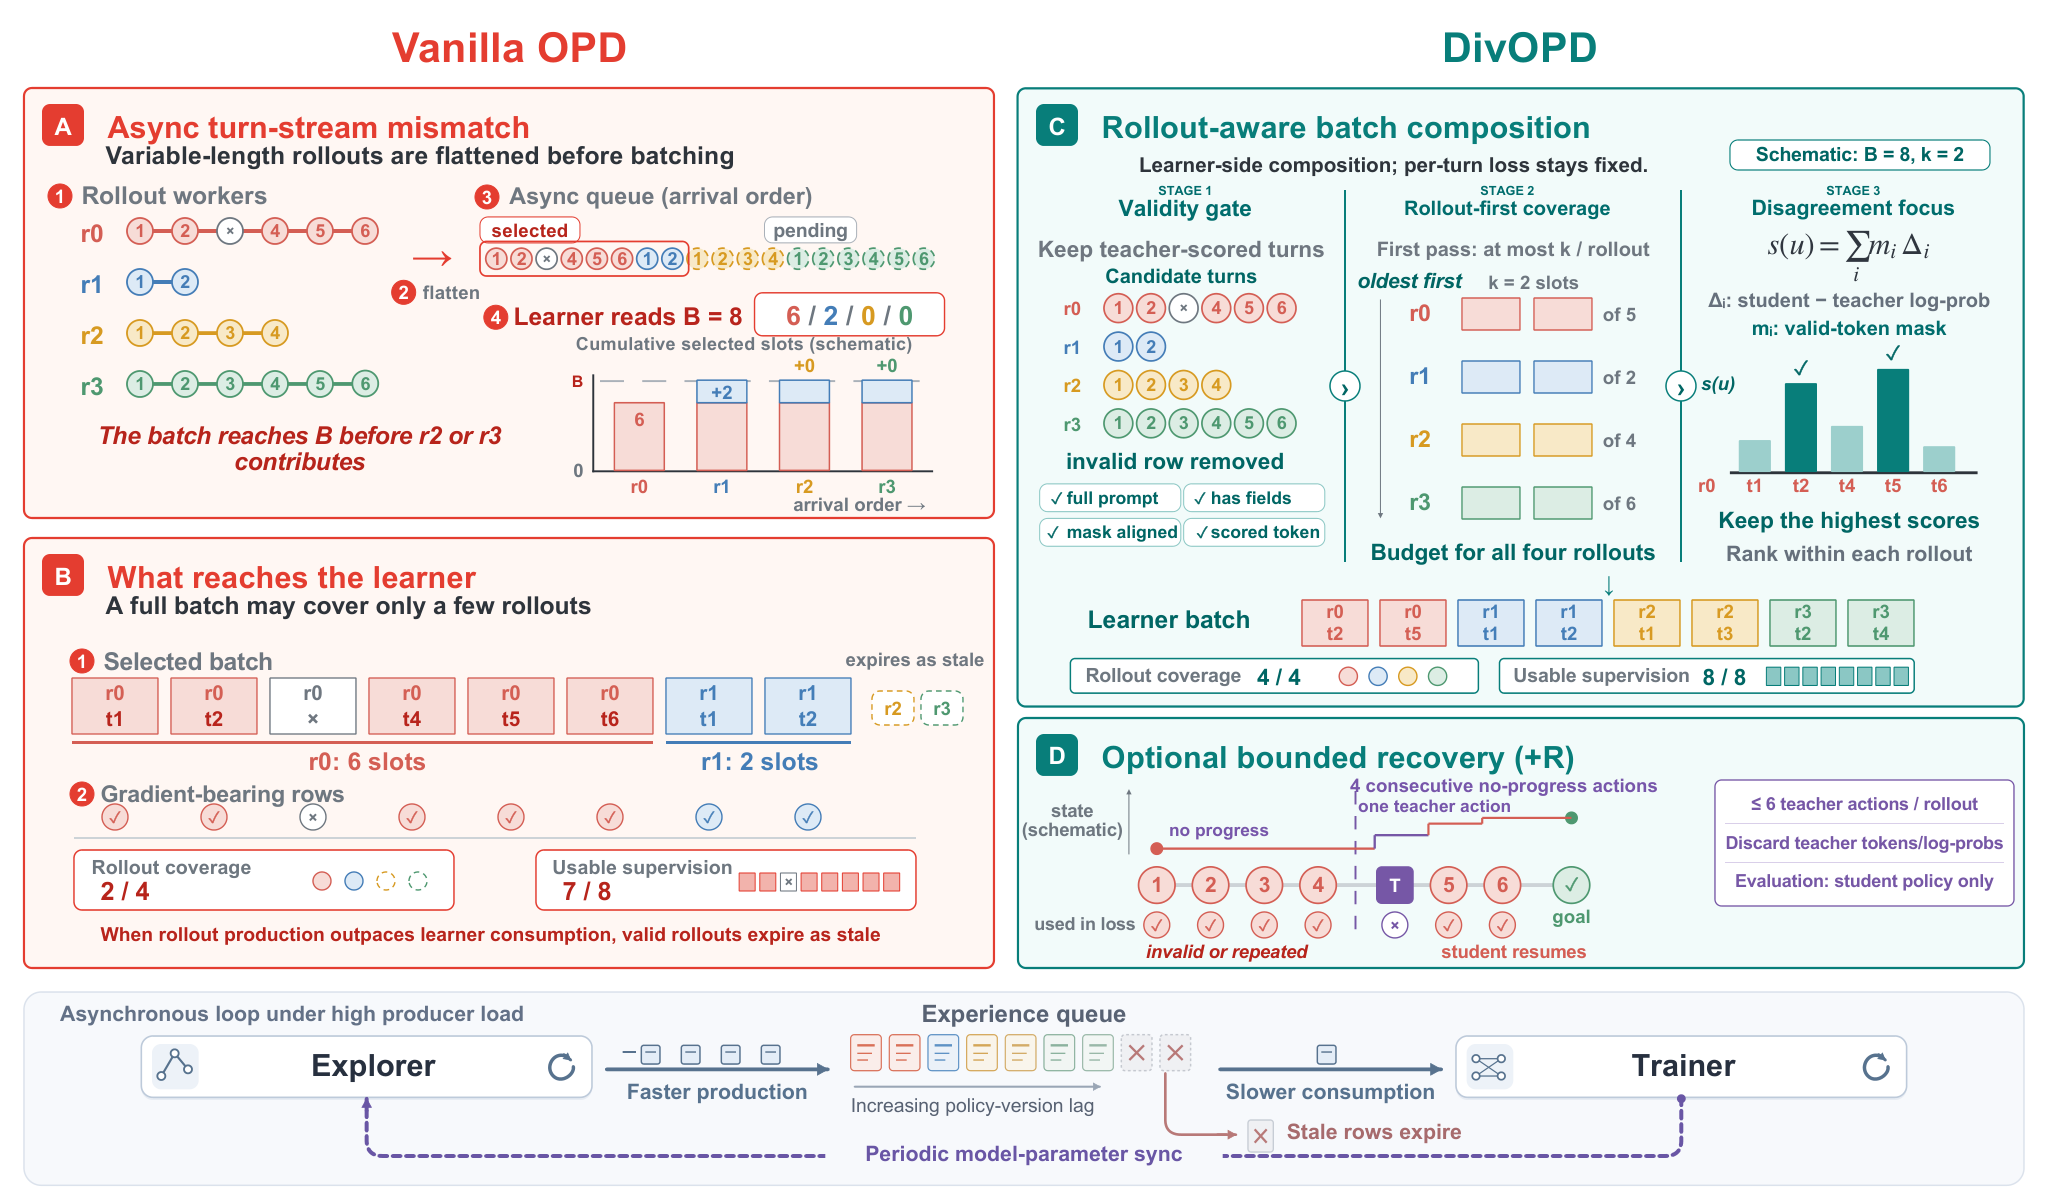
Обычная реализация разворачивает траектории в плоскую очередь и заполняет пакет в порядке поступления. Ранняя или длинная траектория занимает значительную часть мест, а более поздние успевают устареть. В повторном разборе общих буферов от 49% до 59% пригодных траекторий не попали ни в одно обновление.
Часть мест также занимают строки, для которых нет пригодной оценки учителя: например, контекст был обрезан и оцениваемых токенов не осталось. Такая строка не даёт градиента, но в исходной схеме всё равно входит в размер пакета. В результате команда платит за действия агента и оценку учителя, а обучающий процесс этот опыт не использует.
Как DivOPD распределяет бюджет между траекториями
DivOPD меняет только чтение очереди. Сначала он отбрасывает шаги без полного контекста, оценок учителя или корректной маски токенов. Если пригодных данных достаточно, все места в пакете получают строки, которые действительно участвуют в расчёте ошибки.
Затем метод группирует шаги по траекториям и сначала обходит те группы, которые дольше ждут. На первом проходе каждая траектория может занять лишь ограниченную часть пакета. Если свободные места остаются, метод делает дополнительные проходы и постепенно снимает ограничение.
Такой порядок не запрещает длинным траекториям участвовать в обучении. Он не даёт одной из них вытеснить остальные до того, как их данные устареют. Неиспользованные шаги остаются в очереди и могут попасть в следующее обновление.
Внутри каждой траектории DivOPD выбирает шаги по накопленному расхождению между вероятностями учителя и ученика. Сигнал учитывает как среднее расхождение, так и число оценённых токенов. Метод берёт уже сохранённые вероятности, поэтому ему не нужен дополнительный запуск модели.
Функция потерь, оптимизатор и способ генерации траекторий остаются прежними. Меняется состав данных, по которым считают обновление, а значит, меняется и фактический вес разных состояний агента. Дополнительный вариант DivOPD+R вмешивается глубже: если ученик долго не продвигается, учитель ненадолго берёт управление, после чего возвращает его ученику; действия учителя в ошибку обучения не входят.
Меняет ли работа планы команд, которые обучают агентов
Проверка охватывает шесть сочетаний учителя и ученика семейства Qwen на симуляторах ALFWorld, ScienceWorld и WebShop. Студентов разных размеров сравнивали с обычной дистилляцией, TCOD-F2B и TurnOPD в одной асинхронной схеме. Результаты относятся к симулированным средам с замороженными учителями, а не к открытым продуктовым сценариям.
Улучшился не только лучший контрольный результат. Средняя доля успеха по последним пяти проверкам выросла с 71,5% до 78,6%, то есть эффект сохранился к концу обучения, а не появился в одном удачном контрольном замере.
Для существующей асинхронной инфраструктуры DivOPD выглядит как локальная переделка загрузчика данных. Потребуются идентификаторы траекторий, версия модели для каждого шага, срок пригодности данных и сохранённые вероятности учителя и ученика. Если эти поля уже есть, менять генераторы, функцию потерь и оптимизатор не придётся.
Перед внедрением стоит измерить, сколько траекторий представлено в одном пакете, какую долю занимает крупнейшая из них, сколько строк не дают градиента и сколько пригодных траекторий устаревает без обучения. Если очередь не перегружена или обучение синхронное, основной механизм DivOPD устраняет проблему, которой в системе может не быть.
Экономию GPU обучающего процесса нельзя напрямую переносить на полный бюджет платформы. Среднее ускорение по времени всего цикла с чтением опыта составило 1,14 раза, а в WebShop выигрыша по этому показателю не было. Затраты на генерацию траекторий, работу учителя и инструменты могут оставить итоговую стоимость почти прежней, поэтому сначала имеет смысл заменить сборщик пакетов и проверить систему на собственном профиле очереди.
Источники
Иллюстрация: рисунок из статьи «DivOPD: Spread Wide, Look Close for Asynchronous On-Policy Distillation of Multi-turn Agents», Hanyang Wang, Zeyuan Liu, Zhengyu Chen и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


