
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Оптимальную скорость обучения для большой модели с дифференциальной приватностью научились подбирать на её уменьшенной копии. В препринте Rutgers University и независимого исследователя, который не рецензировали, приведены замеры самих авторов: настройка перенеслась на GPT-2 примерно в десять раз крупнее. Команда может вынести перебор скорости обучения из дорогого целевого запуска в серию экспериментов на компактной модели.
Почему обычный μP ломается от приватного шума
Максимальная параметризация обновления (Maximal Update Parametrization), или μP, помогает переносить гиперпараметры между моделями разной ширины. Она задаёт инициализацию весов и скорость обучения по слоям так, чтобы при расширении сети сохранялись масштабы активаций и обновлений.
В обычном обучении этого достаточно: оптимальная скорость, найденная на узкой модели, остаётся подходящей для широкой. Дифференциальная приватность меняет структуру обновления. Перед шагом оптимизатора система ограничивает градиент каждого примера, а затем добавляет гауссов шум, чтобы отдельную запись нельзя было надёжно распознать по результату обучения.
Полезный градиент отдельного примера имеет низкий ранг: он меняет веса в небольшом числе согласованных направлений. Приватный шум заполняет всю матрицу весов. По мере роста ширины его спектральная норма — наибольшее растяжение в каком-либо направлении — растёт иначе, чем норма полезного сигнала.
Обычный μP учитывает общий размер обновления. Когда в нём преобладает шум, система уменьшает скорость обучения достаточно, чтобы стабилизировать веса, но одновременно подавляет полезную часть градиента. В широких слоях вклад сигнала убывает обратно пропорционально ширине, поэтому кривые обучения узкой и широкой моделей расходятся.
Как DP-μP сохраняет сигнал в каждом слое
DP-μP вводит второе условие переноса. Помимо одинакового масштаба обновлений, прокси-модель и целевая модель должны сохранять по слоям одно и то же отношение приватного шума к полезному сигналу. Одной корректировки скорости обучения для этого недостаточно: она умножает обе части на один коэффициент и не меняет их отношение.
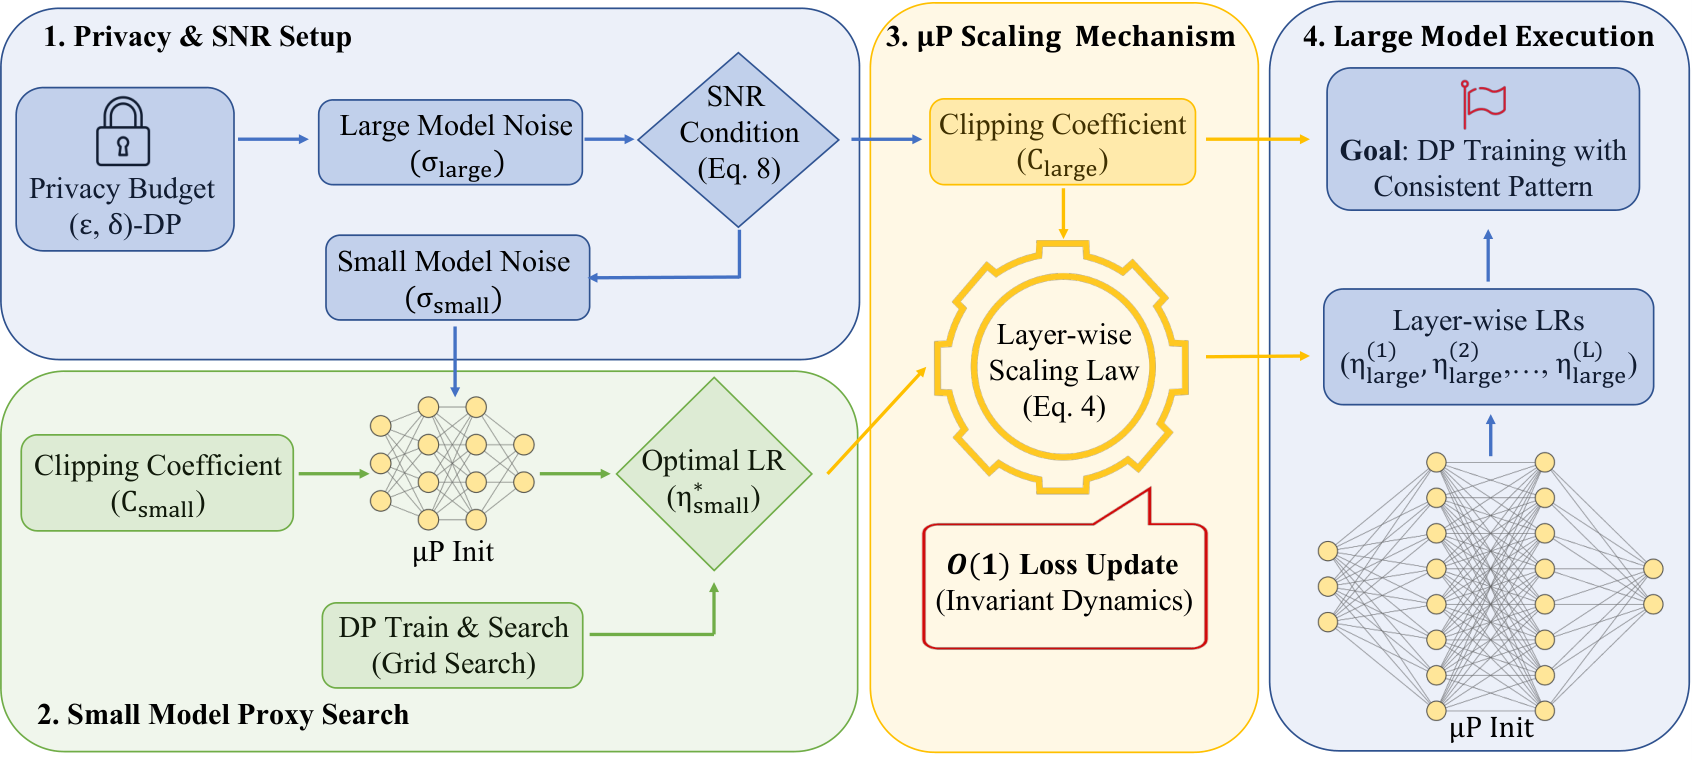
Сначала команда задаёт уровень шума для целевой модели исходя из требований к приватности. Затем DP-μP рассчитывает шум и коэффициенты ограничения градиента для каждого слоя уменьшенной модели. Расчёт учитывает ширину входа и выхода слоя, размер пакета и уровень приватного шума.
После выравнивания отношения сигнала к шуму на прокси-модели перебирают базовую скорость обучения. Найденное значение переносят на целевую модель, а правила DP-μP преобразуют его в отдельные скорости для слоёв. Работа выводит такие правила для DP-SGD, DP-Adam и DP-Muon.
Отдельные коэффициенты особенно нужны входному и выходному слоям. Их размеры часто определяет формат данных или словарь, поэтому они не расширяются вместе со скрытыми слоями. Один общий коэффициент ограничения градиента не смог бы одновременно выровнять их с внутренними слоями.
Метод проверили на многослойных перцептронах, ViT и GPT-2: для изображений использовали CIFAR-10 и CIFAR-100, для генерации текста — Shakespeare Character. Перенос работал с тремя оптимизаторами, а итоговое качество соответствовало моделям, для которых скорость обучения подбирали отдельно, либо превосходило их.
В опыте с GPT-2 скорость подобрали на прокси с 76,0 млн параметров и перенесли на целевую модель с 787,8 млн. Расчётные затраты на поиск снизились на 90,35%, а один запуск на NVIDIA A100 вместо примерно 30 минут занимал 11 минут. Это экономия именно на переборе настроек, а не на полном обучении целевой модели.
Когда DP-μP стоит закладывать в план обучения
Работа меняет план проекта, если модель обучают с дифференциальной приватностью, её ширина ещё растёт, а скорость обучения приходится подбирать на целевой конфигурации. В таком случае прокси становится не приблизительным стендом, а частью заранее рассчитанной схемы переноса.
DP-μP нельзя добавить только заменой значения скорости обучения. Понадобятся μP-инициализация, автоматическое послойное ограничение градиентов, отдельные коэффициенты для слоёв и проверка масштаба активаций при изменении ширины. Авторы используют координатную проверку: следят, чтобы выбранные компоненты активаций оставались одного масштаба на узких и широких моделях.
Проверка охватывает перенос по ширине и размеру пакета. При переносе между пакетами уровень шума меняли пропорционально размеру пакета и сравнивали обучение после одинакового числа шагов, а не эпох.
Границы применения следуют из самой постановки. DP-μP рассчитан на режим, где приватный шум сильнее градиентного сигнала; переходную область с сопоставимыми величинами не исследовали. Масштабирование по глубине тоже не входит в метод: с добавлением слоёв шум накапливается, и послойное отношение сигнала к шуму перестаёт сохраняться по выведенным правилам.
Источники
Иллюстрация: рисунок из статьи «Towards Hyperparameter Transfer for Differentially Private Optimization», Tianze Wang, Zhiqi Bu, Linjun Zhang, CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


