
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Зрительно-языковую модель научили отвечать сразу на простые задания и включать пошаговое рассуждение только на сложных, без отдельного маршрутизатора. В работе группы из университетов Гонконга и CISPA, которая не прошла рецензирование и где числа получили сами авторы, DR-BOLT ускорил полный цикл обучения в 2,90 раза по сравнению с воспроизведённым GRPO. Метод предлагает заменить повторную генерацию ответов во время обучения заранее собранным банком, если у команды уже есть быстрый и рассуждающий режимы.
Почему один эталон ломает выбор режима
При автономном обучении модель не создаёт новые ответы на каждом шаге. Команда заранее собирает варианты, оценивает их правильность, формат и длину, а затем учит модель чаще воспроизводить удачные варианты. Это снижает затраты на генерацию и проверку во время обучения.
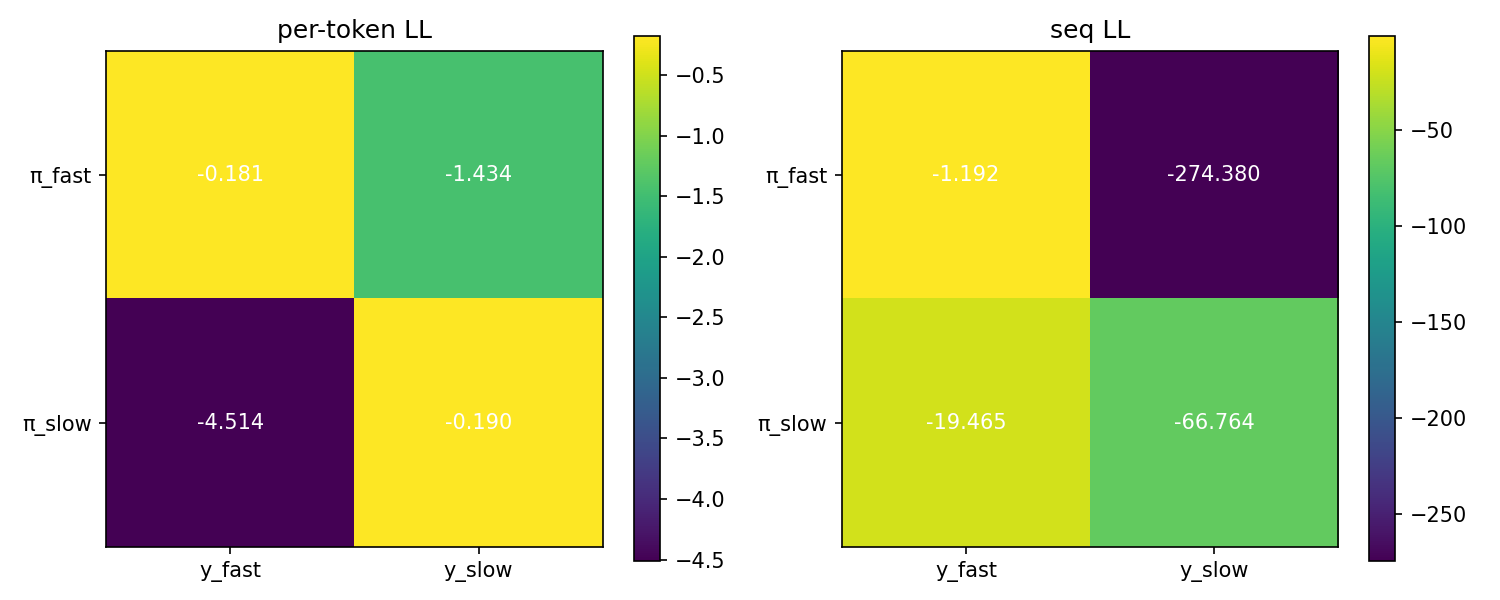
Проблема возникает, когда короткие и подробные ответы создали разные модели-источники. Быстрая модель считает длинное рассуждение маловероятным, а рассуждающая — может так же оценить прямой ответ. Если использовать одну из них как общий эталон, алгоритм систематически уменьшит вес второго режима, даже когда тот дал правильный результат.
DR-BOLT разделяет два распределения. Первое задаёт желаемую смесь быстрых и медленных ответов, второе описывает фактический банк кандидатов. В основном опыте быстрые ответы составляли долю 0,7, тогда как целевой вес быстрого режима равнялся 0,5. Поправка компенсирует этот перекос: ответы из перепредставленного источника получают меньший вес, из недопредставленного — больший.
После этого награда решает, какой режим полезнее для конкретного задания. Она учитывает правильность, соблюдение формата и длину ответа. Если оба режима отвечают верно, короткий получает преимущество; если прямой ответ ошибочен, награда за подробное рассуждение перекрывает штраф за длину.
Отдельный классификатор сложности не нужен. При обучении конкурируют суммарные веса быстрых и медленных кандидатов, а единый контрольный снимок модели усваивает этот выбор вместе с генерацией ответа. На практике точную поправку можно заменить коэффициентом по известному источнику ответа, пока короткие и рассуждающие форматы хорошо разделены.
Ошибка в поправке почти отключает рассуждение
Сравнения проводили на одинаковых банках кандидатов, с общей инициализацией, наградой и бюджетом обучения. На ScienceQA, MathVision, DynaMath и MMMU-Pro DR-BOLT одновременно показал более высокий результат и более короткие ответы, чем проверенные автономные альтернативы MR-DPO и обучение с весами по награде.
Цена пропущенной поправки видна в выборе режима. На банке ViRL39K доля ответов с рассуждением упала с 24,1% до 0,13%: алгоритм принял состав обучающего банка за желаемое поведение и почти всегда выбирал краткий ответ.
Упрощённая поправка по источнику близко повторила точный расчёт: максимальная разница результата в этих запусках составила 0,017. Это позволяет не вычислять вероятность каждого ответа сразу под обеими моделями-источниками, если форматы действительно различаются.
На ScienceQA средний ответ DR-BOLT занимал 20,4 слова, тогда как воспроизведённый GRPO завершил обучение с длиной выше 200 слов. GRPO здесь означает обучение, при котором модель многократно создаёт новые ответы и обновляется по их награде. DR-BOLT заранее генерирует и оценивает банк, поэтому не повторяет этот цикл на каждом обновлении.
Когда DR-BOLT меняет план разработки
Работа меняет план, если продукт уже разделяет прямые ответы и подробные рассуждения или может получить их от двух контрольных снимков. Вместо отдельного маршрутизатора и последующего соединения двух моделей можно собрать общий банк, сохранить источник каждого ответа и обучить один контрольный снимок с поправкой на состав банка.
Главная инженерная деталь — не соотношение режимов само по себе, а различие между тем, как банк собрали, и тем, какое поведение требуется в продукте. Если команда увеличила число дешёвых коротких кандидатов ради скорости подготовки данных, это не должно автоматически превращаться в предпочтение коротких ответов после обучения.
Метод особенно естественен для задач с проверяемым итогом: научных вопросов, математики и других сценариев, где можно отдельно оценить правильность и стоимость ответа. Для субъективных ответов понадобится надёжная модель-оценщик, а её ошибки попадут в веса кандидатов.
Проверка охватывает Qwen3-VL, обучение на ScienceQA и ViRL39K и перенос на три набора мультимодальных задач. Переносные наборы не использовали для отдельной настройки, но их типы заданий пересекаются с обучающими, а полный аудит пересечений источников не проводили, поэтому работа не доказывает устойчивость к произвольным новым областям.
Ещё одна граница — заранее собранный и замороженный банк. DR-BOLT не обновляет кандидатов по мере изменения модели. Такой подход сокращает вычисления, но подходит прежде всего там, где два источника уже дают достаточно разнообразные и качественные ответы, а их форматы можно уверенно различить.
Источники
Иллюстрация: рисунок из статьи «Learning When to Think: Dual-Reference Offline Optimization for Adaptive VLM Reasoning», Hongbin Lin, Sizhe Zou, Juangui Xu и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


