
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
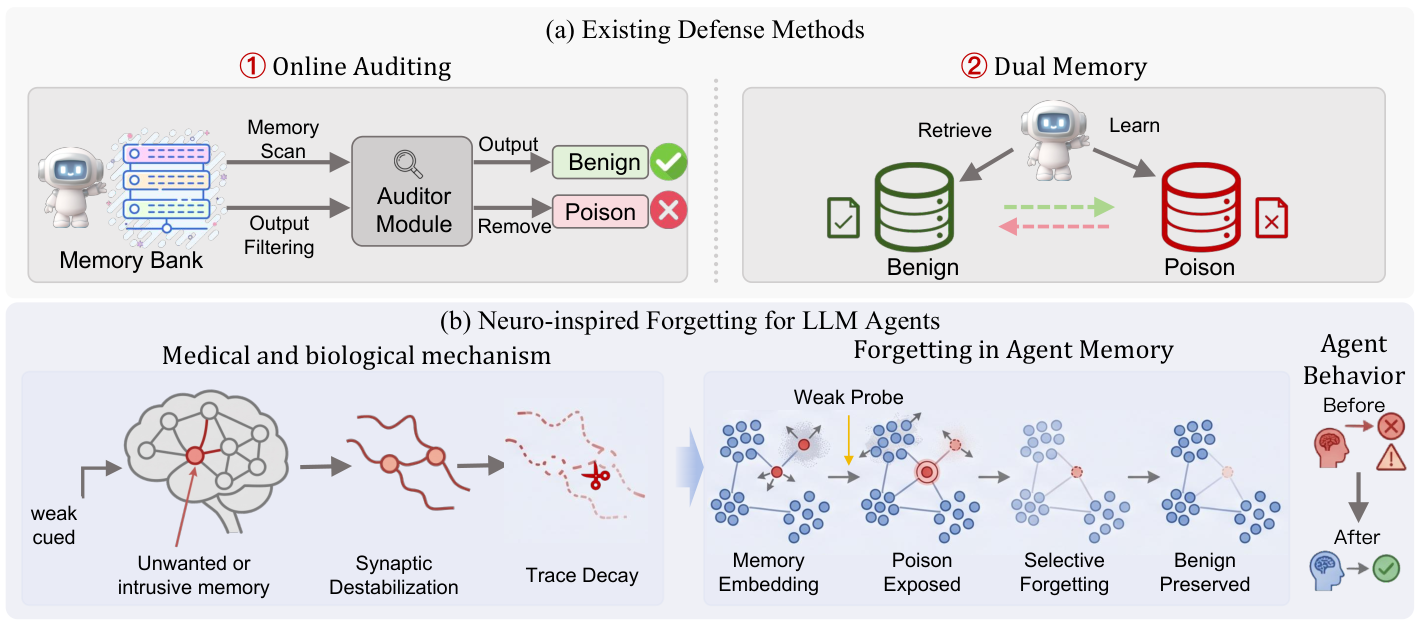
Отравленные записи в памяти LLM-агента можно подавлять, не удаляя их и не проверяя каждый ответ внешней моделью. В препринте, который не проходил рецензирование и где числа получили сами авторы, DREAM снизил успешность атак с бэкдором более чем на 95%. Такой подход сокращает расходы на защиту агентов, которые накапливают опыт и повторно используют его в следующих задачах.
DREAM работает без дообучения и обрабатывает память в три этапа. Сначала система добавляет небольшой случайный шум к векторным представлениям записей: вредоносные элементы чаще теряют устойчивость. Затем она оценивает геометрическую стабильность записи, её шанс попасть в результаты поиска и смысловую связность, после чего отмечает аномалии относительно остальной памяти.
Подозрительную запись не стирают. DREAM постепенно уменьшает её вес, поэтому агент реже извлекает её и слабее учитывает при рассуждении. Полезные записи, подтверждённые результатами выполненных задач, получают больший вес — это снижает риск потерять нормальный опыт вместе с вредоносным.
По сравнению с A-MemGuard новый механизм работал до 2,13 раза быстрее и расходовал на 37,7% меньше токенов. Разница возникает потому, что DREAM проводит основную проверку отдельными циклами, а не привлекает LLM-аудитора к каждому запросу и не разделяет память на два хранилища.
Метод проверяли на атаках AgentPoison и MINJA, медицинском агенте EHRAgent, агенте ReAct для StrategyQA и системе из нескольких взаимодействующих агентов. В экспериментах использовали GPT-5.4-mini и Claude-Haiku-4.5, а DREAM сравнивали с фильтром по правдоподобию текста, классификатором, LLM-аудитором и A-MemGuard. Эти условия показывают результат для памяти с поиском по векторным представлениям; работа не проверяет все возможные архитектуры агентов.
Источники
Иллюстрация: рисунок из статьи «Forgetting is Not Always Bad: A Neuro-Inspired Memory Repair Mechanism for Poisoned LLM Agents», Lei Liu, Yunji Liang, Xiaowen Zhang и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


