
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Дообучение модели, которая следует инструкциям, можно удержать в заданных границах и при этом улучшить целевую задачу, если выбирать, какие слои разрешено менять. На Qwen3-8B и Qwen3-14B выбор слоёв превратил неудачное обучение только по парам вопрос — ответ в улучшение решения научных задач и перевода более чем для 100 языков, хотя препринт не рецензирован и все числа в нём получили сами авторы. Для команд это переносит контроль с одного коэффициента регуляризации на сравнение направлений обновления при одинаковом поведенческом дрейфе.
Одинаковый дрейф не означает одинаковый результат
Обычное дообучение оптимизирует ошибку на целевых данных, но не задаёт заранее, насколько модель может отойти от исходного поведения. Цена становится заметна позднее: модель осваивает новую задачу, но хуже рассуждает или отвечает на общие запросы.
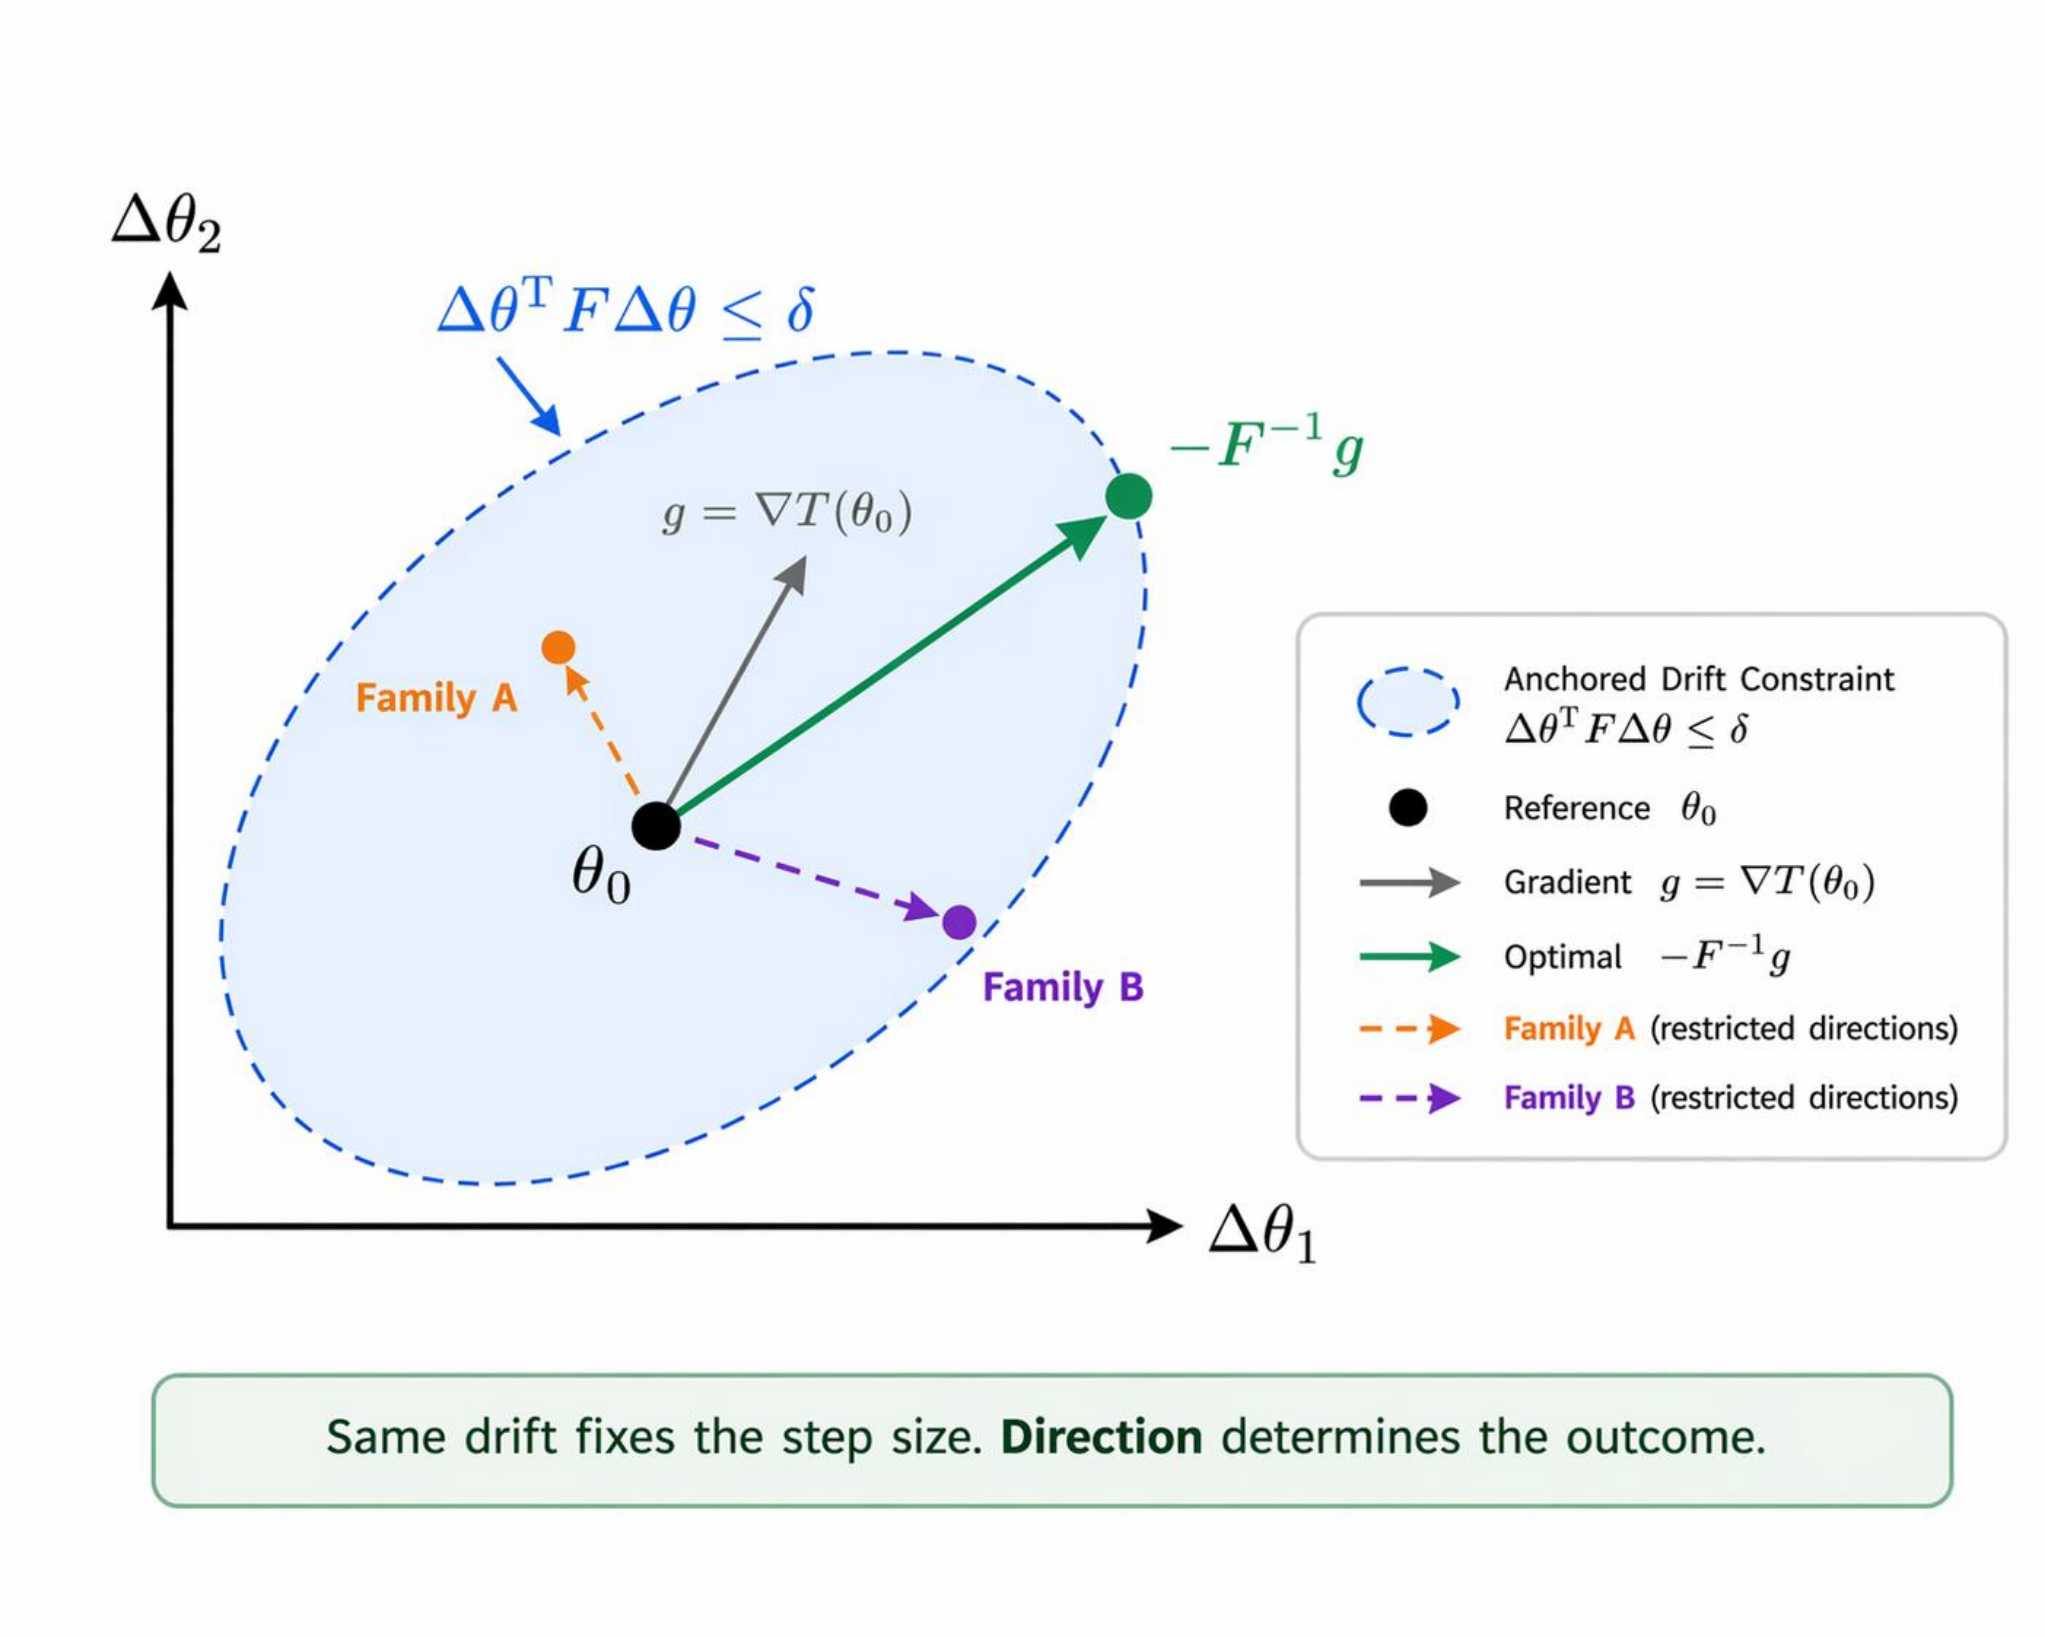
Работа предлагает сначала установить бюджет поведенческого дрейфа. Дрейф измеряют через KL-расхождение между распределениями ответов исходной и дообученной моделей на наборе общих запросов. Чем оно выше, тем сильнее изменилась модель относительно исходной версии.
При небольших изменениях этот бюджет можно представить как границу вокруг исходной модели. Расстояние до неё показывает, сколько поведения команда готова изменить, а направление — на какие способности потратить этот запас. Поэтому два обновления с одинаковым дрейфом могут дать разное качество на целевой задаче.
Из этого следует показатель направленной эффективности: насколько целевая ошибка уменьшается на единицу допустимого дрейфа. Полное дообучение, LoRA и обучение выбранных параметров тогда отличаются не только объёмом изменяемых весов. Каждый способ открывает модели свой набор направлений, среди которых оптимизатор ищет обновление.
Выбор слоёв спас обучение без цепочек рассуждения
Авторы создали жёсткое расхождение между обучением и применением. Модель видела только вопрос и итоговый ответ, но при проверке должна была построить промежуточное рассуждение. Обычное полное дообучение на подмножестве из 300 тысяч примеров MegaScience увеличивало дрейф и сначала ухудшало среднее качество рассуждений, а затем не давало устойчивого выигрыша над исходной моделью.
Вместо поиска отдельного обновления авторы перебирали доступные ему области. Они разрешали менять нижние и верхние слои Transformer, замораживали часть середины, входные представления и выходную проекцию. Данные, целевая функция и процедура обучения при этом оставались одинаковыми, поэтому результат зависел именно от выбранной группы параметров.
На одинаковом KL-расхождении около 0,27 непрерывная группа слоёв дала более высокую точность, чем разделённая. При одинаковом числе обучаемых слоёв картина изменилась: разнесённые нижние и верхние слои использовали бюджет дрейфа эффективнее. Получился не один лучший вариант, а граница компромисса: малому бюджету больше подходят разделённые группы, большому — непрерывные.
Обновление выходной проекции повышало дрейф и одновременно немного снижало точность. Это полезная практическая деталь: параметр находится рядом с итоговым распределением токенов, но его доступность не гарантирует полезного направления.
Выбранные конфигурации улучшили перевод относительно исходных Qwen3 и сравнялись с отдельными многоязычными системами либо обошли их. Полученная модель также стала лучшей исходной точкой для следующего этапа обучения с подкреплением: после одинаковой процедуры качество выросло сильнее во всех проверенных направлениях перевода.
Проверка охватывает Qwen3 двух размеров, решение научных задач и многоязычный перевод. Теоретический вывод относится к окрестности исходной модели, где дрейф можно описать локальным приближением, а в опытах его оценивали через замороженную выходную проекцию. Поэтому работа обосновывает способ сравнивать близкие варианты дообучения, но не универсальную схему выбора слоёв для любой архитектуры.
Командам стоит планировать поиск направления, а не только способ дообучения
Работа меняет экспериментальный план для продуктов, которым важно сохранить прежние способности модели. Выбор между полным дообучением и LoRA сам по себе недостаточен: контрольная версия может показать лучший результат лишь потому, что сильнее изменила поведение.
- Задать бюджет заранее. Нужен набор общих запросов, который отражает сохраняемые сценарии, и допустимое KL-расхождение относительно исходной модели.
- Сравнивать варианты при одинаковом дрейфе. Полное дообучение, LoRA и несколько групп слоёв следует сводить на одну границу «качество — дрейф», а не сопоставлять после одинакового числа шагов.
- Проверять соседние конфигурации. В опытах полезным оказался не единственный набор слоёв, а несколько близких вариантов. Это позволяет искать устойчивую область вместо случайного победителя.
- Сохранять отдельную проверку прежних способностей. KL-расхождение показывает масштаб изменения, но итоговое качество рассуждений и общих ответов всё равно проверяют прикладными тестами.
Такой процесс добавляет перебор конфигураций, но делает явным то, что стандартное дообучение оставляет скрытым: куда именно модель расходует разрешённое изменение поведения. Если потеря исходных навыков допустима, полный поиск направлений может не окупиться. Если модель должна одновременно освоить новый домен и сохранить прежние сценарии, бюджет дрейфа становится критерием выбора контрольной версии, а структура обучаемых слоёв — самостоятельным параметром эксперимента.
Источники
Иллюстрация: рисунок из статьи «Drift-Constrained Optimization: Only Direction Matters in Fine-Tuning Instruct Models», Fei Yuan, Changjiang Gao, Yilei Tu и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


