
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
KV-кэш длинного контекста удалось сокращать, выбирая записи по тому, насколько их удаление меняет выход модели. Команда SUNY, IBM и Northwestern University представила DropKV: на тестах метод сохранил более высокое качество, чем другие способы удаления записей, и ускорил обработку промпта. Работа не рецензирована, и все числа получили сами авторы; результат пока стоит рассматривать как основание для собственного замера, а не готовую настройку инфраструктуры.
Важность токена определяет не только вес внимания
Во время генерации трансформер хранит для прошлых токенов ключи и значения, чтобы не вычислять внимание заново. Этот KV-кэш растёт вместе с контекстом: для Phi-3-mini кэш на 128K токенов занимает около 48 ГБ в FP16, тогда как веса самой модели требуют примерно 7 ГБ.
Обычные методы освобождают память по весам внимания. Они считают токен неважным, если модель редко к нему обращается. Но удаление токена со средним весом тоже может заметно изменить результат, если связанный с ним вектор значения велик или направлен иначе, чем остальные.
DropKV оценивает непосредственно сдвиг выхода слоя. Для каждого токена метод вычисляет, насколько изменится итоговый вектор внимания, если удалить только этот токен. Оценка учитывает и вес внимания, и расстояние между вектором значения токена и текущим выходом.
Найти лучший набор записей совместно трудно: число комбинаций растёт слишком быстро, а сама задача относится к NP-трудным. DropKV заменяет совместный поиск независимой оценкой токенов и удаляет записи с наименьшим влиянием. Оценки суммируются по окну последних запросов, а самые свежие токены метод сохраняет.
Такое упрощение получает теоретическую гарантию, если удаляемые токены имеют малые веса внимания, а вызванные ими сдвиги направлены примерно в одну сторону и не гасят друг друга. Проверка на целевых моделях показала, что это условие выполняется для большей части голов и позиций, хотя в ранних слоях Qwen2.5 оно встречается реже.
Меньший кэш не отменил выигрыш в качестве и задержке
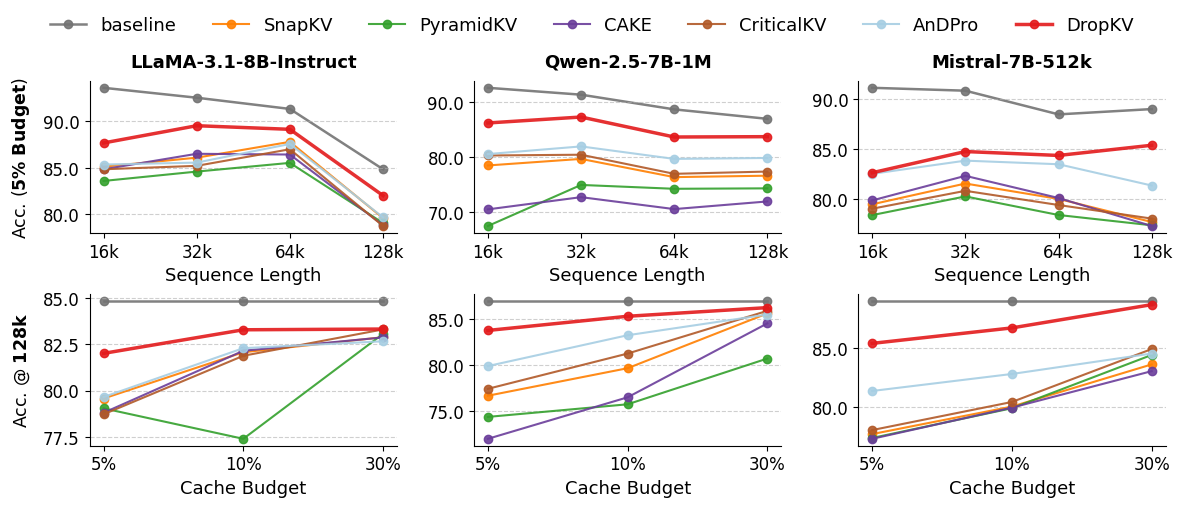
На RULER с последовательностями 64K адаптивная версия AdaDropKV при бюджете кэша 5% отстала от полного кэша для Llama-3.1-8B всего на 1,27 балла. При одинаковом объёме кэша она обошла CAKE, AdaKV и AnDPro; базовый DropKV также показал лучший средний результат среди сравниваемых способов удаления записей на RULER и LongBench.
Вычислить точный сдвиг выхода недостаточно — оценка должна помещаться в память и не съедать выигрыш от сокращения кэша. Наивная реализация создаёт большие промежуточные матрицы. Реализация на Triton обрабатывает ключи и значения блоками, не сохраняя полную матрицу внимания.
Отдельное вычислительное ядро оценки работало в 19,8 раза быстрее реализации на PyTorch. На уровне всей первичной обработки промпта ускорение достигло 9,9% при одинаковом размере пакета. Разница объяснима: оценка записей занимает только часть прохода модели, поэтому ускорение одного ядра не переносится на весь этап целиком.
Менять архитектуру рано, план эксперимента — уже стоит
DropKV проверяли на Llama-3.1-8B-Instruct, MegaBeam-Mistral-7B-512K и Qwen2.5-7B-Instruct-1M, на задачах RULER и LongBench. Замеры задержки и памяти проводили на A100-80GB, а реализация ускоряет оценку записей во время обработки промпта; отдельного ядра для этапа генерации в работе нет.
Практический выигрыш состоит не только в средней задержке. Triton снизил временную память вычисления примерно с 9 ГБ до 17 МБ, поэтому в GPU помещается больший пакет. После удаления записей генерация читает меньший KV-кэш, но этот эффект получают и другие методы с тем же бюджетом: собственное преимущество DropKV сосредоточено в выборе токенов и дешёвой обработке промпта.
Работа меняет планы команд, у которых длинный контекст уже ограничивает размер пакета или требует дорогих GPU. Вместо выбора только между полным кэшем, скользящим окном и оценкой по вниманию теперь имеет смысл добавить DropKV в испытания и сравнить качество на своих документах, коде или диалогах.
Сразу делать его единственной политикой хранения не следует. Метод удаляет записи окончательно, а качество зависит от модели и слоя. Рациональный следующий шаг — проверить несколько бюджетов кэша, измерить качество прикладной задачи и отдельно сравнить задержку обработки промпта, скорость генерации и максимальный пакет.
Источники
Иллюстрация: рисунок из статьи «DropKV: Decoupling Residual-Output Perturbation for Near-Optimal KV-Cache Eviction», Aozhong Zhang, Selcuk Gurses, Yanxia Deng и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


