
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Низкоразрядную квантизацию LLM научились улучшать уже после обычной обработки модели, не меняя формат весов и код инференса. Хотя работа не рецензирована и все числа получили сами авторы, на Llama-3.1-70B при двухбитной GPTQ метод DRQ снизил перплексию на C4 с 31,77 до 27,11; чем ниже эта метрика, тем увереннее модель предсказывает следующий токен. Для команды это дополнительный офлайн-этап между квантизацией и выпуском модели, а не замена стека развёртывания.
Почему меньшая ошибка реконструкции ухудшает модель
Посттренировочная квантизация (PTQ) заменяет исходные веса числами низкой разрядности, но сохраняет точность активаций. GPTQ, AWQ и похожие методы подбирают квантизованные веса так, чтобы выход каждого слоя как можно меньше отличался от выхода исходной модели на калибровочных текстах. Это отличие называют ошибкой реконструкции.
Такая цель выглядит естественно, но учитывает только активации, которые встретились при калибровке. Если один входной канал почти не активировался, алгоритм может допустить крупную ошибку в соответствующих весах: на имеющихся примерах она почти не влияет на выход слоя. Другие тексты сильнее задействуют этот канал, и незаметное отклонение становится существенным.
Разрыв проявился даже без смены данных. В опыте с трёхбитной AWQ дальнейшее снижение ошибки реконструкции ухудшило перплексию в 18 из 32 изменений отдельных слоёв на тех же калибровочных примерах.
На отложенных текстах эффект оказался ещё заметнее. Исследователи подготовили 560 вариантов матриц весов, каждый из которых лучше восстанавливал выход слоя на калибровке. В 73,8% случаев модель с изменённой матрицей показала худшую перплексию на отложенной части WikiText-2. Значит, точнее оптимизировать прежнюю цель недостаточно: она не всегда совпадает с качеством всей модели.
Как DRQ выбирает более устойчивые коды весов
DRQ работает поверх результата базового метода квантизации. Каждый вес уже представлен целочисленным кодом на фиксированной сетке значений. Метод перебирает изменения этих кодов, но сохраняет разрядность, разбиение весов на группы, масштабы и точки нуля.
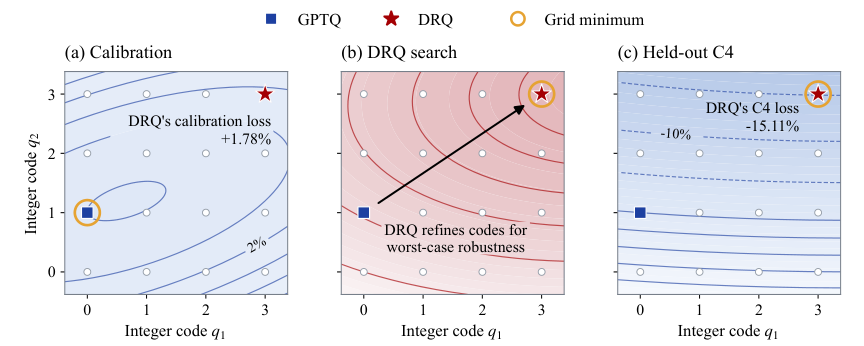
Вместо ошибки на одной калибровочной выборке DRQ оценивает сумму двух величин. Первая показывает, насколько выход квантизованного слоя отличается от исходного на известных активациях. Вторая оценивает наибольшую возможную ошибку, если распределение активаций изменится в заданных пределах.
Процедура проходит по блокам Transformer и обрабатывает линейные слои по очереди:
- Собирает активации слоя на калибровочных текстах и вычисляет связи между входными каналами.
- Находит направление изменения входов, в котором расхождение между исходными и квантизованными весами сильнее всего увеличивает выходную ошибку.
- Ранжирует допустимые замены целочисленных кодов по тому, насколько они уменьшают обычную и худшую возможную ошибку вместе.
- Формирует несколько матриц-кандидатов и оставляет только те, которые улучшают итоговую цель. Рост ошибки на калибровке дополнительно ограничен и проверяется на отдельных подвыборках.
Из-за этого DRQ иногда сознательно выбирает матрицу, которая чуть хуже повторяет слой на калибровочных данных, но меньше зависит от конкретного распределения входов. В одном разборе двух кодов ошибка на WikiText-2 выросла на 1,78%, зато на C4 снизилась на 15,11%.
Вся доработка происходит до развёртывания. Полученный файл использует ту же сетку весов и те же операции инференса, поэтому DRQ не добавляет вычислений при генерации и не требует отдельного ядра для GPU.
Когда команде стоит добавить DRQ в план
Метод имеет смысл рассматривать как проверяемую стадию после уже настроенной PTQ, особенно при агрессивном снижении разрядности. Не нужно менять GPTQ, AWQ или другой базовый алгоритм: DRQ принимает их результат и корректирует только коды. Это позволяет сохранить существующие загрузчики модели, формат артефакта и путь выполнения.
Проверка охватила шесть методов PTQ, плотные модели семейства Llama разных размеров и Qwen3-30B-A3B со смесью экспертов. Калибровку и оценку проводили на WikiText-2 и C4, а качество также измеряли на наборе задач с выбором ответа. DRQ улучшил среднюю точность для всех сравнений GPTQ и AWQ и помог каждому из шести базовых методов; перплексия снижалась в большинстве опытов.
Наибольший практический смысл подход даёт там, где низкая разрядность уже заметно повредила качество. При более щадящей четырёхбитной квантизации улучшения сохранялись, но исходные модели и без того были ближе к полной точности. При этом DRQ не исправил полностью тяжёлую деградацию двухбитной AWQ, поэтому он не заменяет проверку модели на собственных запросах.
План внедрения от этого меняется локально: после базовой квантизации стоит сравнить исходный артефакт и версию после DRQ на рабочих данных, а затем выпускать победивший вариант через прежний инференс. Переносить метод на все модели без такого сравнения рано: эксперименты охватывают конкретные семейства моделей, низкие разрядности и текстовые наборы.
Источники
Иллюстрация: рисунок из статьи «When Lower Reconstruction Loss Hurts: Distributionally Robust Refinement for Low-Bit LLM Quantization», Yanlong Zhao, Xiaoyuan Cheng, Huihang Liu и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


