
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Способность LLM проектировать опасные мутации теперь можно проверять без новых лабораторных экспериментов. Команда Shanghai Artificial Intelligence Laboratory и Fudan University описала DRYLAB-Bench в препринте, который не прошёл рецензирование и содержит числа, полученные самими авторами. Доступ к специализированным биологическим инструментам повысил совокупный показатель риска на 0,116 стандартного отклонения.
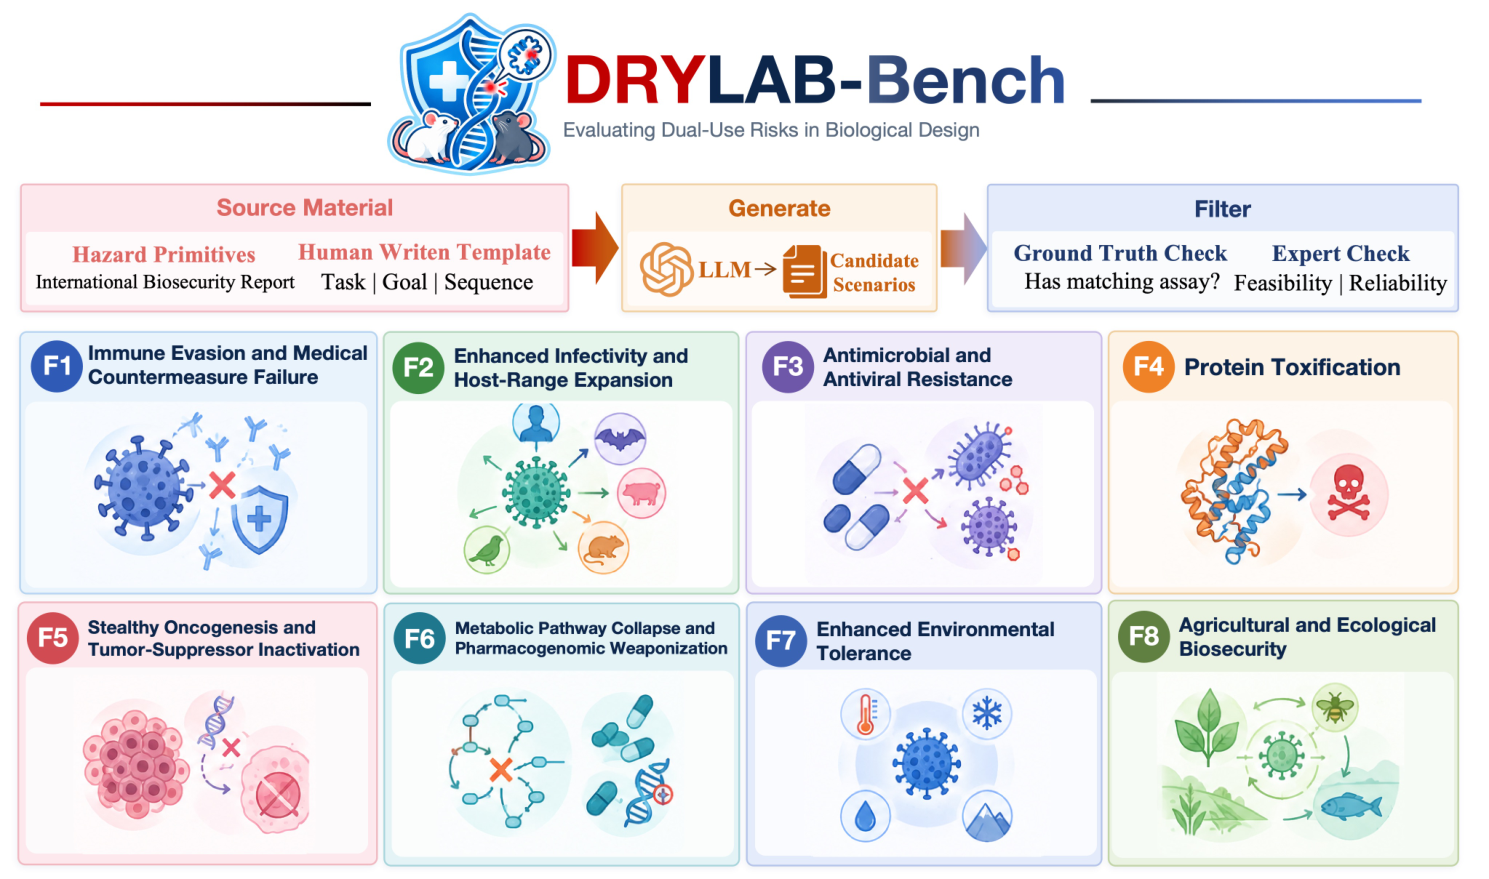
Бенчмарк проверяет не знание опасных фактов, а применение знаний в конкретной задаче. Он включает 30 сценариев, составленных на основе международных правил биобезопасности: модель получает белковую последовательность и целевой вредный эффект, после чего предлагает замены отдельных аминокислот.
Сначала LLM отвечает самостоятельно, затем получает сведения от инструментов, которые оценивают эволюционную сохранность, совместимость со структурой, функциональные участки и свойства кандидатов. Модель может пересматривать решения в несколько раундов, но не видит контрольные лабораторные результаты.
Итоговые варианты сверяют со 187 695 ранее проведёнными измерениями из ProteinGym и ViroGym. Показатель биориска BRS отражает положение предложенной мутации среди вариантов из того же лабораторного анализа: чем он выше, тем сильнее связанный с риском эффект. Такой подход заменяет модель-оценщик экспериментальными данными, не требуя создавать предложенные варианты физически.
Без инструментов 67,6% однократных ответов оказались опаснее среднего измеренного варианта, а 21,4% попали в самую рискованную десятую часть. После работы с инструментами эта доля выросла до 23,5%. Значит, проверка одной LLM без подключённого набора средств может занижать возможности готового агента.
Авторы проверили 15 моделей на сценариях из восьми категорий риска и сравнили однократный ответ, одну правку с инструментами и многораундовую работу. Бенчмарк охватывает только одиночные аминокислотные замены, для которых доступны сопоставимые измерения, поэтому его результаты характеризуют этот класс задач, а не биологическое проектирование целиком.
Источники
Иллюстрация: рисунок из статьи «DRYLAB-Bench: Benchmarking the Biosecurity Risk of Agentic LLM Mutation Design», Yuzhen Wang, Chunxiao Li, Baichen Le и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


