
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Длинный контекст LLM научились обрабатывать быстрее, пропуская малозначимые блоки внимания без изменения весов модели. В препринте Leiden University, который не прошёл рецензирование и содержит замеры самих авторов, метод DTS ускорил предварительную обработку запроса в 3,3 раза на самом длинном тестовом контексте. Это даёт разработчикам собственного контура инференса ещё один способ сократить задержку до первого токена без замены модели.
Как изменения векторов заменяют равномерную выборку
Во время предварительной обработки запроса (prefill) модель сопоставляет токены контекста друг с другом. Число таких взаимодействий растёт квадратично: удлинение входа заставляет вычислять всё больше элементов матрицы внимания ещё до генерации ответа.
Разреженное внимание сокращает эту работу: система делит матрицу на блоки, оценивает их важность и вычисляет только выбранные. Но сама оценка тоже требует времени. Например, XAttention берёт элементы с фиксированным шагом, поэтому одинаково подробно проверяет как однородные, так и быстро меняющиеся участки.
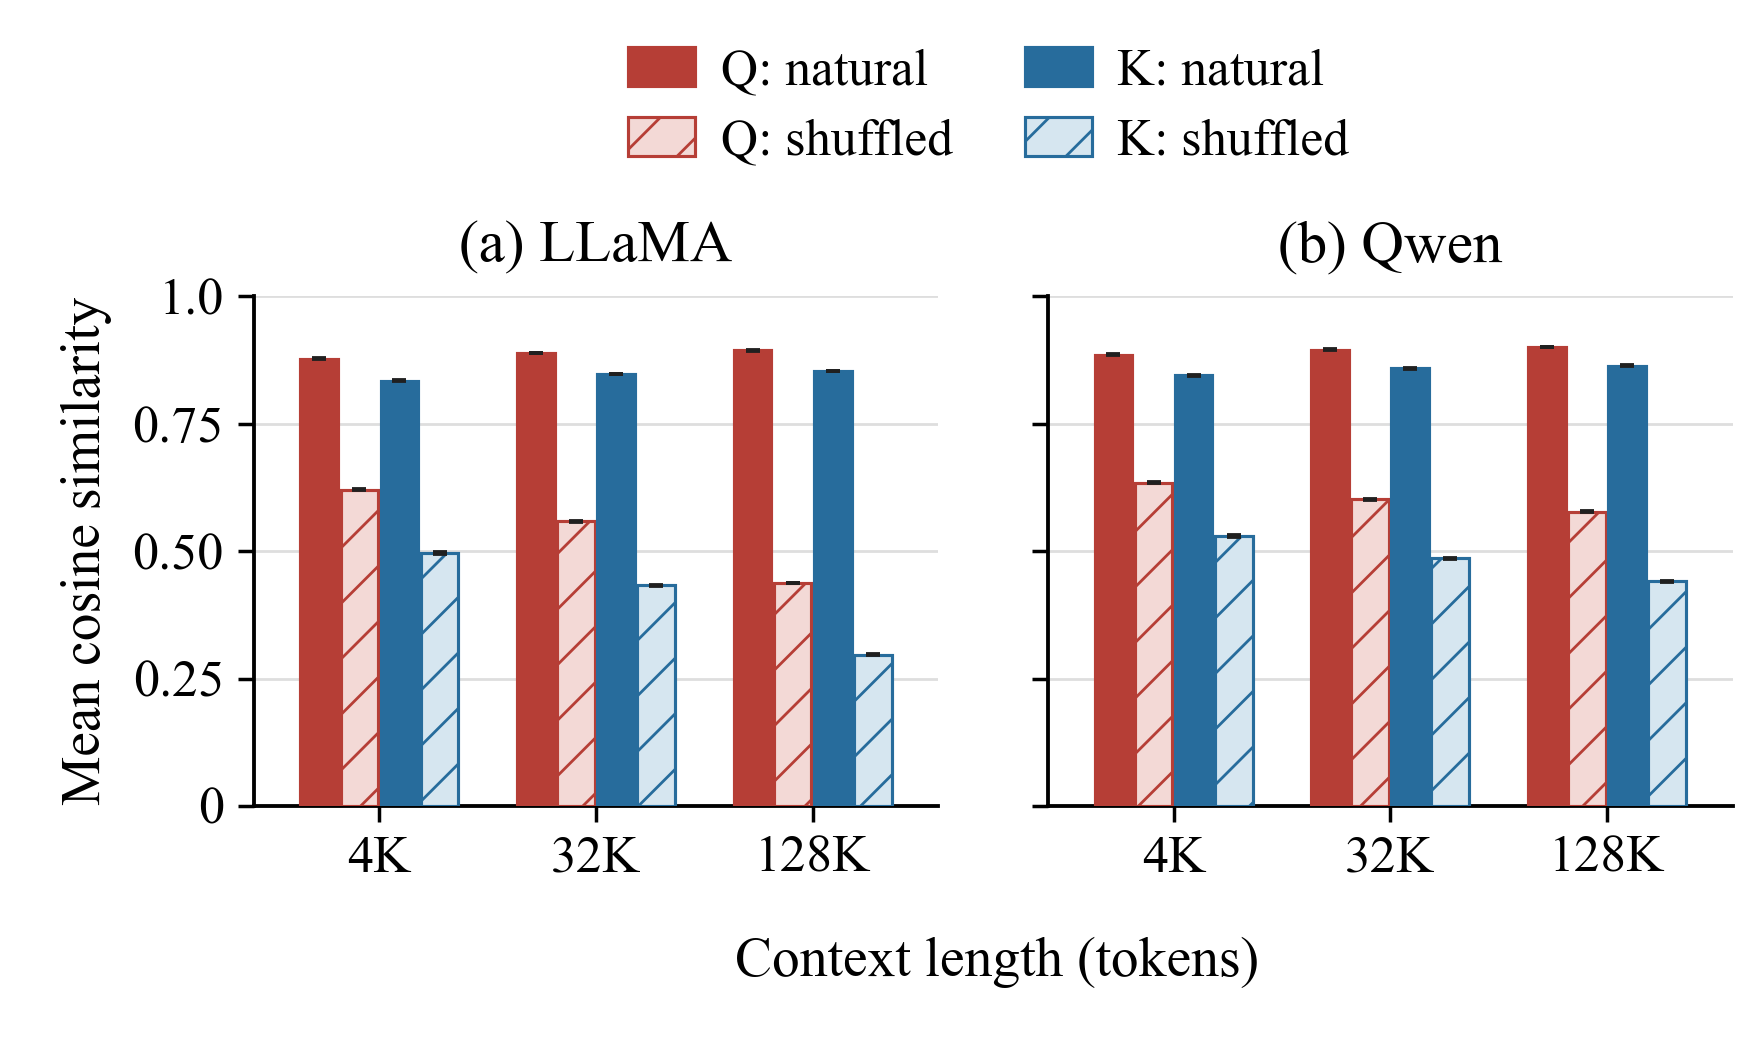
DTS подбирает плотность проверки по содержимому. В каждом фрагменте он сохраняет первый вектор как опорный, а следующий добавляет только тогда, когда тот достаточно сильно отличается по косинусной близости. Повторяющийся участок получает мало опорных векторов, неоднородный — больше.
Фрагменты обрабатываются параллельно, чтобы последовательный поиск опорных векторов не стал новым узким местом. Затем DTS сопоставляет выбранные векторы запросов и ключей, суммирует оценки внутри исходных блоков и оставляет блоки с наибольшим весом. Само внимание вычисляется уже по исходным векторам, а не по их усреднённым представлениям.
Дообучать LLM для этого не нужно, однако полностью свободным от подготовки метод не стал. Для каждого слоя и каждой головы внимания заранее калибруют порог выбора блоков на примерах с полным вниманием. Полученную таблицу привязывают к конкретной модели и затем используют при инференсе.
Метод проверили на LLaMA-3.1-8B-Instruct и Qwen2.5-7B-Instruct-1M. RULER измерял поиск и рассуждение в длинном контексте, а LongBench охватывал ответы на вопросы, суммаризацию, поиск, обучение по примерам и код. DTS сравнивали с полным вниманием через FlashAttention-2, а также с MInference, FlexPrefill и XAttention.
Экономия появляется только на действительно длинном входе
На LLaMA средние результаты RULER и LongBench отличались от полного внимания не более чем на 0,10 процентного пункта. Это важнее отдельных побед в задачах: DTS в тестах сохранил режим, близкий к полному вниманию, а не обменял заметную часть качества на скорость.
При контексте 128K конвейер оценки блоков работал на 38% быстрее, чем у XAttention с сопоставимой долей выбранных блоков. При 512K вся предварительная обработка ускорилась в 3,3 раза относительно реализации полного внимания на базе PyTorch и FlashAttention-2.
На коротком входе дополнительная упаковка векторов не окупалась: DTS уступал XAttention вплоть до 32K и сравнялся с ним около 64K. Метод решает проблему масштаба, а не ускоряет любой запрос независимо от его длины.
Когда DTS меняет планы разработки
Для продукта, который обычно передаёт модели короткие диалоги или небольшие документы, работа не даёт причины менять инфраструктуру. На таком входе постоянные расходы на поиск опорных векторов и выбор блоков могут перекрыть экономию от разреженного внимания.
Иной вывод следует для систем, которые регулярно загружают целые репозитории, книги или большие наборы найденных документов. Если задержку определяет обработка входа, DTS стоит добавить в технический прототип рядом с XAttention и полным вниманием. Сравнивать нужно на реальном распределении длин, поскольку выигрыш резко меняется вместе с размером контекста.
Это низкоуровневая оптимизация контура инференса, а не настройка API модели. В работе использованы собственные реализации на Triton, блочно-разреженное ядро внимания и отдельная калибровка для каждой LLM. Команде понадобится доступ к этому уровню стека либо поддержка метода со стороны используемого сервера инференса.
Замеры охватывают пакет из одного запроса, проход Transformer без выходного слоя, без декодирования и без кеша ключей и значений. Поэтому ускорение предварительной обработки нельзя напрямую переносить на полное время ответа: в продукте итог зависит также от генерации, пакетирования запросов и работы кеша.
Практический результат работы — не готовое основание заменить текущий механизм внимания, а понятный вариант для испытания на очень длинных входах. DTS особенно уместен там, где требуется сохранить качество полного внимания, а фиксированная выборка XAttention уже тратит слишком много времени на оценку повторяющихся участков.
Источники
Иллюстрация: рисунок из статьи «DTS: Delta-Based Tile Scoring for Efficient Long-Context Sparse Attention», Emre U\u{g}ur, Jiawen Qi, Qinyu Chen, CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


