
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Систему перевода вопросов на обычном языке в SQL научили совместно улучшать поиск нужных элементов схемы и составление запроса. DualSQL-8B набрала 71,1% точности исполнения на BIRD-Dev и обошла прежние решения с одной моделью на 32B параметров, хотя препринт не рецензирован и числа получили сами авторы. Результат предлагает альтернативу конвейерам, где для каждого этапа обучают отдельную LLM.
Два агента используют одни веса
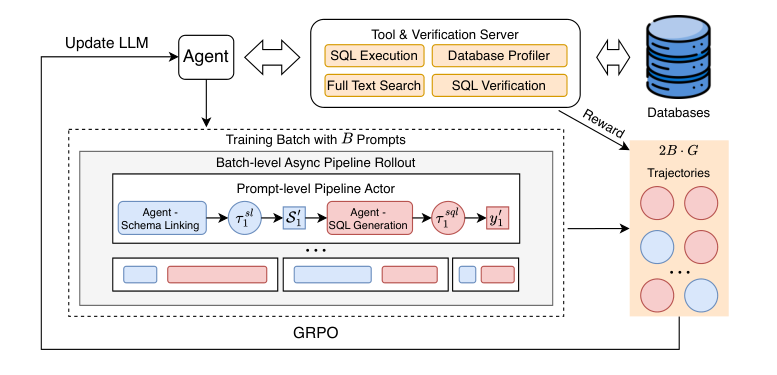
Работу выполнили специалисты The Ohio State University и Google. DualSQL состоит из агента привязки к схеме и агента генерации SQL, но оба работают на одной модели Qwen3 с общими весами.
Первый агент получает вопрос и полную схему базы, затем выбирает относящиеся к задаче таблицы и столбцы. Второй составляет запрос по сокращённой схеме. Такое разделение не заставляет генератор разбирать все доступные таблицы и оставляет ему возможность снова обратиться к базе, если первый этап пропустил нужные данные.
Оба агента используют одинаковый набор инструментов. Исполнитель SQL запускает промежуточные запросы, помогает проверить синтаксис, соединения и представление значений. Полнотекстовый поиск сопоставляет формулировки пользователя с именами полей и содержимым ячеек, включая неточные совпадения.
Профилировщик базы заранее готовит описания таблиц и столбцов, статистику значений и предполагаемые внешние ключи, которых может не быть в определении схемы. Поэтому часть затрат переносится из времени обработки запроса в предварительную подготовку базы.
Во время обучения этапы образуют один процесс: результат первого агента становится входом второго, а общие веса получают сигналы от обеих задач. Асинхронный запуск не заставляет короткие траектории ждать длинные, когда агенты делают разное число обращений к инструментам.
Ошибочный ход останавливают, а не награждают за удачный финал
Обычные методы стабилизации обучения не остановили три сбоя: модель путала служебные блоки, зацикливалась или неверно оформляла вызовы инструментов. При этом агент иногда всё же приходил к правильному SQL и получал награду, закрепляя ошибочное поведение.
DualSQL строго проверяет каждый ход. Рассуждение не может быть пустым, вызов инструмента должен содержать корректный JSON, а один и тот же инструмент нельзя повторно вызывать с теми же аргументами. После нарушения система сразу прекращает текущую траекторию.
При ошибке в последнем ходе функция потерь игнорирует предшествующие корректные ходы. Модель переучивает именно сломанное действие, а не отказывается от всей цепочки рассуждений. На тестировании ошибка инструмента возвращается агенту как результат вызова, чтобы тот мог исправить аргументы и продолжить работу.
Награду за SQL рассчитывают через устойчивое совпадение результатов (REX). Стандартная метрика EX превращает результат запроса в множество значений, поэтому может не заметить лишние дубликаты или, наоборот, счесть ошибкой перестановку равнозначных столбцов. REX сопоставляет строки и столбцы, учитывает дубликаты, а порядок строк требует только для запросов с ORDER BY.
Более точная проверка влияет не только на итоговую оценку. Она не позволяет обучению закреплять запросы, которые случайно проходят грубую метрику, хотя неверно используют DISTINCT или сортировку.
Общий каркас стоит проверять раньше отдельных моделей
Переход от одношаговой генерации к работе с инструментами прибавил 2,3 пункта по EX и 5,4 пункта по REX. Совместное обучение привязки к схеме и генерации добавило ещё 1,5 и 1,9 пункта соответственно. Значит, прирост даёт не только доступ к базе: общие веса также помогают двум этапам согласовать поведение.
Для команд это меняет порядок архитектурного эксперимента. Прежде чем обучать и обслуживать отдельные модели для поиска схемы и генерации SQL, можно проверить два логических агента на одной основе. Такой вариант сохраняет специализацию этапов, но знания о структуре базы и использовании инструментов обновляются совместно.
Проверка охватывает две конфигурации Qwen3, датасет BIRD и обучение на 3755 примерах. В сравнении участвовали одношаговая генерация, один агент с инструментами и полный конвейер; работа с базой во время обучения и оценки была доступна только для чтения.
Переносить результат на произвольную СУБД без отдельного испытания рано: инструменты используют возможности SQLite, а REX остаётся приближённой проверкой смысловой эквивалентности SQL. Для производственного контура также сохраняются риски истощения ресурсов тяжёлыми запросами и атак через инструкции в данных.
Практический вывод относится прежде всего к системам, где схема велика, значения нужно проверять по самой базе, а промежуточные ошибки можно оценить автоматически. Здесь общий каркас, точная награда и немедленная остановка повреждённых траекторий выглядят содержательнее простого увеличения модели.
Источники
Иллюстрация: рисунок из статьи «DualSQL: Text-to-SQL with Multi-Agent Reinforcement Learning», Shijie Chen, Yu Gan, Yeounoh Chung и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


