
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
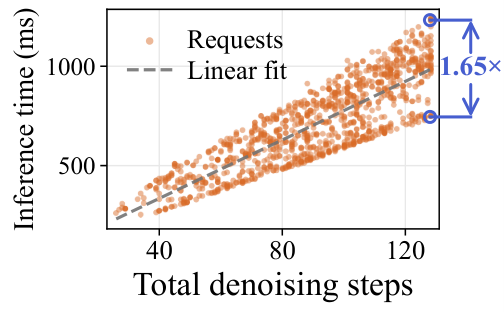
Стоимость запроса к диффузионной LLM научились точнее оценивать ещё до запуска генерации. Команда Wuhan University, Shanghai Jiao Tong University и партнёров получила ошибку до 2,5 раза меньше, чем у прогнозов по одному числу, хотя препринт не рецензирован, а числа получили сами авторы. Такой прогноз позволяет планировщику раньше пропускать дешёвые запросы и не давать длинным ответам задерживать всю очередь.
Почему длина ответа не показывает объём вычислений
Авторегрессионная LLM добавляет по одному токену за проход, поэтому длина ответа неплохо отражает объём работы. Диффузионная LLM восстанавливает сразу несколько скрытых токенов, а их количество меняется от прохода к проходу.
Из-за этого запросы с одинаковой длиной входа и выхода на LLaDA2.0-mini различались по времени выполнения до 11,47 раза. Подсчёт шагов восстановления тоже не решает задачу: одинаковые по счёту шаги стоят по-разному в зависимости от блока ответа, позиции внутри блока и длины уже обработанного контекста.
Для разбора стоимости собрали 20 тысяч трасс запросов из LMSYS-Chat-1M. Время разделили на первичную обработку запроса, обновление кеша ключей и значений после завершения блока и собственно восстановление токенов. Первые две части достаточно описать числом входных и выходных блоков, а для основной части нужен более подробный объект.
Таким объектом стала поверхность нагрузки при восстановлении токенов, DWS. Это таблица, где строки соответствуют блокам ответа, столбцы — шагам внутри блока, а каждая ячейка показывает вероятность, что запрос дойдёт до этой точки вычислений.
Чтобы получить ожидаемую стоимость, система умножает вероятность каждой ячейки на измеренную стоимость соответствующего шага и складывает результаты. Затем добавляет стоимость первичной обработки и обновления кеша. В отличие от длины ответа или общего числа шагов, DWS сохраняет структуру генерации, от которой зависит фактическое время работы.
Как предсказывают поверхность до начала генерации
Планировщику нужна оценка до выполнения запроса, поэтому DWS строят только по исходному тексту. Компактный кодировщик all-MiniLM-L12-v2 превращает запрос в представление, после чего две отдельные части предсказателя оценивают, до какого блока дойдёт ответ и сколько шагов восстановления потребуется каждому достигнутому блоку.
Такое разложение учитывает порядок генерации. Если запрос не дошёл до блока, ячейки этого блока не могут быть активны; если блок завершился на раннем шаге, поздние шаги также исключаются. Предсказатель поэтому не создаёт невозможные поверхности, где поздний этап вероятен сильнее раннего.
Обучение идёт от грубой оценки к детальной. Сначала кодировщик учится различать общий объём работы на нескольких горизонтах: от числа выходных блоков до полного набора шагов. Затем отдельные части модели восстанавливают распределения по блокам и шагам, из которых собирается поверхность.
Предсказатель переводят в пониженную точность и запускают на одном ядре CPU. Он не отнимает ресурсы GPU у обслуживающей модели, как это мог бы делать более тяжёлый оценщик.
Запросозависимую часть при этом отделили от конкретного оборудования. Предсказатель оценивает только вероятную схему выполнения, а стоимость ячеек система измеряет на целевой конфигурации. При переносе на другие GPU или другой системный стек достаточно повторить профилирование, не обучая предсказатель заново.
DWS меняет план только там, где запросы стоят в очереди
В онлайн-экспериментах планировщик сначала запускал запросы с меньшей ожидаемой стоимостью. На LMSYS-Chat-1M это сократило полную задержку до 1,92 раза, а время до первого токена — до 2,22 раза относительно обработки в порядке поступления FCFS. При слабой нагрузке планировщики работали почти одинаково: преимущество появлялось, когда запросы начинали конкурировать за ресурсы.
В пакетной генерации данных DWS ускорил получение заданного числа ответов до 2,73 раза относительно FCFS. Он также опередил PARS-Cost, который прогнозирует стоимость напрямую и потому сильнее зависит от оборудования и скорости самого оценщика.
Проверка охватила LLaDA2.0-mini и LLaDA2.0-flash, а также нагрузки LMSYS-Chat-1M, ShareGPT и Alpaca. Предсказатель обучали на трассах одной модели и одного набора запросов, после чего переносили на другие наборы и модель того же семейства; для новой конфигурации заново измеряли стоимость вычислительных ячеек.
Для команды, которая обслуживает блочно-авторегрессионную диффузионную LLM, работа предлагает практическую архитектуру планировщика: собирать трассы по блокам и шагам, отдельно профилировать их стоимость и ставить запросы в очередь по ожидаемым затратам. Это не ускоряет отдельный проход модели, но уменьшает блокировку коротких запросов длинными.
Если сервис работает без очередей, переход на DWS не даст заметного выигрыша по приведённым экспериментам. Если же задержка растёт под нагрузкой или пакетная система должна быстрее выпускать первые результаты, поверхность стоимости становится полезнее прогноза длины ответа и общего числа шагов.
Источники
Иллюстрация: рисунок из статьи «Denoising Surface: Modeling and Predicting Inference Cost for Diffusion LLM Serving», Haoyu Zheng, Fangcheng Fu, Binhang Yuan и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


