
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Функцию награды для обучения с подкреплением научились настраивать по предпочтениям, не запуская агента в реальной среде или симуляторе. В препринте Stanford University и University of Texas at Austin, который не прошёл рецензирование, а числа в нём получили сами авторы, метод EARS чаще создавал более согласованную награду, чем прямой запрос к LLM. Такой подход позволяет вынести подбор цели из дорогого или опасного цикла обучения агента.
Как воображаемые траектории заменяют запуски агента
Обычное обучение награды по предпочтениям требует показать оценщику несколько вариантов поведения агента. Для этого команда обучает промежуточную политику, запускает её в среде, собирает траектории и просит человека выбрать лучший вариант. Цикл приходится повторять, а среди примеров нужны не только удачные, но и плохие действия.
В робототехнике, медицине и сложных физических симуляторах такой сбор стоит дорого или создаёт риск. EARS не генерирует реальные последовательности состояний. Вместо этого метод сначала формирует компактное пространство признаков, а затем задаёт вопросы о вымышленных сочетаниях этих признаков.
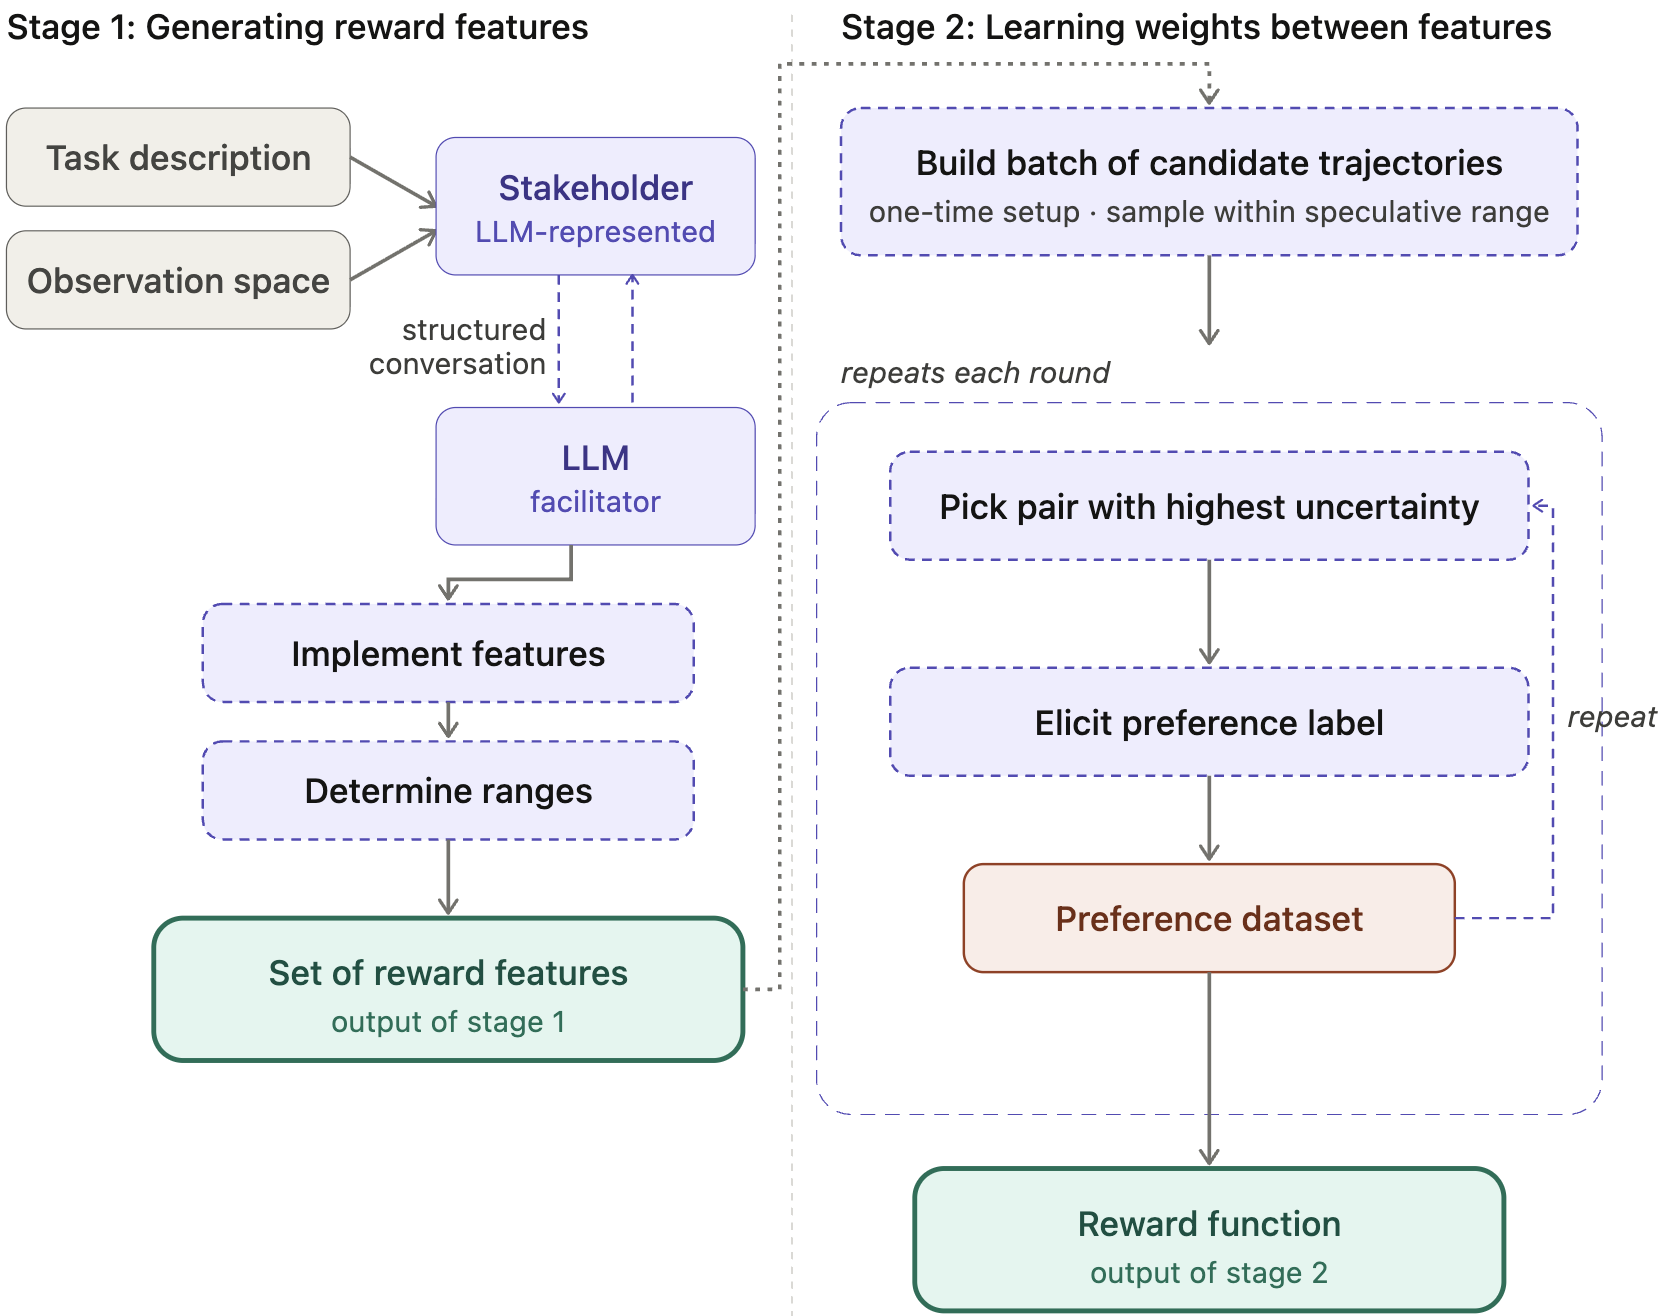
На первом этапе одна LLM играет роль заинтересованной стороны, а другая — ведущего обсуждения. Они получают описание задачи, доступные наблюдения среды и, при наличии, текстовое описание цели. Результатом становятся исполняемые функции на Python: например, доля пациентов в критическом состоянии, строгость ограничений и загрузка больниц.
Для каждого признака LLM также задаёт предполагаемый диапазон значений за всю траекторию. EARS выбирает значения внутри этих диапазонов и составляет пары воображаемых исходов. Два сравниваемых варианта отличаются не более чем по двум признакам, чтобы оценщик мог связать свой выбор с конкретным компромиссом.
Метод ищет пары, по которым текущие варианты функции награды расходятся сильнее всего. После каждого ответа он уточняет веса признаков. Итоговая награда остаётся линейной: каждый признак получает вес, а их взвешенная сумма оценивает переход агента между состояниями.
Прямое описание цели проиграло серии сравнений
Награду проверяли в трёх задачах с длинным горизонтом: регулирование ограничений во время пандемии, дозирование инсулина и управление автомобилем на шоссе. Для каждой среды использовали два варианта эталонной награды. Все эксперименты с LLM проводили на Gemini 3.
Качество измеряли коэффициентом согласованности траекторий TAC. Метрика показывает, насколько одинаково выученная и эталонная функции награды ранжируют пары траекторий: высокий результат означает, что обе предпочитают одни и те же исходы.
При синтетической разметке EARS обучали на 1 000 точных предпочтений либо на 2 000 предпочтений со случайным шумом. В обоих режимах он в целом точнее воспроизводил эталонную награду, чем LLM, которой поручали сразу написать функцию. Даже подробное описание скрытой цели не гарантировало прямому запросу хорошего результата.
В более практичном варианте LLM читала текстовую спецификацию и сама выбирала лучший исход в каждой воображаемой паре. EARS превзошёл прямую генерацию награды почти во всех конфигурациях. Исключением стала одна настройка задачи дорожного движения, где прямой запрос с реалистичным описанием цели сработал лучше.
Сравнение с Offline-RLHF и Learning To Rank Real Trajectories также не показало преимущества реальных траекторий по числу нужных предпочтений. EARS требовал меньше разметки, чем Offline-RLHF, и обычно соответствовал или превосходил Learning To Rank Real Trajectories. При этом он не запрашивал переходы из среды.
Когда можно убрать среду из проектирования награды
EARS меняет планы команд, у которых сбор пробного поведения составляет заметную часть стоимости или риска проекта. Функцию награды можно обсуждать и проверять до обучения политики: сначала согласовать измеримые признаки, затем разобрать спорные компромиссы на воображаемых исходах.
Метод не устраняет потребность в среде на всех этапах. Он создаёт функцию награды без запусков агента, но для последующего обучения и проверки политики среда, симулятор или другой источник опыта всё ещё могут понадобиться. Экономия относится именно к спецификации цели.
Архитектурно EARS добавляет управляемый промежуточный слой между текстом требований и кодом награды. Это полезнее прямого запроса к LLM: команда получает отдельные признаки, явные веса и историю сравнений, по которой можно искать неверно заданный компромисс. Цена подхода — дополнительные вызовы LLM для разметки предпочтений.
Границы проверки пока узкие: работа охватывает перечисленные симулируемые задачи, а предпочтения задаёт эталонная функция или LLM. Люди и профильные эксперты не оценивали физически невозможные воображаемые траектории. Поэтому EARS уже даёт схему для прототипа награды, но не подтверждает, что медицинский или транспортный специалист сможет надёжно разметить такие пары без адаптации представления.
Источники
Иллюстрация: рисунок из статьи «Specifying Reward Functions for RL Without Environment Sampling», Stephane Hatgis-Kessell, W. Bradley Knox, Emma Brunskill, CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


