
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Аномальные узлы в графе научились ранжировать без нейросети, обучающей выборки и размеченного набора для настройки. Хотя препринт не прошёл рецензирование и все числа получили сами авторы, EB-GAD чаще базовых методов показывал лучший AUROC — площадь под ROC-кривой. Для первого детектора мошенничества или подозрительных аккаунтов теперь можно проверить подход без отдельного проекта по обучению модели.
Норму подгоняют по остаткам, а не по меткам
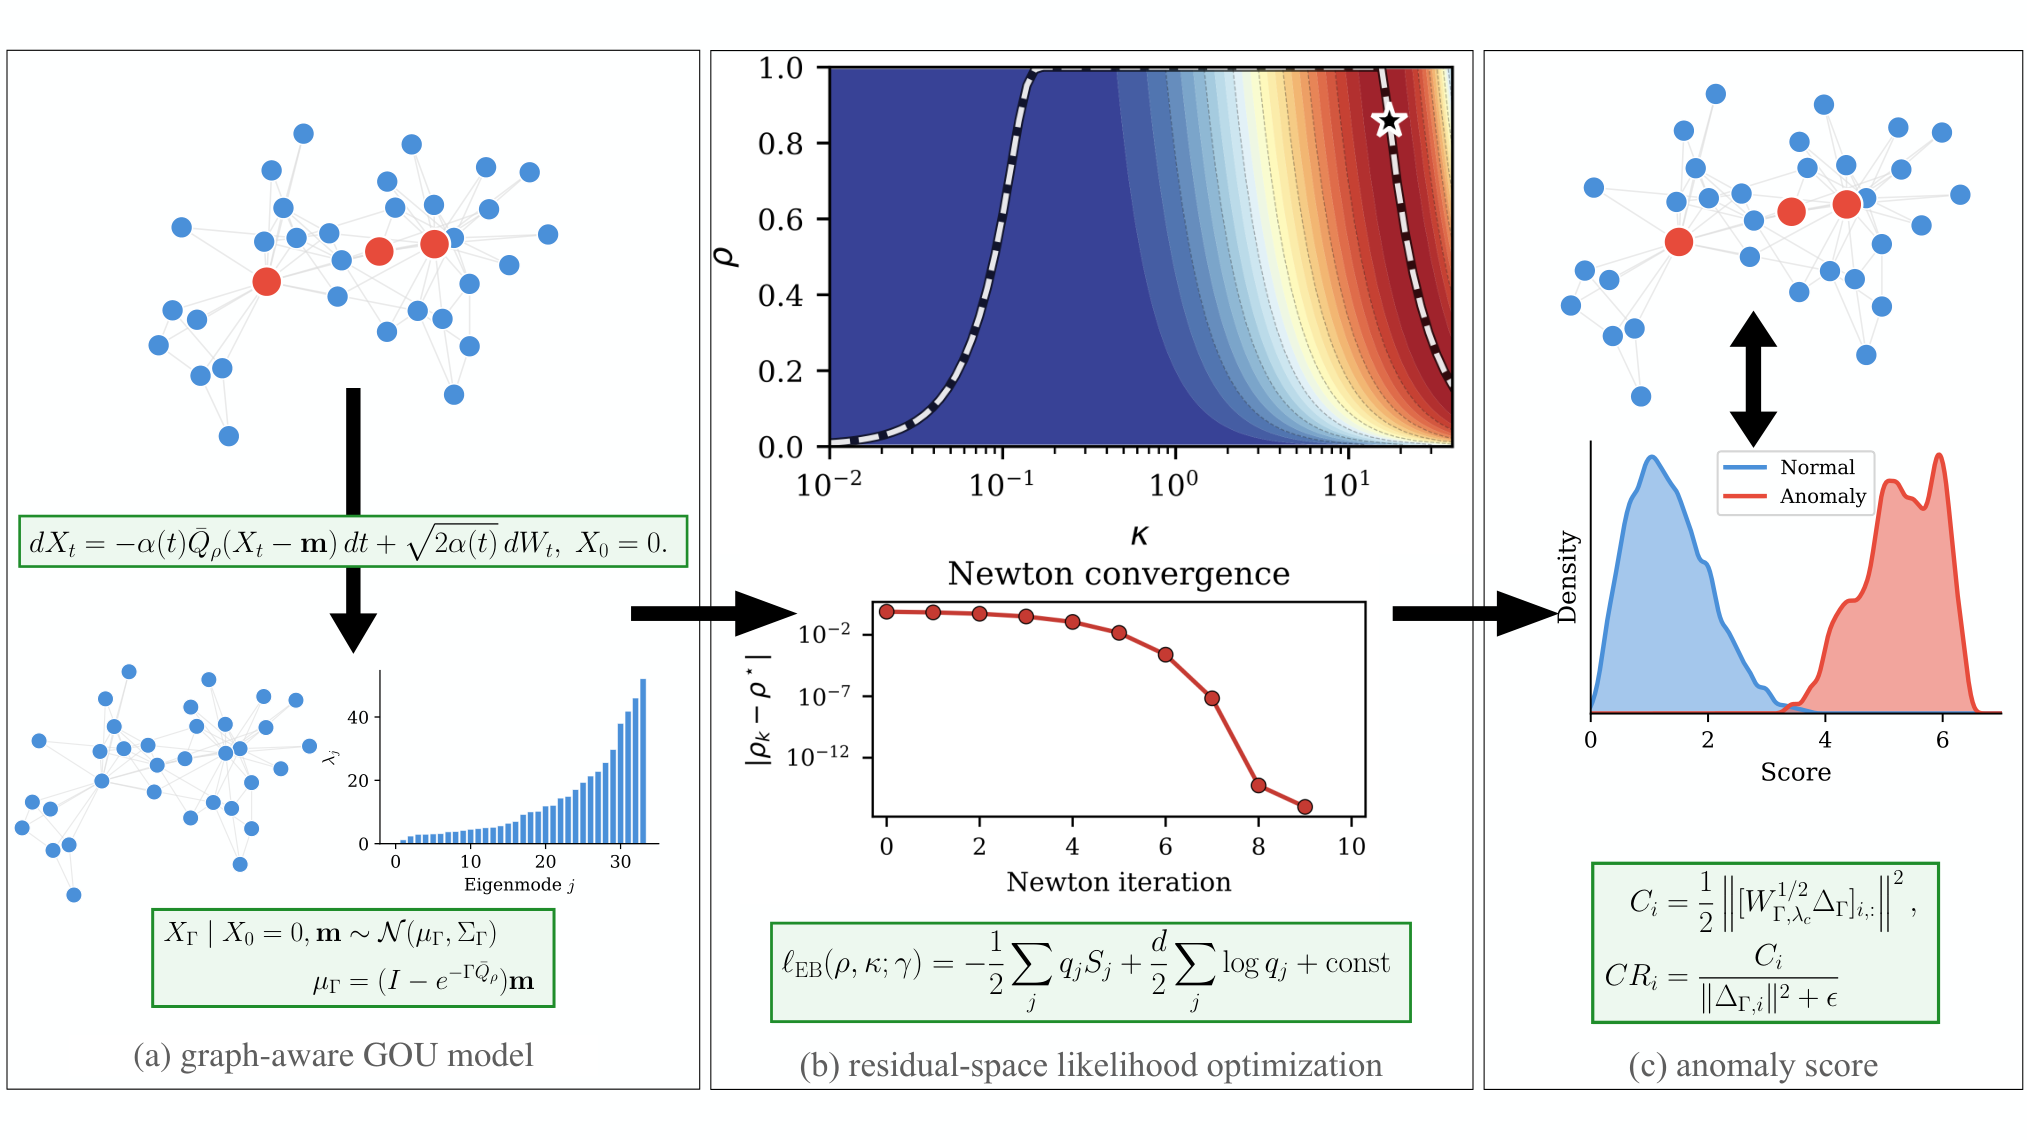
Работа UCLA, Block и Mila рассматривает граф с признаками узлов: например, сеть переводов, где у каждого счёта есть числовые характеристики. EB-GAD сначала пропускает признаки через низкочастотный графовый фильтр. Он создаёт шаблон нормы, в котором связанные и похожие узлы должны меняться плавно.
Разница между исходными признаками и шаблоном образует поле остатков. По нему метод подгоняет три скалярных параметра: доверие к связям графа, характерный масштаб изменений вдоль графа и ширину фильтра шаблона. Для этого используется эмпирический байесовский подход: параметры выбираются по правдоподобию всех неразмеченных данных.
Расчёт опирается на предположение, что нормальных узлов больше, чем аномальных. Тогда общую модель определяет основная масса данных, а редкие отклонения получают низкую вероятность. «Без обучения» здесь означает отсутствие нейронных весов, градиентного спуска и эпох, но не отсутствие настройки: параметры всё равно вычисляются по графу, а кандидаты перебираются на заранее заданных сетках.
После подгонки метод оценивает, сколько условного усилия нужно, чтобы привести нейтральный узел к наблюдаемым признакам с учётом связей и шаблона. Динамика Орнштейна — Уленбека здесь не описывает реальную историю узла. Это математический способ получить несколько согласованных оценок из одной модели нормы.
Один приор даёт несколько способов найти отклонение
Короткий горизонт выделяет узлы, признаки которых трудно получить до полного приближения к шаблону. Длинный горизонт переходит к равновесной оценке Махаланобиса, которая учитывает величину и направление отклонения. Нормированные варианты отделяют необычную структуру остатка от его общего масштаба.
Выбирать лучший вариант по известным ответам нельзя: это превратило бы метод в скрыто контролируемый. Поэтому EB-GAD сначала определяет семейство оценок по однородности признаков на соседних узлах, плотности рёбер и размерности признаков. Внутри семейства он предпочитает оценку, которая сильнее отклоняется от подогнанной модели нормы и сохраняет похожее ранжирование при соседних настройках.
На 9 из 11 наборов EB-GAD показал лучший AUROC или разделил первое место; максимальный отрыв достиг 21,7 процентного пункта. Самый крупный граф содержал до 3,7 млн узлов. На BlogCatalog и ACM метод уступил лидеру и занял следующую позицию.
Проверка охватывает финансовые сети, графы отзывов и социальные графы, включая YelpChi, Amazon, Weibo, Reddit и Facebook. Во всех случаях искали аномалии отдельных узлов в статическом графе с признаками. Метки не участвовали ни в подгонке параметров, ни в выборе итоговой оценки.
EB-GAD меняет план первого запуска, но не весь продукт
Для команды без размеченных инцидентов EB-GAD подходит как стартовая линия: он сразу выдаёт воспроизводимый рейтинг подозрительных узлов и явно показывает, насколько доверяет рёбрам. Это полезнее архитектуры, где влияние графа скрыто внутри слоёв нейросети и меняется вместе с обучением.
В производственном плане всё равно остаются два отдельных решения. Сначала нужно выбрать признаки и построить граф, где ребро имеет содержательный смысл. Затем требуется превратить рейтинг в рабочий порог проверки: AUROC сравнивает порядок объектов, но не определяет, сколько операций отправлять аналитику или блокировать автоматически.
Основная вычислительная часть связана со спектральным разложением графового оператора; на крупных графах авторы используют усечённый спектр. Время работы нельзя напрямую сопоставлять с нейросетевыми базовыми методами: EB-GAD запускали на процессорных потоках, а конкурентов — на GPU, и это не контролируемое сравнение.
При реализации стоит также усреднять позиции одинаковых оценок. В экспериментах привязка ничьих к индексу узла создавала зависимость от порядка данных на YelpChi и Facebook, хотя сам математический метод не должен меняться при перенумерации вершин.
Работа меняет план там, где нужен первый детектор для статического графа без меток: перед обучением GraphSAGE или другой модели можно запустить EB-GAD и понять, даёт ли структура графа полезный сигнал. Если граф постоянно меняется или решение должно работать в потоке, потребуется отдельная схема обновления спектра, параметров и порогов.
Источники
Иллюстрация: рисунок из статьи «Graph Anomaly Detection as Finite-Horizon Control: Training-Free Scoring via Empirical Bayes», Fred Xu, Thomas Markovich, Florence Regol и др., CC BY-SA 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


