
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
KV-кэш длинного контекста научились сокращать без повторной обработки большей части текста и без обучения отдельного оценщика. EchoPress ускорил эту операцию до 19,6 раза относительно KVzip; в нерецензированном препринте EPFL эти числа получили сами авторы. Метод снижает задержку там, где один подготовленный контекст используют для нескольких вопросов или продолжений диалога.
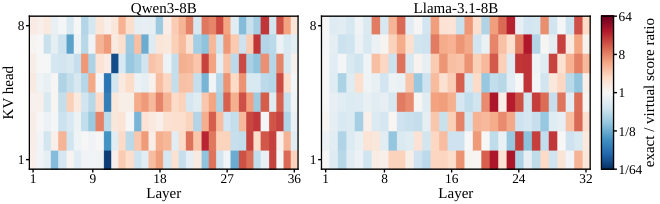
KV-кэш хранит ключи и значения, которые модель рассчитала для предыдущих токенов. KVzip определяет важные записи, заставляя модель воспроизводить контекст по частям, а EchoPress берёт запросы и ключи из первичной обработки контекста (prefill), корректирует их позиции и рассчитывает приближённые оценки. Точно воспроизводится только первый фрагмент: по нему метод калибрует оценки для каждого слоя и головки внимания без внешних примеров и параметров, обученных под конкретную модель.
При контексте в 128 тысяч токенов накладное время сокращения кэша Qwen3-8B уменьшилось в 19,6 раза, а полное время первичной обработки — в 2,94 раза. При удалении от половины до трёх четвертей записей EchoPress отставал от KVzip не более чем на 0,9 пункта, а при удалении 90% оказался точнее во всех четырёх сочетаниях модели и основного бенчмарка.
Метод проверяли на Qwen3-8B и Llama-3.1-8B-Instruct в LongBench и RULER. Точность измеряли на контекстах до 64 тысяч токенов, а время — до 128 тысяч на одной GPU A100 с 80 ГБ памяти; сравнение проводили с KVzip при одинаковой программной основе. Средние результаты скрывают отдельные просадки: EchoPress уступал KVzip в задачах LongBench на продолжение кода при высокой доле удалённых записей.
EchoPress сокращает только кэш подготовленного контекста. Во время генерации новые записи продолжают накапливаться, поэтому метод не заменяет управление памятью для длинных ответов. Его прямой сценарий — заранее сжать общий контекст и повторно использовать его для разных запросов, не оплачивая полное воспроизведение при каждом сжатии.
Источники
Иллюстрация: рисунок из статьи «EchoPress: Query-Agnostic KV Cache Pruning via Virtual Context Reconstruction», Jiawei Lin, Saibo Geng, Thomas Bourgeat, CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


