
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
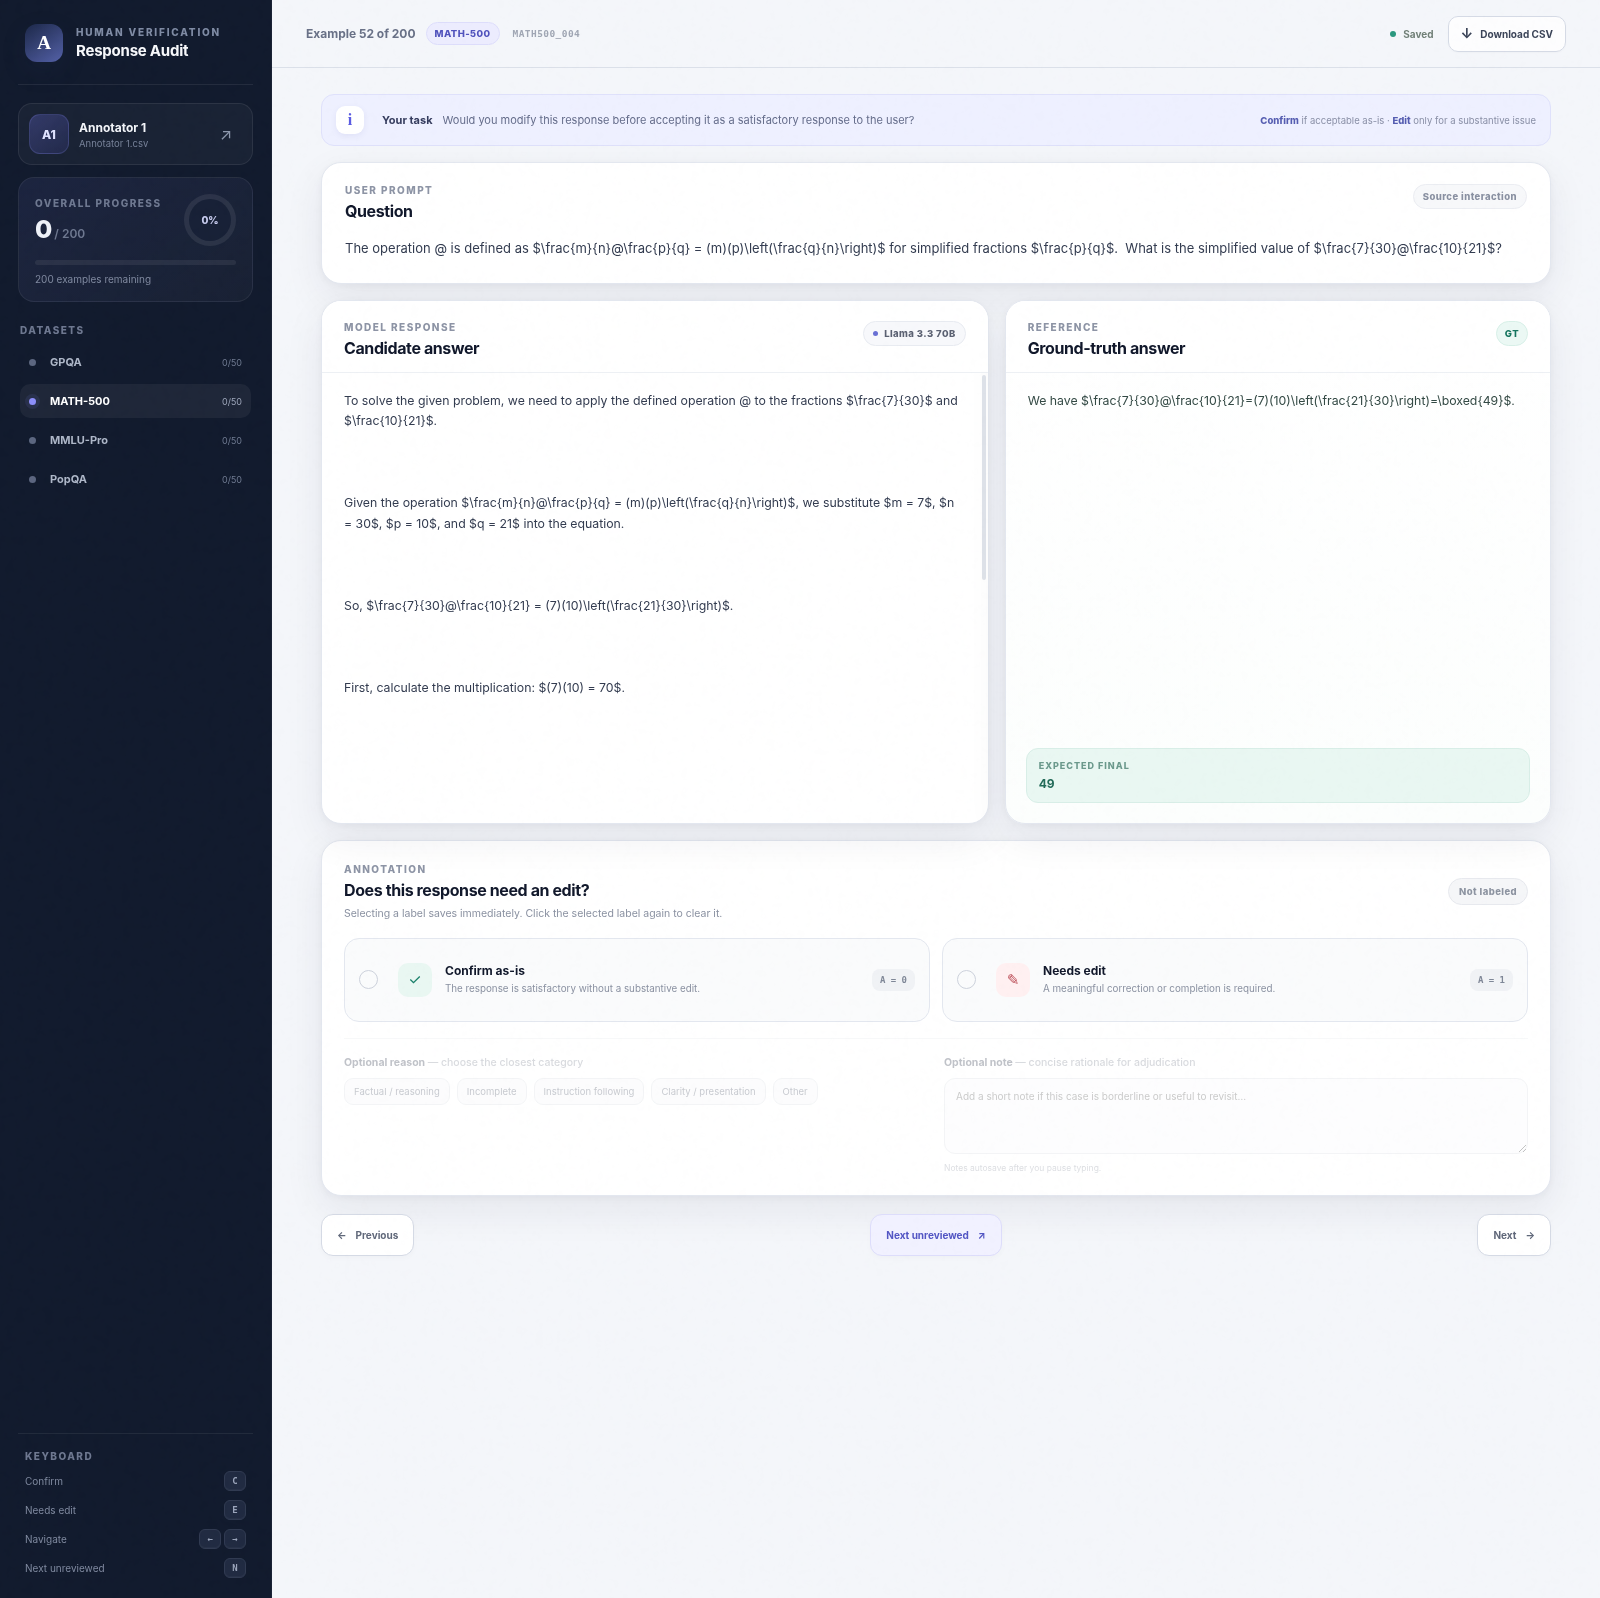
Проверять дорогим редактором можно не все ответы модели: алгоритм EDIT учится отправлять ему те, которые с большей вероятностью придётся исправить. В препринте EPFL и University of Pennsylvania, который не прошёл рецензирование, числа получили сами авторы: EDIT пропустил меньше нужных исправлений, чем прямая пакетная выборка с помощью LLM, на всех четырёх наборах задач. Для продуктовой команды это превращает фиксированный бюджет проверки в управляемое правило отбора.
Алгоритм разделяет вероятность ошибки и стоимость проверки
Редактором в работе называют любой более компетентный процесс проверки. Это может быть эксперт, более сильная модель или та же модель с дополнительным контекстом, инструментами и временем на вычисления.
Редактор либо подтверждает ответ без изменений, либо исправляет его. Во втором случае команда получает пример сбоя и готовую корректировку, которую можно использовать как данные для последующего обучения. Но результат проверки заранее неизвестен, а вызов редактора расходует деньги, время или допустимую задержку.
Авторы формулируют выбор как баланс между двумя ошибками. Если система отправляет слишком много хороших ответов, редактор тратит ресурс на подтверждения. Если отбирает слишком строго, она пропускает ответы, которые стоило исправить.
В идеальном случае решение зависит от вероятности будущего исправления и известной стоимости проверки. Ответ отправляют редактору, когда эта вероятность превышает общий порог с надбавкой за стоимость. Поэтому длинный разбор или запрос к дорогому эксперту должен обещать больше пользы, чем короткая фактическая проверка.
На практике истинная вероятность неизвестна. EDIT заменяет её оценкой, обновляет порог по уже полученной обратной связи и отдельно регулирует расход бюджета. Правило выбора остаётся тем же: при равных затратах выше проходят ответы с большим риском исправления, а при равном риске — более дешёвые.
Частичная обратная связь не ломает контроль бюджета
Главная сложность возникает после запуска. Система узнаёт, требовалось ли исправление, только у выбранных ответов. Для пропущенных ответов метка остаётся скрытой, хотя именно среди них нужно оценивать долю потерянных исправлений.
EDIT работает с потоком пакетов. Для каждого ответа он вычисляет оценку вероятности исправления, затем выбирает элементы в пределах доступного ресурса. После проверки алгоритм видит подтверждения и правки, обновляет оценку и сдвигает порог для следующего пакета.
Один регулятор удерживает допустимую долю бесполезных подтверждений среди выбранных ответов. Другой повышает требования к дорогим элементам, пока пакет не укладывается в лимит. Бюджет соблюдается на каждом шаге, а средняя доля подтверждений остаётся около заданного уровня с поправкой, которая уменьшается по мере работы.
Алгоритму не требуется предполагать, что запросы приходят из неизменного распределения. Это полезно для продуктовых потоков, где меняются темы, пользователи и сложность запросов. При этом качество отбора всё равно зависит от оценки вероятности исправления: контроллер распределяет ресурс, но не превращает слабый оценщик в точный.
Результаты поддерживают пилот, но не доказывают пользу переобучения
EDIT проверяли на MATH-500, MMLU-Pro, PopQA и GPQA с ответами Llama-3.3-70B-Instruct и дополнительными опытами на Qwen3-32B. Основной протокол состоял из 250 раундов по 10 ответов, а редактор мог обработать до 5 элементов в каждом раунде.
Вариант EDIT-REP, который ранжировал ответы по их представлениям в отдельной модели, показал самый низкий итоговый процент пропущенных исправлений на всех проверенных наборах. По сравнению с LLM-Select, где LLM напрямую выбирала элементы из пакета, он также устойчивее удерживал допустимую долю подтверждений. Случайная оценка и оценка самой LLM работали хуже, что указывает на важность отдельного предиктора риска.
Для архитектуры продукта работа предлагает явное разделение ролей: основная модель отвечает, оценщик прогнозирует необходимость правки, контроллер применяет пороги и бюджет, редактор выдаёт окончательный вариант. Оценщик при этом можно заменить, не меняя правило распределения ресурсов.
Такой подход меняет планы команд, у которых уже есть повторяющийся поток ответов, дорогая проверка и журнал правок. Вместо проверки случайной доли или просьбы к LLM самой выбрать «сомнительные» ответы можно задать допустимую долю пустых проверок, стоимость каждого случая и лимит на пакет. История решений редактора становится обратной связью для следующего отбора.
Проверка охватывала задачи на рассуждение и фактические ответы, а метки строились по эталонным ответам и подтверждались ограниченным аудитом 200 примеров. Работа оценивает, насколько хорошо алгоритм находит правки, но не измеряет, улучшит ли обучение на этих правках следующую версию модели. Поэтому результат обосновывает пилот системы отбора, а не обещание роста качества продукта после переобучения.
Источники
Иллюстрация: рисунок из статьи «Edit Discovery in Human-AI Interactions», Alireza Mirrokni, Shayan Kiyani, George Pappas и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


