
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Англоязычные отраслевые документы научились превращать в проверяемые задания для обучения LLM на других языках. Это показала команда NAVER Cloud и KAIST AI в нерецензированном препринте, где числа получены самими авторами: смешанные по языку задания обошли сопоставимую двуязычную выборку. Для команд это способ использовать накопленные английские материалы без ручной разметки каждого ответа на целевом языке.
Как сырой текст получил автоматически проверяемый ответ
Обучение с подкреплением и автоматически проверяемой наградой (RLVR) требует заданий, ответ на которые можно проверить без человека. Для математики подходит точное число, для программирования — результат выполнения кода. В медицине или кибербезопасности исходные данные чаще выглядят как статьи и руководства, где готового проверяемого ответа нет.
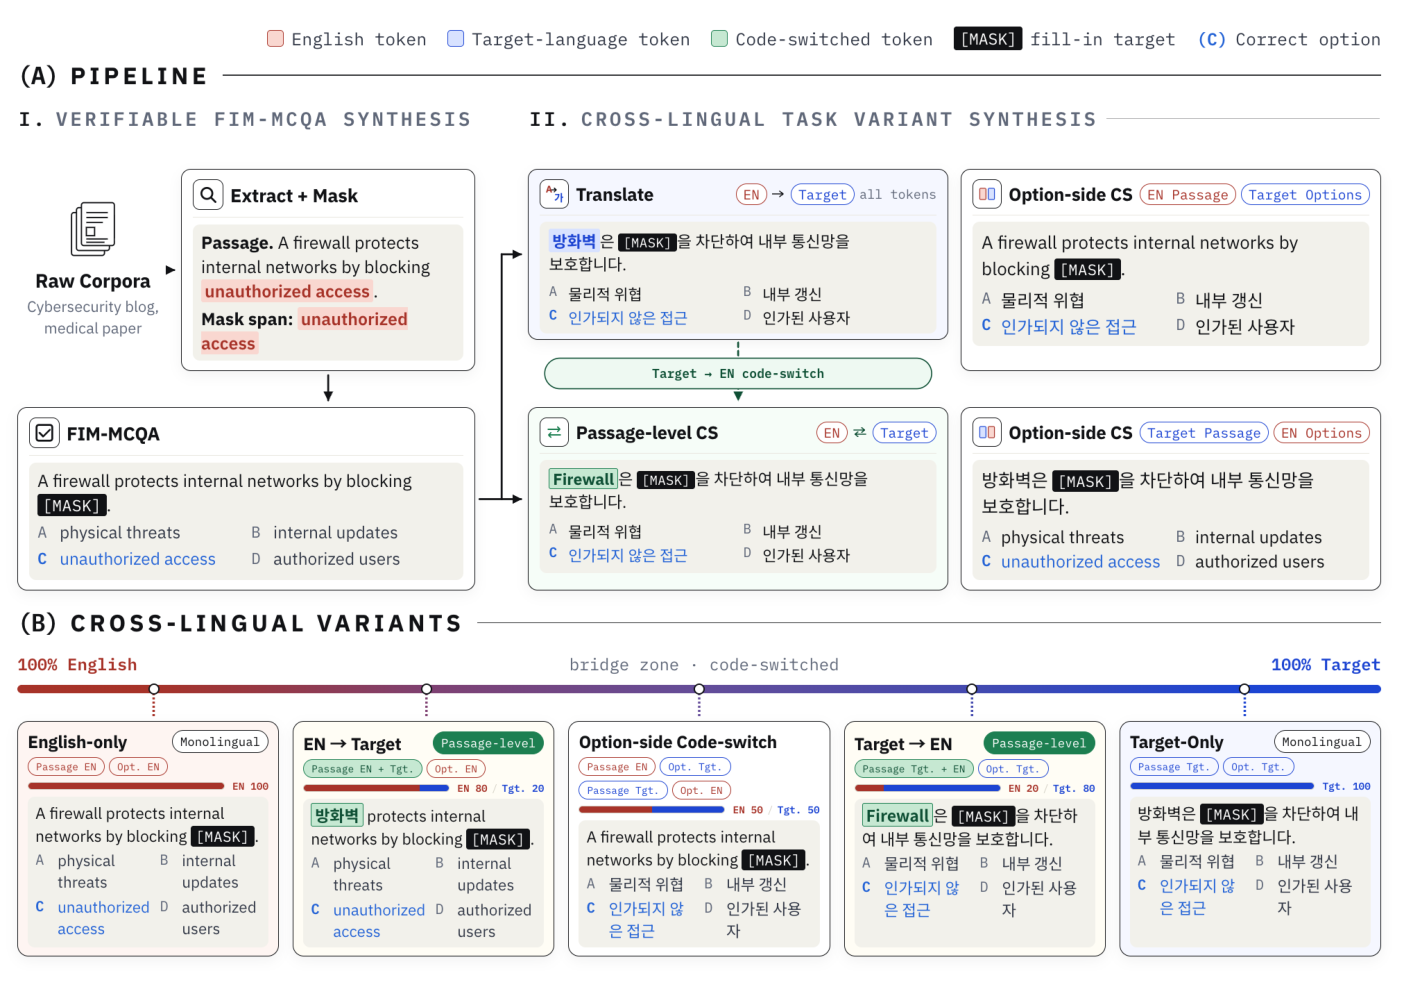
Авторы превращают такой документ в задание с выбором ответа. Сначала модель извлекает самостоятельный фрагмент текста, затем выбирает в нём непрерывный отрывок и заменяет его меткой пропуска. Удалённый дословный фрагмент становится правильным вариантом, а модель генерирует несколько правдоподобных, но неверных альтернатив того же типа и примерно той же длины.
Отдельная программа проверяет, что правильный ответ действительно встречался в исходном фрагменте. Если модель перефразировала его или выбрала отсутствующий текст, пример создают заново либо отбрасывают. Награда после этого сводится к проверке номера выбранного варианта, поэтому для обучения не нужна другая LLM в роли оценщика.
Из английского задания делают перевод и два вида смешанных примеров. В первом отрывок остаётся на одном языке, а варианты ответа переходят на другой. Во втором языки чередуются внутри самого отрывка: часть смысловых фрагментов переводят, сохраняя пропуск, варианты ответа и связь между свидетельством и правильным ответом.
Смешение строят в обе стороны. Английский текст получает вставки на целевом языке, а переведённый текст — английские. Затем примеры фильтруют по сохранности пропуска, используемому алфавиту, доле целевого языка и корректности границ между языками.
Отраслевые задания добавляли к общей выборке по естественным наукам, математике, программированию и выполнению инструкций. Обучение только на восстановлении пропущенных фрагментов работало менее стабильно и могло приучить модель к одному формату, поэтому общая выборка служила стабилизатором.
Смешение языков улучшило доступ к английским знаниям
В экспериментах сравнивали английские задания, переведённые задания, смесь двух одноязычных наборов и примеры со смешением языков. Объём отраслевых данных, общая учебная выборка и алгоритм обучения оставались одинаковыми, поэтому менялась прежде всего языковая форма примеров.
На корейских тестах по кибербезопасности SmolLM3-3B со смешанными заданиями опередил двуязычный одноязычный набор в среднем на 5,7 процентного пункта. На суахили, хинди и японском тот же вариант также показал лучший средний результат. В медицинских тестах он лидировал у Qwen2.5-3B-Instruct и Llama 3.2-3B-Instruct, при этом качество английских ответов оставалось сопоставимым.
Дополнительные проверки указывают на механизм переноса. После такого обучения ответы модели чаще совпадали между языковыми версиями одного вопроса, а внутренние представления английского и переведённого текста становились ближе. Модель также лучше восстанавливала смысл входного текста на целевом языке и давала более согласованные рассуждения.
Проверка охватывает модели примерно с 3 млрд параметров, медицину и кибербезопасность. Корейский исследован в обоих направлениях, а суахили, хинди и японский — только в кибербезопасности. Часть тестовых наборов переведена с английского; отдельные корейские медицинские наборы изначально написаны на корейском.
Что меняется в плане разработки
Работа меняет прежде всего план подготовки данных, а не выбор архитектуры. Если у продукта уже есть английские регламенты, справочники или учебные материалы, из них можно собрать проверяемые задания, а затем добавить переводы и смешанные версии. Не требуется вручную писать вопросы и размечать правильные ответы на каждом языке.
Для конвейера понадобятся модель, которая извлекает фрагменты и создаёт ложные варианты, переводчик и строгие программные проверки. Проверять нужно не только наличие правильного ответа, но и сохранность технических идентификаторов, фрагментов кода, алфавита и границ языковых вставок. Иначе автоматически проверяемый ответ останется формально верным, хотя само задание станет неестественным или двусмысленным.
Эксперимент нельзя считать дешёвым: один учебный прогон требовал примерно 2500 часов GPU H100. Из-за этого авторы не перебрали все режимы обучения и ограничились моделями одного масштаба. Для продуктовой команды метод скорее задаёт направление пилота на узком домене, чем готовую конфигурацию для полного переобучения.
Результаты получены в заданиях с выбором ответа, поэтому они не доказывают такой же прирост в свободных консультациях, составлении документов или работе агента. Перед внедрением всё равно нужен целевой тест на реальных запросах. Но если главный дефицит — не английские знания, а проверяемые примеры на другом языке, смешение языков становится отдельной альтернативой простому переводу датасета.
Источники
Иллюстрация: рисунок из статьи «From Unverifiable Domain Text to Cross-Lingual RLVR via Code-Switched Task Synthesis», Cheonbok Park, Jihwan Kim, Shinyoung Joo и др., CC BY-SA 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


