
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Выбор LLM-судьи заметно меняет, чему научится модель при обучении по рубрикам. Работа UC Berkeley, которая не прошла рецензирование и приводит числа самих авторов, показала: ансамбль с учётом уверенности и разногласий обошёл каждого отдельного судью на HealthBench и GPQA Diamond. Для команд это переносит выбор судьи из детали реализации в отдельное решение архитектуры обучения.
Одна рубрика даёт разное обучение с разными судьями
Rubrics as Rewards применяют там, где качество ответа нельзя проверить компилятором, тестом или точным числом. Для каждого запроса задают рубрику с критериями полноты, корректности, стиля или безопасности, а LLM-судья превращает проверку по этим критериям в числовую награду.
Эту награду получает алгоритм GRPO: он сравнивает несколько ответов модели на один запрос и усиливает варианты с более высокой оценкой. Поэтому систематическая склонность судьи предпочитать длинные, осторожные или определённым образом сформулированные ответы постепенно меняет саму обучаемую модель.
Авторы зафиксировали рубрики и способ обучения, но меняли судью между gpt-4o-mini, DeepSeek-V3.1, Gemini-2.5-flash-lite, Qwen3-235B-Instruct и gpt-oss-120b. На HealthBench итоговые оценки обученных вариантов Qwen3-4B-Base разошлись от 0,296 до 0,339, а на GPQA Diamond — от 0,345 до 0,406. Худший судья мог свести на нет пользу дообучения, хотя входные данные и рубрики оставались прежними.
Судья влиял не только на правильность. При обучении с gpt-oss-120b заданного предела длины достигли 97% ответов: модель научилась получать награду за объём. Штраф за длину и обучение через LoRA ослабили этот эффект, поэтому длину ответа стоит контролировать отдельно от основной метрики.
Как RaRE учитывает уверенность и разногласия
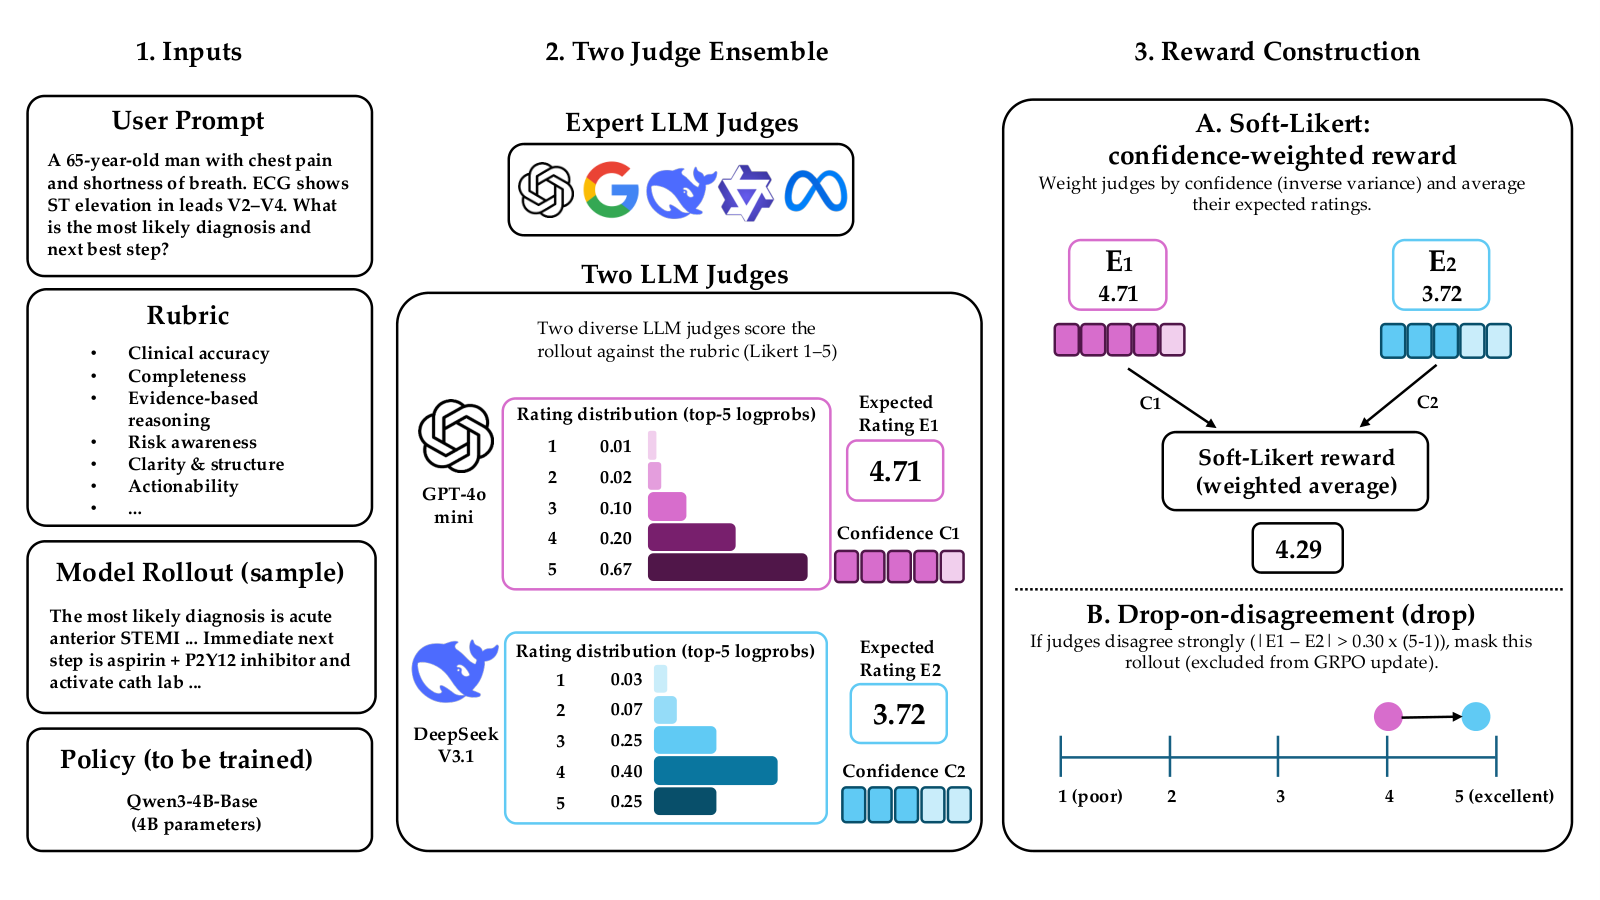
Предложенный метод RaRE передаёт каждый ответ паре судей. Простое среднее их целочисленных оценок не превзошло лучшего одиночного судью, поэтому авторы добавили два разных способа работать с неопределённостью.
Первый способ использует не только выбранную оценку, но и распределение вероятностей по всем допустимым оценкам пятибалльной шкалы. Если вероятность сосредоточена около одного значения, судья получает больший вес. Если она распределена между несколькими вариантами, его вклад уменьшается. В результате награда остаётся непрерывной и отражает степень уверенности, а не только итоговую цифру.
Для этого API судьи должен возвращать вероятности токенов. В опытах такую схему применяли к паре DeepSeek-V3.1 и GPT-4o-mini. Если конечная точка API не отдаёт эти значения, RaRE может работать с обычными целыми оценками, но тогда теряет взвешивание по уверенности.
Второй способ отслеживает расхождение между судьями. Когда они оценивают ответ слишком по-разному, RaRE заменяет его награду средним значением по остальной группе. После нормализации такой ответ получает нулевое преимущество и не влияет на обновление модели. Метод не пытается решить, кто прав, а исключает спорный сигнал из шага обучения.
Эти механизмы решают разные задачи. Взвешивание снижает влияние неуверенного судьи, а фильтр убирает ответы, по которым уверенные судьи не согласны друг с другом. Вместе они сработали лучше, чем каждый механизм по отдельности.
Меняет ли работа планы команд
На HealthBench лучший вариант RaRE получил 0,364 против 0,339 у лучшего одиночного судьи. На GPQA Diamond результат составил 0,412 против 0,406, но эта разница оказалась в пределах статистической погрешности. Поэтому работа убедительнее показывает пользу ансамбля в медицинском наборе, чем в научном.
Проверка охватывает одну базовую модель — Qwen3-4B-Base — и два направления: медицинские ответы на HealthBench и научные вопросы на GPQA Diamond. HealthBench оценивал GPT-4o-mini, который также входил в один из обучающих ансамблей, однако повторная проверка через GLM-5.3-Flash сохранила порядок вариантов. GPQA Diamond проверяет ответы без LLM-судьи и частично снимает эту зависимость.
Для команд, которые строят обучение по субъективным критериям, практический план меняется в трёх местах. Сначала следует сравнить несколько судей при неизменной рубрике, а не выбирать модель только по общему рейтингу. Затем можно собрать пару судей с разными сильными сторонами и фильтровать их разногласия. Если API возвращает вероятности токенов, к этому добавляется взвешивание по уверенности.
RaRE потребует второго вызова судьи для каждого обучающего ответа, а спорные примеры перестанут давать обучающий сигнал. Этот расход имеет смысл проверять на собственной задаче: работа не показывает перенос на другие семейства моделей, масштабы и предметные области. Для математики и кода с точной автоматической проверкой она также не даёт причины заменять проверяемую награду ансамблем LLM.
Источники
Иллюстрация: рисунок из статьи «Judging the Judges: Confidence and Disagreement in Rubrics as Rewards», Michael Tian-Yue Liu, Anne Harrington, Trevor Darrell и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


