
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
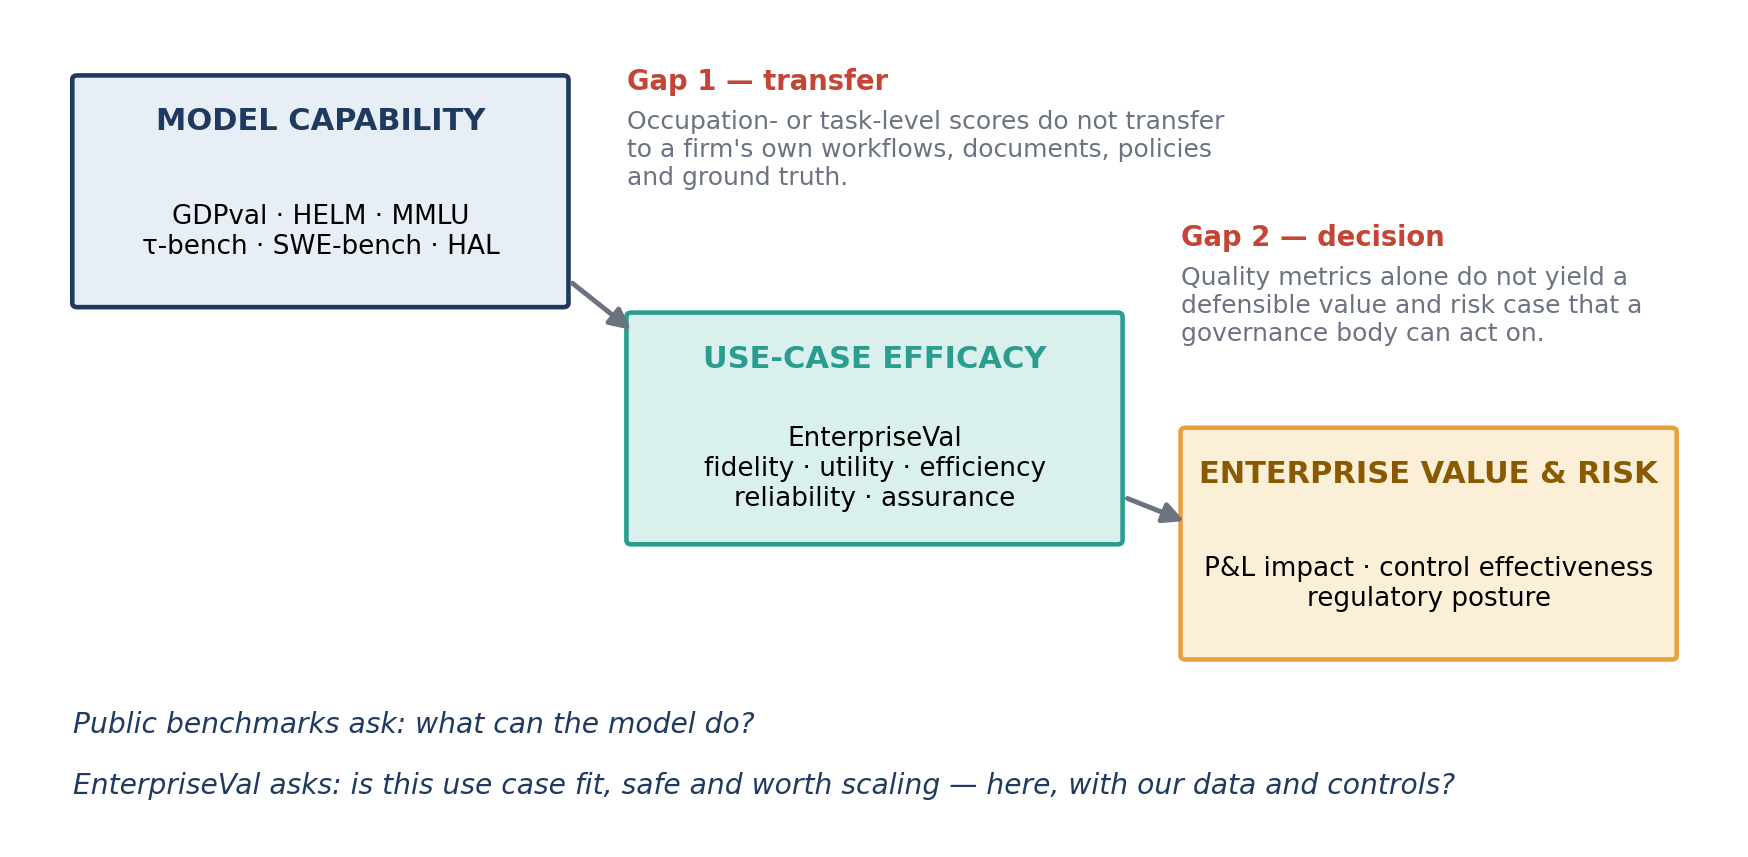
Проверку корпоративного ИИ связали с решением: отклонить сценарий, доработать его или расширять. В нерецензированном препринте, где все числа получили сами авторы, Abbas Raza Ali, Muhammad Ajmal Siddiqui и Moona Zahid проверили подход EnterpriseVal на трёх процессах глобального банка. Для команд это переносит центр оценки с модели на весь рабочий контур, включая поиск данных, инструменты и работу проверяющего.
Как рабочий процесс превращают в объект оценки
EnterpriseVal начинает не с выбора бенчмарка, а с описания сценария. Команда фиксирует типовые задания, разрешённые источники, эталонные результаты и правила проверки. Одновременно она указывает, что система вправе делать сама и к каким последствиям приведёт ошибка.
Отдельно замораживают конфигурацию: модель и её настройки, подсказки, поиск по корпоративным данным, память, инструменты, защитные правила, журналирование и участие человека. Если команда меняет любой из этих компонентов, результат прошлой оценки больше не относится к новой версии. Одинаковая модель с обязательным согласованием и без него считается двумя разными системами.
Автономия меняется от ответов и подготовки черновика до действий в корпоративных системах. Последствия — от обратимой внутренней ошибки до финансового, клиентского или регуляторного ущерба. Их сочетание задаёт строгость проверки: для черновика достаточно оценки содержания и работы редактора, а автономному сценарию нужны повторные запуски, разбор траекторий, испытания на атаки и производственный мониторинг.
Метрики охватывают точность относительно источников, практическую полезность, затраты, стабильность повторных запусков, соблюдение правил и качество человеческого контроля. Последний пункт принципиален: наличие проверяющего само по себе не считается защитой. EnterpriseVal предлагает подмешивать известные дефекты и измерять, какую долю из них человек действительно замечает.
Экспертная проверка остаётся основой, но её можно расширить моделью-оценщиком. Модель размечает весь набор, эксперты — случайную часть, после чего её систематическую ошибку статистически вычитают из общего результата. Такой порядок не позволяет выдать автоматическую оценку за человеческую.
Как метрики превращаются в решение
Для каждой обязательной метрики заранее задают внутренний и внешний пороги. Порог нельзя выбирать после просмотра результатов: иначе команда сможет подогнать критерий под уже выбранную модель. Решение принимают по консервативной границе доверительного интервала, а не по среднему значению.
Если все обязательные показатели проходят внутренние пороги, сценарий можно масштабировать. Если хотя бы один показатель не достигает внешнего порога, его отклоняют. Промежуточный результат означает условный допуск: команда ограничивает область применения, добавляет контроль или исправляет конфигурацию и запускает оценку снова.
Средний балл не может скрыть критический провал. Высокая полнота документа не компенсирует выдуманные ссылки, а экономия времени — пропущенное обязательное требование. Сводный индекс нужен для сравнения прошедших вариантов, но не заменяет обязательные пороги.
Экономическую часть считают после качества. Из сэкономленного времени и прямых затрат вычитают проверку, исправления и ожидаемый ущерб от ошибок, которые не заметит контролёр. Поэтому скорость генерации сама по себе не доказывает ценность процесса.
Что пилот меняет в планах внедрения
В подготовке кредитных заключений лучший вариант достиг точности цитирования 88% при доле неподтверждённых утверждений 1,6%. При преобразовании внутренних процедур оценка времени на доведение документа до готовности сократилась с 27,4 до 2,9 часа. Во втором случае исходную трудоёмкость вспоминали сотрудники, а не измеряли таймером, поэтому результат подходит для выбора следующего эксперимента, но не для расчёта окупаемости.
Пилот проходил в одном банке, на небольших наборах рабочих документов и одной генерации моделей. Он показывает, что подразделения могут описать собственные эталоны, метрики и пороги, но не доказывает перенос результатов на другие компании. Повторяемость запусков, согласие экспертов и фактический экономический эффект ещё предстоит проверить в более строгом протоколе.
Работа не даёт основания менять поставщика модели по результатам банковского пилота. Она меняет порядок проекта: сначала команда описывает сценарий и цену ошибки, затем фиксирует пороги, собирает эталонные задания и только после этого сравнивает конфигурации. Публичный бенчмарк при таком подходе сокращает список кандидатов, но не разрешает запуск.
Для раннего помощника часть процедуры может оказаться избыточной. Она становится полезнее там, где система готовит документы по внутренним источникам, вызывает инструменты, меняет записи или влияет на решения сотрудников. Чем больше автономии получает сценарий, тем меньше смысла оценивать только финальный ответ.
Практический вывод — хранить протокол оценки рядом с версией рабочего контура. В него входят набор заданий, настройки, результаты экспертов, пороги и правила повторного допуска. Тогда обновление модели, подсказки или поиска становится проверяемым изменением системы, а не незаметной заменой одного компонента.
Источники
Иллюстрация: рисунок из статьи «EnterpriseVal: Quantifying the Efficacy, Reliability and Value of Generative AI in the Enterprise», Abbas Raza Ali, Muhammad Ajmal Siddiqui, Moona Zahid, CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


