
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Чекпойнт языковой модели можно заранее подготовить так, чтобы он лучше учился на собственных ответах уже на целевых задачах. Zhanming Zhang и Vinoth Selvendran выяснили на Qwen3-4B: чем ниже исходная энтропия ответов, тем эффективнее проходит дальнейшая адаптация, хотя работа не рецензирована и все числа получили сами авторы. Поэтому выбирать чекпойнт только по точности до адаптации недостаточно.
Обучение с подкреплением во время тестирования (test-time reinforcement learning, TTRL) использует задачи без размеченных ответов: модель генерирует несколько решений, определяет преобладающий ответ и учится на этом сигнале. Если вероятности сильно распределены между разными продолжениями, модель хуже согласуется сама с собой и тратит часть короткого обучения на концентрацию ответов.
Подготовка входного состояния должна заранее уменьшить этот разброс. Его измеряют энтропией токенов, а результат — эффективностью преобразования: отношением средней точности к доле задач, где хотя бы одно из нескольких решений оказалось верным. Низкая энтропия предсказывала порядок чекпойнтов по этой метрике даже с поправкой на исходную способность находить правильный ответ.
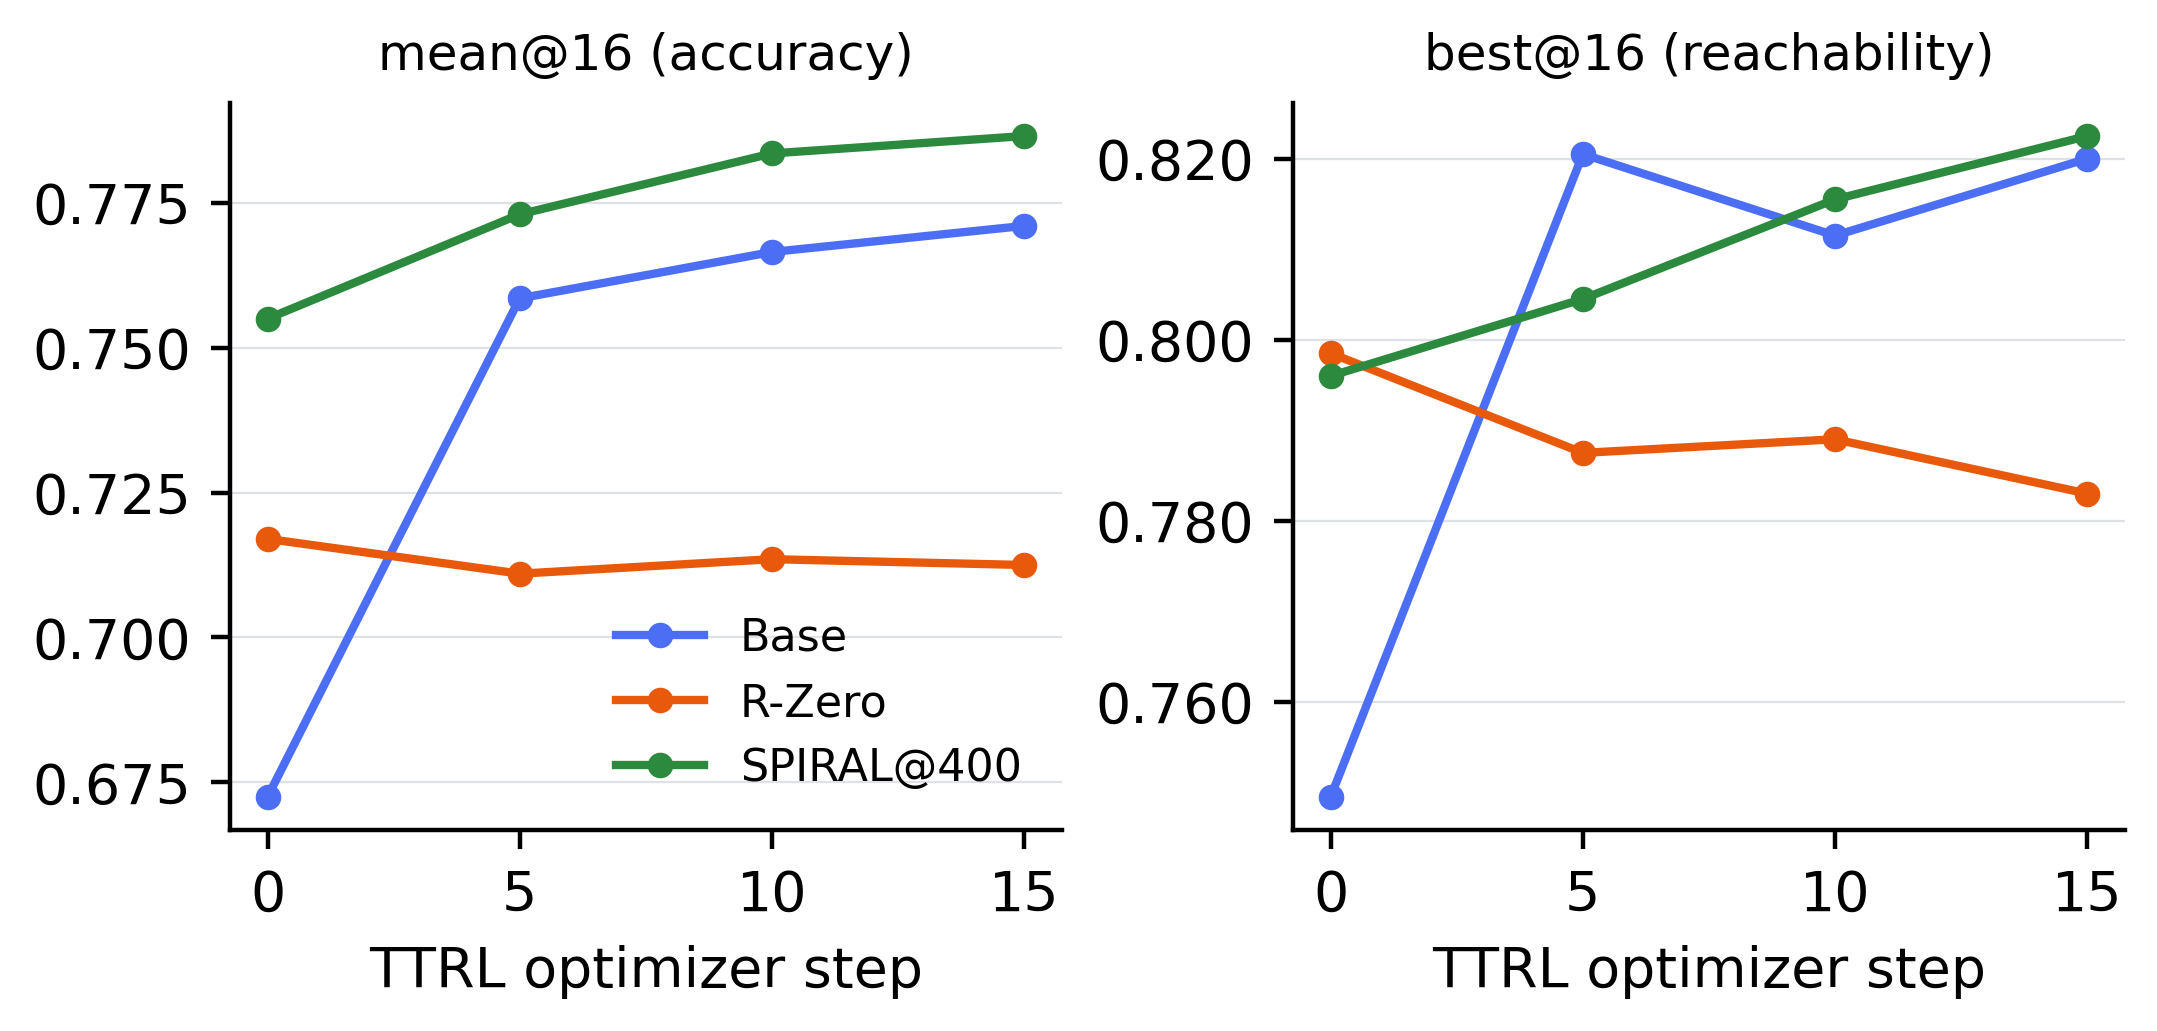
Разные способы обучения без внешних данных дали противоположный результат. У R-Zero энтропия составила 3,39 ната, и после адаптации он уступил базовой модели во всех шести сопоставлениях. У SPIRAL она снизилась до 0,07 ната; этот чекпойнт показал лучшую итоговую точность на MATH и GPQA, хотя до этого не обучался на математических данных. Самодистилляция сократила энтропию более чем в шесть раз, но при высокой интенсивности немного сузила набор достижимых решений: минимизировать показатель без контроля нельзя.
Проверка охватила пять чекпойнтов одной модели, три набора задач — MATH, GPQA и AMC — и единый протокол из 15 шагов. Связь сравнивали между чекпойнтами с разной историей обучения, поэтому работа показывает полезный критерий отбора и подготовки, но не доказывает причинный эффект для других семейств моделей или более длинной адаптации.
Источники
Иллюстрация: рисунок из статьи «Sharpen Before You Adapt: Data-Free Entry-State Sharpening for Test-Time Reinforcement Learning», Zhanming Zhang, Vinoth Selvendran, CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


