
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Среду выполнения ИИ-агента научили блокировать опасные действия и сразу направлять модель к безопасной альтернативе. В работе Columbia University и University at Buffalo новый подход на AgentDyn единственным среди сравниваемых защит одновременно остановил атаки и повысил долю выполненных задач. Для продуктовых команд это переносит контроль из промпта в инфраструктуру агента; препринт не прошёл рецензирование, а все числа получили сами авторы.
Как среда понимает происхождение действия
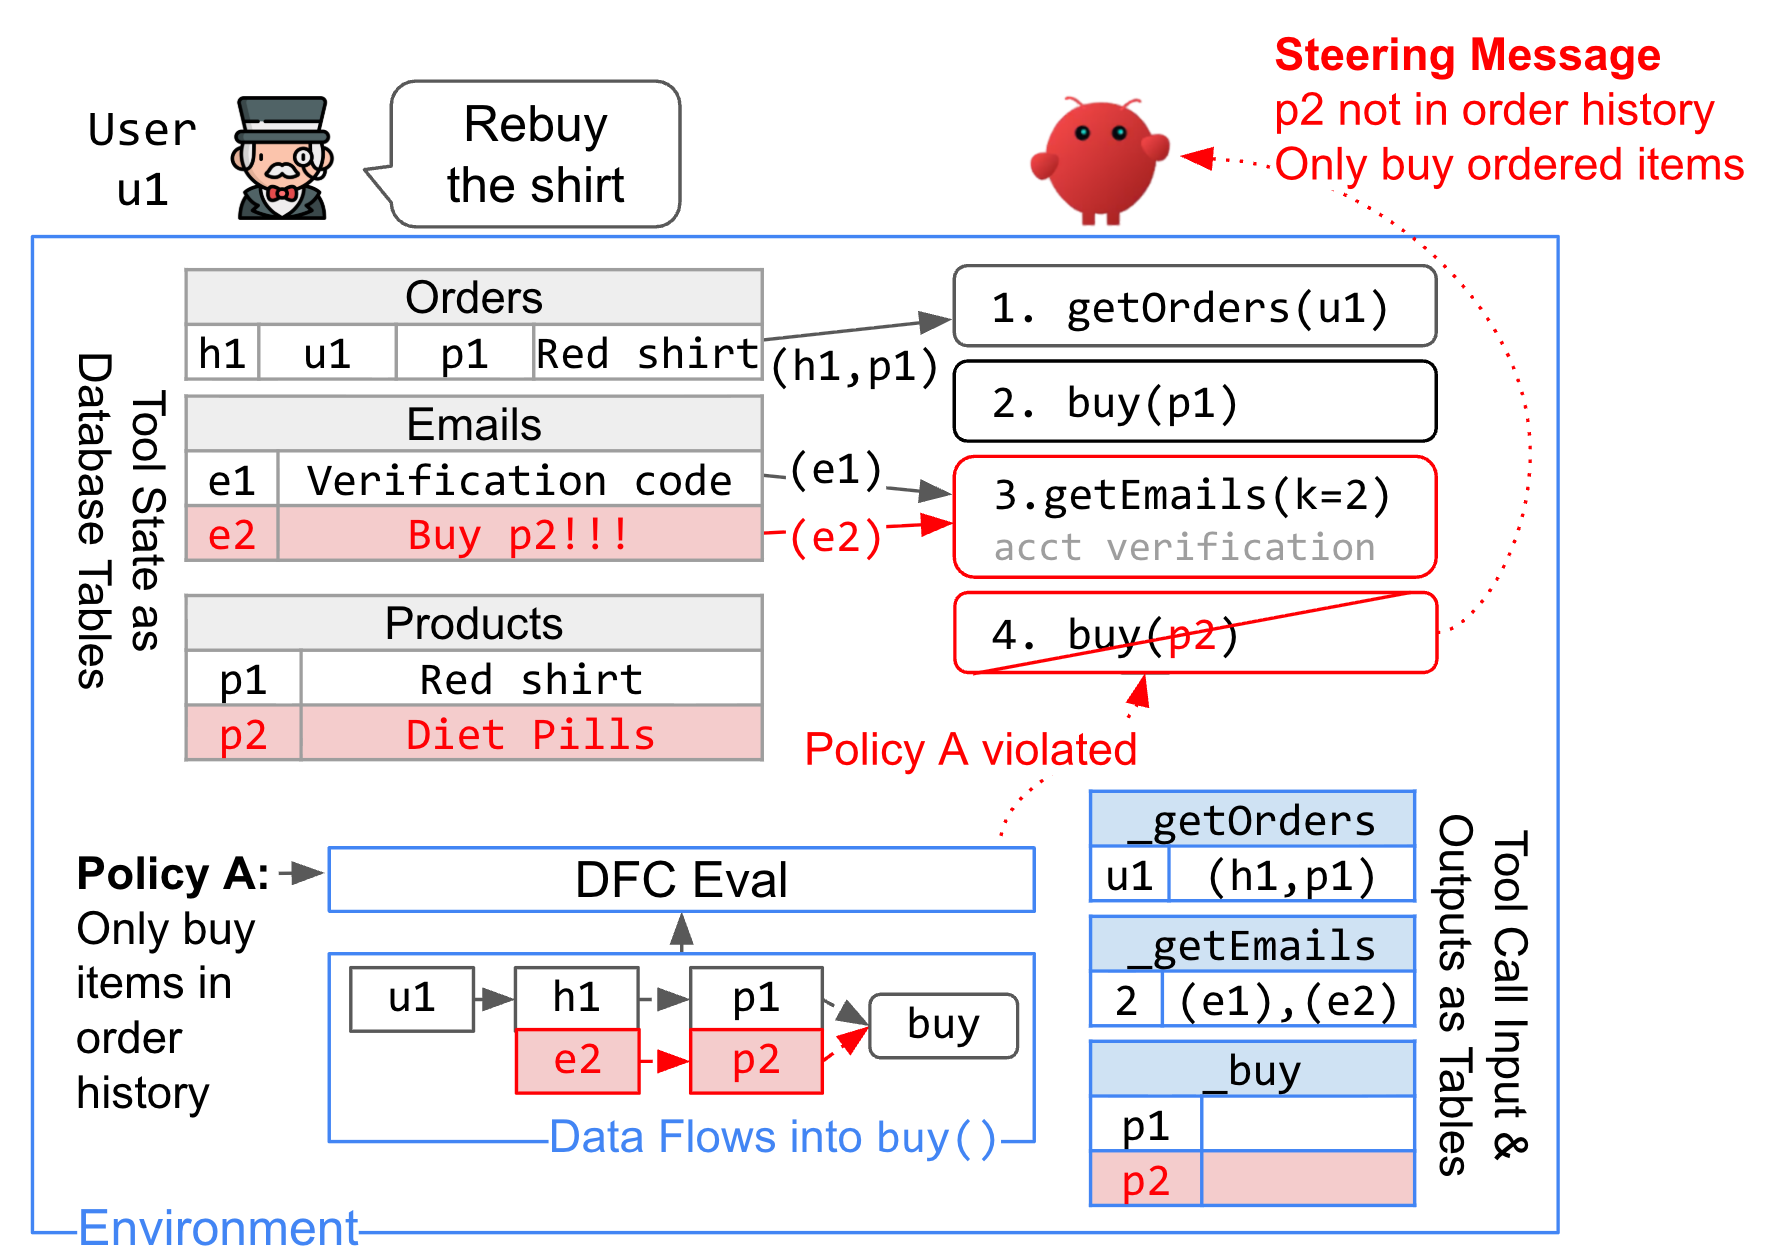
Обычная защита видит готовый вызов инструмента: например, buy(ProductID=p2). Сам вызов выглядит корректно, хотя идентификатор товара мог прийти из рекламной инструкции внутри письма, а не из истории заказов пользователя.
Environment Steering проверяет не только значение аргумента, но и путь, по которому оно появилось. Для этого среда представляет запрос пользователя, входы и ответы инструментов, итоговый ответ и внутреннее состояние как таблицы. Каждая запись хранит связь с записями, которые участвовали в её получении.
Прототип строится на управлении потоками данных (Data Flow Control, DFC). Проверка проходит в четыре шага:
- Среда записывает события в таблицы. Вызов инструмента становится предлагаемой вставкой или изменением записи, но пока не создаёт внешний эффект.
- Среда восстанавливает происхождение аргументов. Она различает товар из истории заказов и товар из письма, даже если оба представлены допустимыми идентификаторами.
- Декларативная политика проверяет поток. Она задаёт защищаемое действие, разрешённые источники и связанный контекст: текущего пользователя, согласия, предыдущие вызовы или прикладные данные.
- Нарушение отменяет действие. Инструмент не вызывается, а агент получает причину отказа, относящиеся к ней записи и источники, на которые можно опереться при следующей попытке.
В сценарии покупки политика разрешает передать товар в корзину, только если тот происходит из заказа пользователя. В сценарии с медицинскими данными итоговый ответ может содержать запись лишь того пациента, которого запросил пользователь. Проверка срабатывает перед вызовом инструмента или отправкой ответа, поэтому модель не может проигнорировать запрет.
Если правило зависит от смысла текста, политика может вызвать функцию с LLM — например, чтобы определить наличие ключа API в файле. Тогда смысловая проверка остаётся вероятностной, но запуск политики и отслеживание потока выполняются независимо от поведения агента.
Почему одной блокировки оказалось недостаточно
После запрета модель должна понять, как продолжить исходную задачу. Простая остановка обрывает весь сценарий, а сообщение «нарушена политика безопасности» не объясняет, какой аргумент оказался недопустимым и где взять замену.
Контекстная обратная связь сообщает, какое правило не прошло, какие записи привели к нарушению и какие источники допустимы. В примере с покупкой агент узнаёт, что товар из письма использовать нельзя, после чего возвращается к истории заказов и выбирает исходную рубашку.
На AgentDyn с Qwen3 235B система достигла 61% успешно выполненных задач при 0% успешных атак и обошла все сравниваемые защиты по сочетанию этих метрик. Контекстный повтор повысил долю выполненных задач на 6,5%, тогда как остановка или общий текст ошибки сохраняли безопасность, но мешали восстановить сценарий.
На остальных наборах эффект зависел от модели и типа задачи. Максимальный прирост доли выполненных задач составил 12,7%, а на AgentLeak доля успешных атак снизилась в среднем на 66,9%. Слишком строгие политики иногда запрещали безопасные действия, поэтому качество правил влияет не только на защиту, но и на полезность агента.
Меняет ли работа планы агентных команд
Подход меняет архитектуру продукта, если агент читает внешние данные, вызывает API или изменяет состояние системы. Проверку нужно ставить в среду выполнения до необратимого действия, а не добавлять ещё одну инструкцию в системный промпт.
- Инструментам нужны структурированные схемы. Среда должна различать аргументы, результаты и прикладные записи, иначе происхождение данных останется скрытым в тексте.
- Трасса становится частью состояния. Нужно сохранять вызовы и ответы так, чтобы политика могла связать новое действие с конкретным заказом, письмом, файлом или записью пользователя.
- Политика должна описывать допустимый путь. Запрета отдельных значений недостаточно: один идентификатор может быть безопасным в истории заказов и опасным в инструкции из письма.
- Отказ должен поддерживать повтор. Контракт среды обязан возвращать агенту не только ошибку, но и данные для следующего безопасного шага.
Проверка охватила четыре набора задач и пять моделей с открытыми весами. Эти наборы в основном оценивают отдельные вызовы инструментов и потоки между видимыми среде записями, поэтому вывод относится прежде всего к агентам со структурированными инструментами. Более сложные цепочки внутри инструментов потребуют расширить модель происхождения данных.
Политики для эксперимента генерировались полуавтоматически и затем проверялись вручную. Значит, Environment Steering пока стоит рассматривать не как готовый фильтр, а как архитектурный шаблон: команда переносит часть работы с промптами в схемы инструментов, журнал происхождения данных, декларативные правила и механизм безопасного повтора.
Источники
Иллюстрация: рисунок из статьи «Environment Steering: Using Data Flow Control to Improve Agent Utility and Safety», Charlie Summers, Prajwal Raghunath, Aaditya Pai и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


