
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Автономный агент научился продолжать исследование после смены модельной сессии, возвращаться к старым гипотезам и накапливать опыт без изменения весов модели. Хотя работу ещё не рецензировали и числа получили сами авторы, Epi показал, что устойчивый исследовательский процесс можно строить вокруг памяти, ветвей и отдельной проверки, а не вокруг одного длинного контекста. Для команд это смещает задачу с выбора модели на устройство среды, где эксперименты можно возобновить и проверить.
Память хранит не переписку, а состояние исследования
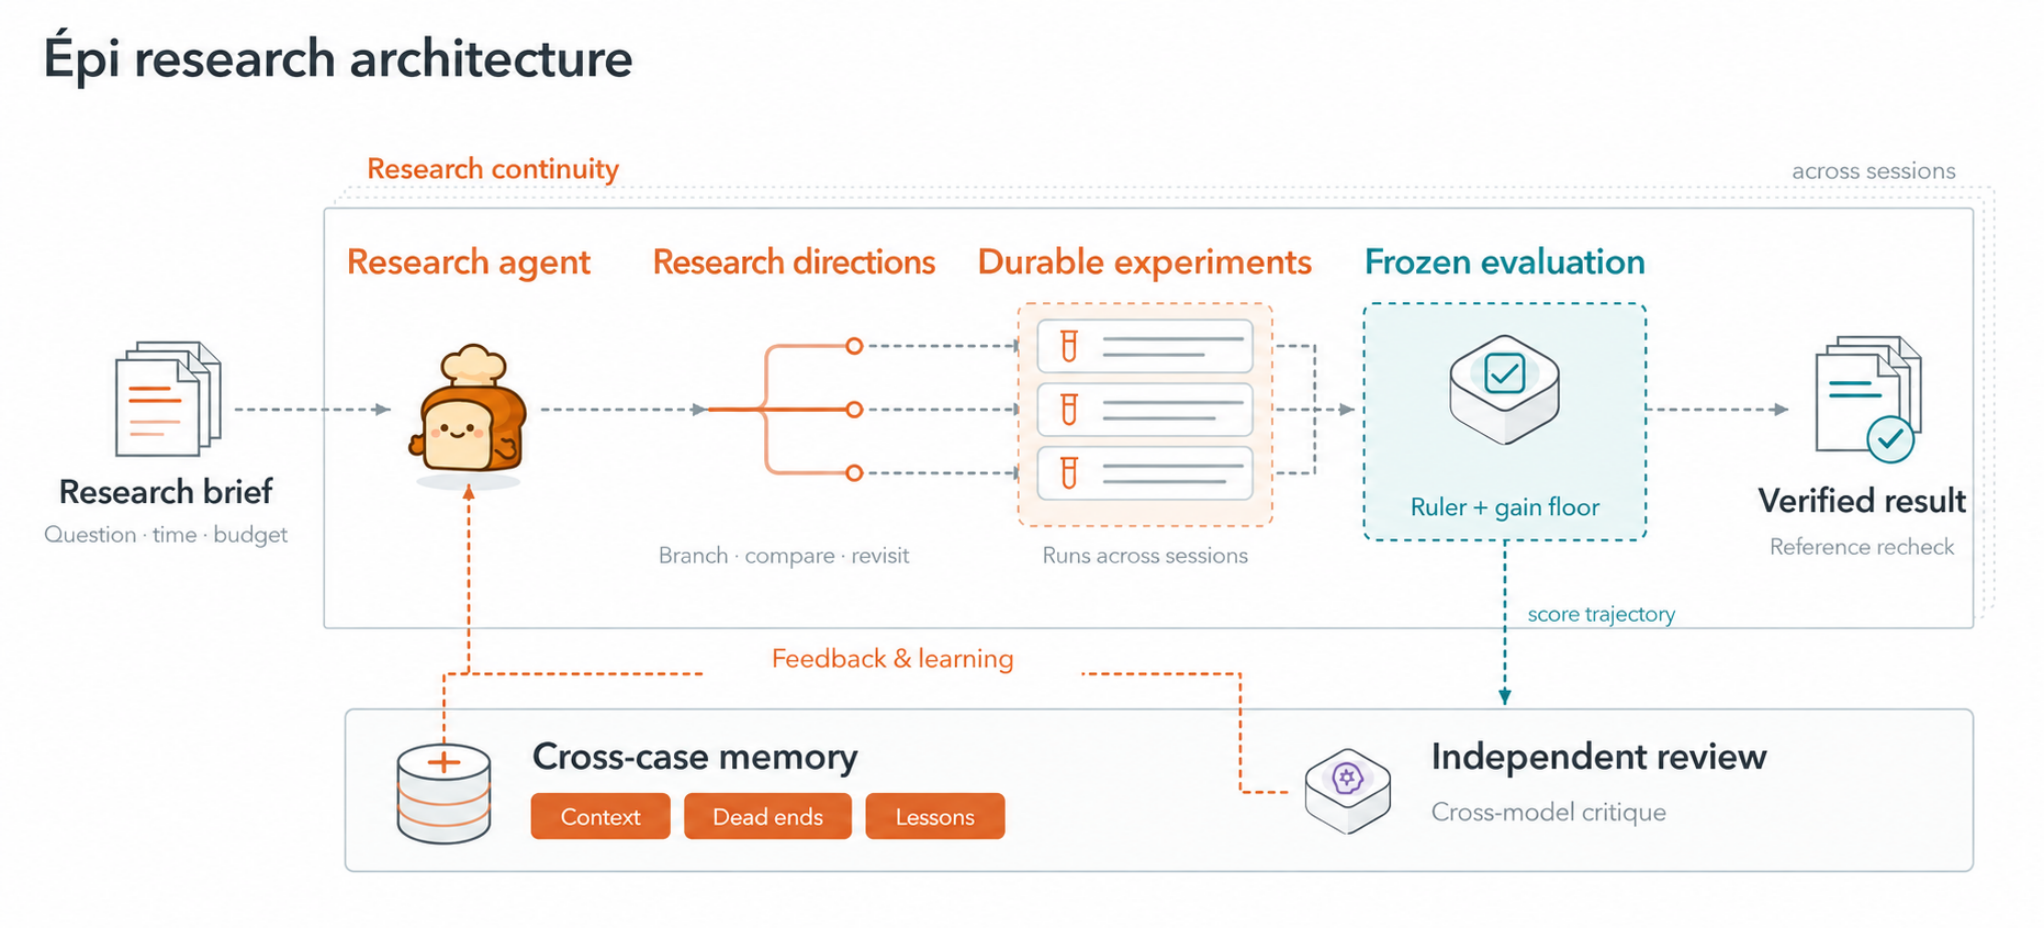
Epi делит исследование на кампании и сессии. Кампания объединяет работу над одной задачей, а каждая сессия даёт модели ограниченный контекст. Код, запущенные задания, промежуточные результаты и причины принятых решений остаются во внешнем хранилище, поэтому новая сессия продолжает работу с сохранённого состояния.
Память устроена иерархически. Для текущей задачи агент получает краткое описание состояния и следующие шаги, а подробные файлы открывает по мере необходимости. Отдельно он хранит выводы, которые можно использовать в других кампаниях, и тупиковые подходы с объяснением, почему они не сработали.
Это отличается от простого добавления всей истории в запрос. Чем дольше идёт работа, тем сильнее полный журнал забивает контекст нерелевантными деталями. Epi вместо этого передаёт новой сессии записку о текущем положении дел и ссылки на нужные артефакты.
Альтернативные гипотезы агент развивает в ветвях версий. Каждая ветвь сохраняет реализацию, тесты, заметки и результаты экспериментов. Агент может вернуться к ранней версии, выбрать другой путь или возобновить направление, которое стало полезным после новых находок.
За выполнение отвечает Breadboard: он изолирует экспериментальные среды, поддерживает долгие задания и сохраняет состояние между сессиями. Поэтому постоянство обеспечивает не сама LLM, а программная обвязка вокруг неё.
Неизменный верификатор отделяет результат от удачной формулировки
Перед началом кампании для задачи задают единые правила: формат результата, допустимые ограничения, целевую метрику и порог значимого улучшения. Все ветви проверяет один и тот же верификатор. Агент может менять метод, но не способ измерения успеха.
Отдельная модель рецензирует ход работы: смотрит на динамику метрик, использованные ресурсы и отброшенные подходы. Она помогает выбрать следующий эксперимент, но не решает, верен ли результат. Допустимость конструкции, численной границы или программы проверяет изолированный верификатор.
Математические кампании дали 120 результатов, которые превзошли использованные в работе литературные или реестровые ориентиры. Самая заметная деталь — строгий интервал для размерности аттрактора Фейгенбаума сузился более чем в 3,6 млн раз. Агент также подготовил проверяемые сертификаты для границ Cohn–Elkies и компьютерное доказательство частного случая гипотезы Tuza.
Облегчённую конфигурацию Epi-turbo проверили на 30 задачах FrontierOR по маршрутизации, планированию, размещению и оптимизации графов. При той же базовой модели и том же объёме рассуждений она набрала на 5,4% больше, чем Codex, потратив 64% его затрат на модель. Разницу обеспечивали не только найденные решения, но и скорость созданных программ.
Проверка охватывает задачи с формализуемым результатом: конструкции, численные границы, доказательства с конечными сертификатами и исполняемые решатели. В математических кампаниях веса моделей оставались неизменными. Поэтому работа показывает улучшение исследовательского процесса, а не обучение самой модели.
Планы меняются для агентов с проверяемым выходом
Для команды, которая строит решатель, агента для поиска алгоритмов или систему автоматических экспериментов, Epi предлагает более конкретную архитектуру, чем «дать модели длинный контекст». Состояние задачи стоит хранить отдельно от диалога: вместе с версиями кода, параметрами запусков, журналами, артефактами и основаниями для решений.
Второй элемент — ветвление. Если агент последовательно переписывает единственную реализацию, неудачный эксперимент может уничтожить полезную исходную точку. Репозиторий с ветвями позволяет сравнивать методы по общему правилу и возвращаться к прежним версиям без реконструкции по переписке.
Третий элемент — разделение ролей. Генератор предлагает изменения, независимая модель оценивает направление, а детерминированный код проверяет итоговый объект. Такая схема уменьшает риск, что агент примет рост удобной метрики за реальное улучшение или подтвердит собственную ошибку повторным рассуждением.
Работа меньше меняет планы команд, которым нужен универсальный помощник для текстов и решений без однозначной проверки. Перенести туда ветви и память можно, но основной результат Epi опирается на фиксированный критерий допустимости. Если такой критерий нельзя выразить тестом, сертификатом или измеримой функцией, верификатор придётся заменять человеческим контролем, а заявленный уровень автономности снизится.
Практический вывод касается не выбора конкретной LLM. Долгая автономная работа требует внешнего состояния, воспроизводимых запусков и проверки, которую агент не может изменить по ходу поиска. Epi показывает, что эта инфраструктура способна дать выигрыш даже при неизменной базовой модели.
Источники
Иллюстрация: рисунок из статьи «Epi: Towards a Persistent, Self-Improving Agent for Autonomous Research», Yue Huang, Zhangchen Xu, Xiaonan Luo и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


