
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Ошибку ассистента с долгосрочной памятью теперь можно разложить по этапам: факт не сохранился, не нашёлся или не помог сформировать ответ. В препринте EvalMem, который не прошёл рецензирование и приводит замеры самих авторов, поиск оказался самым частым источником сбоев: 22,1% запросов на LoCoMo против 7,7% у хранения и 6,5% у генерации. Такая диагностика помогает не менять модель или формат памяти, когда проблема находится в поисковом слое.
Как проверяют каждый этап отдельно
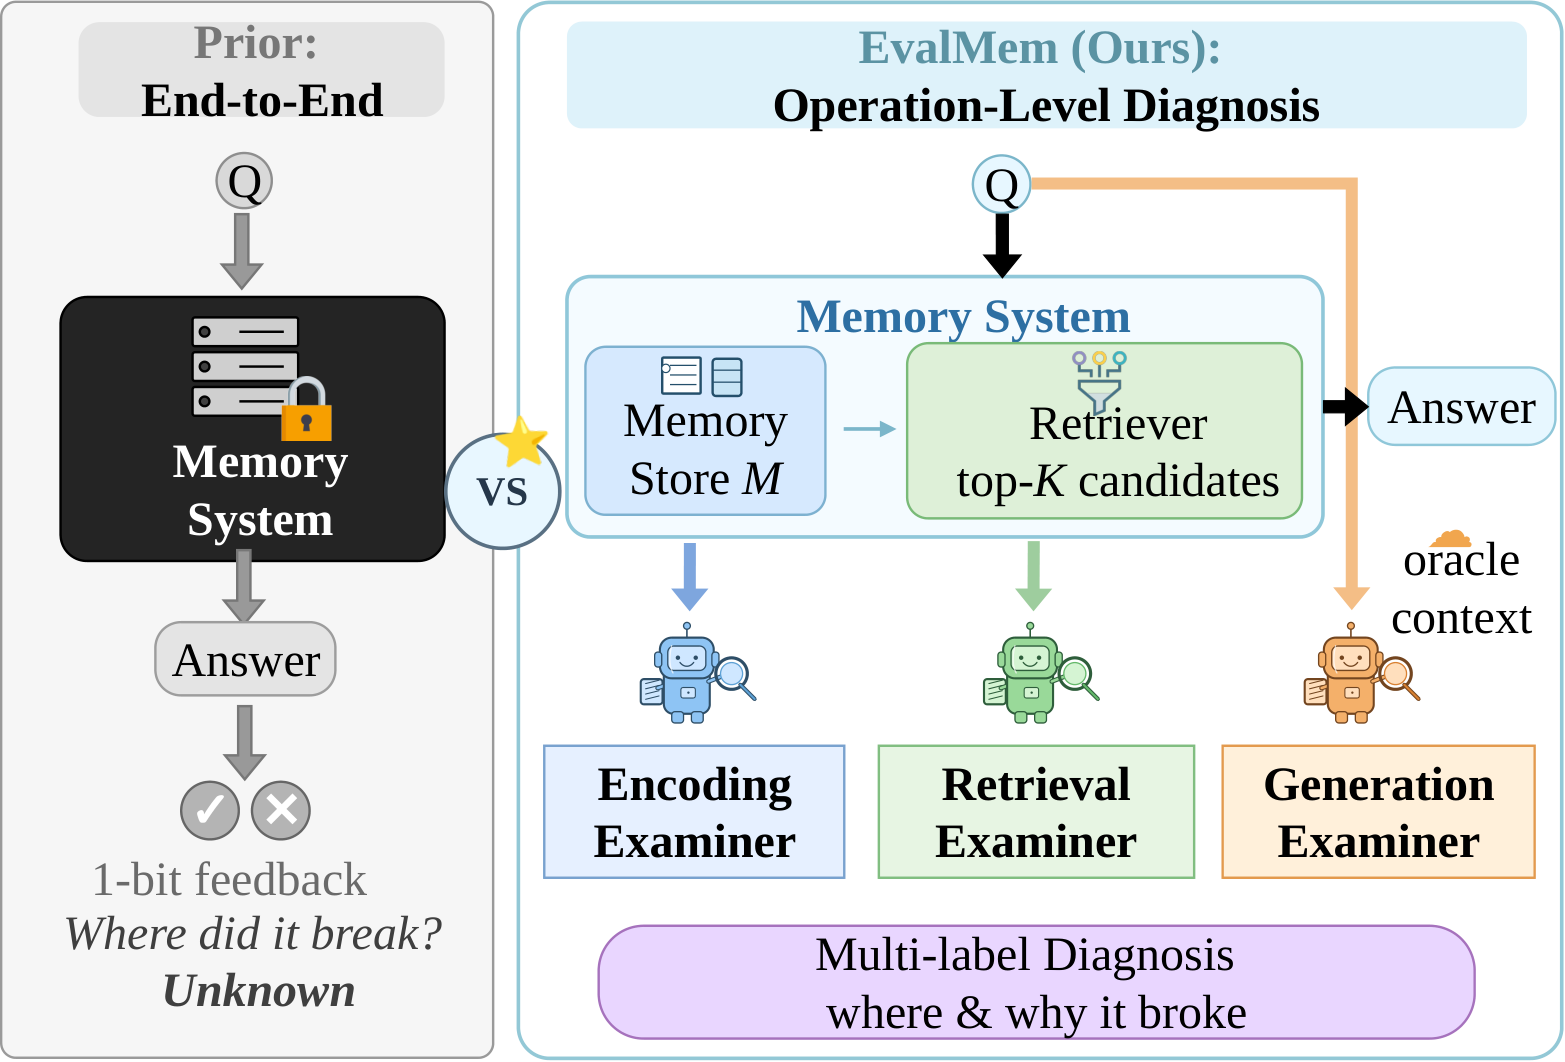
Обычный тест памяти задаёт вопрос и проверяет конечный ответ. Если ответ неверен, итоговая оценка не показывает, потеряла ли система факт при записи, пропустила его при поиске или неверно истолковала найденный фрагмент.
EvalMem запускает три независимые проверки после того, как тестируемая система обработала историю диалога и ответила на вопрос. Проверка хранения ищет нужный факт непосредственно в памяти. Проверка поиска смотрит на контекст, который вернул штатный поисковый механизм. Проверка генерации передаёт модели полный эталонный контекст и выясняет, способна ли она ответить без помех со стороны памяти и поиска.
Для ответного вопроса здоровая цепочка выглядит так: факт записан, найден и использован. Для вопроса без достаточных оснований система, напротив, не должна хранить выдуманный факт, извлекать похожую, но неподходящую запись и выдавать конкретный ответ вместо отказа.
Результат содержит не одну причину, а набор из 11 кодов дефектов. Они различают отсутствующую, неоднозначную или неверную запись; пропущенное, слишком позднее или зашумлённое свидетельство; выдумку, игнорирование контекста и ошибку рассуждения. Если факт не попал в память, EvalMem не записывает последующий промах поиска как отдельную первопричину.
В статистику дефектов входят только вопросы с неверным конечным ответом, но долю считают от всех вопросов теста. Один запрос может получить несколько кодов, потому что ошибки этапов иногда сочетаются.
Перестройка индекса подтвердила диагноз
EvalMem проверили на семи системах памяти: TiMem, O-Mem, EverMemOS, MemOS, MemBox, MemoryOS и GAM. В испытания вошли статические наборы LoCoMo и LongMemEval-S, а также DynaMem-Bench, где диалог развивается по ответам тестируемого ассистента. Основные прогоны использовали gpt-4o-mini; отдельно сравнивали gpt-4.1 и Qwen3-30B-Instruct.
Проверка хранения сама зависит от поиска: диагностический инструмент может не заметить факт, который в действительности лежит в памяти. Поэтому EvalMem ищет не только по вопросу, но и по эталонному свидетельству, сочетает смысловой и словарный поиск, временные и тематические формулировки, а затем повторно сортирует кандидатов. На LoCoMo полнота обнаружения присутствующих свидетельств выросла с 70,2% до 95,6%.
Чтобы проверить практическую ценность диагноза, поверх выгрузки памяти построили MemWiki — дополнительный индекс со страницами исходных записей, сущностей, тем и событий. Он не заменяет штатный поиск и не получает эталонные ответы: вспомогательная запись лишь ведёт к исходному фрагменту памяти.
MemWiki повысил среднюю точность на 2,5 процентного пункта в LoCoMo и на 2,3 пункта в LongMemEval-S. Улучшение после вмешательства только в поисковую структуру поддерживает основной вывод: часть неверных ответов вызвана не потерей фактов и не слабостью модели, а тем, как память подготовлена к извлечению.
Когда EvalMem меняет план разработки
Для команды, которая уже измеряет только точность ответов, работа предлагает полезное изменение испытательного контура. Вместо ранней замены LLM стоит сохранять три артефакта каждого прогона: выгрузку памяти, контекст после штатного поиска и финальный ответ. Без них разделить сбои по этапам не получится.
Диагностика также требует набора вопросов с эталонными свидетельствами и ключевыми фактами. Она подходит для контролируемых испытаний, где известна история, из которой должен следовать ответ. Это не фоновая метрика для произвольных продуктовых диалогов: использование эталонного свидетельства при проверке хранения делает EvalMem инструментом аудита, а не заменой рабочего поискового механизма.
DynaMem-Bench добавляет важный сценарий для продуктов, где пользователь меняет планы, предпочтения или состояние между сессиями. Система ведёт собственный диалог, а контрольные вопросы проходят через канал только для чтения и не загрязняют память. Так можно отдельно увидеть, сохранила ли память новое значение, перестала ли извлекать устаревшее и правильно ли обработала изменение модель.
Архитектурный вывод уже применим без внедрения всего EvalMem. Если факт присутствует в хранилище, сначала стоит проверить разбиение записей, индекс, сортировку кандидатов и объём постороннего контекста. Если факт отсутствует или искажён, нужен другой механизм записи и обновления. Менять генеративную модель имеет смысл тогда, когда она ошибается даже с полным и чистым свидетельством.
Источники
Иллюстрация: рисунок из статьи «EvalMem: An Operation-Level Diagnostic Framework for Long-Term Memory Systems», Zeyu Liu, Jian Zhong, Rongduo Han и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


