
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
LLM-агенты часто не накапливают полезные изменения, потому что проверка не отличает улучшение от случайного разброса. В работе Yuanhao Zeng и соавторов, которая пока не рецензирована и приводит их собственные замеры, селектор выбирал полезные инструкции не лучше случайного выбора. Значит, при разработке самоулучшающегося агента бюджет стоит направлять не только на генерацию вариантов, но и на повторную проверку каждого из них.
Эволюция агента здесь означает цикл, в котором модель переписывает внешние элементы системы: подсказки, навыки, память или управляющий код. Затем новый вариант запускают на задачах и сохраняют, если он набрал больше баллов. Повторные прогоны показали, что генератор создаёт полезные варианты, однако шумная оценка часто отбрасывает их или принимает вредные.
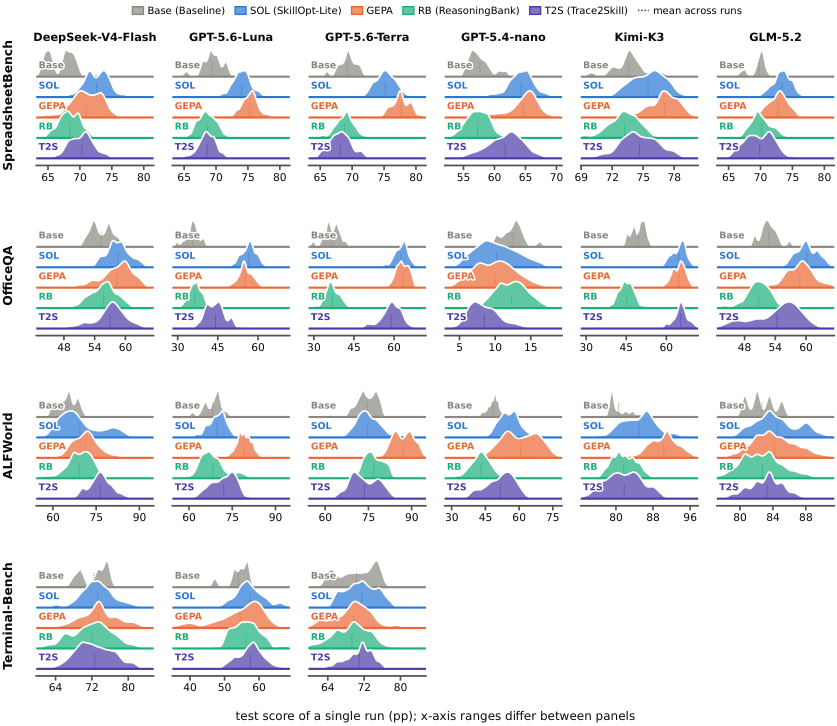
Та же проблема ломает сравнение методов. Типичный отрыв в изученных публикациях составлял 3,4 процентного пункта, но он был меньше разброса между независимыми запусками одного метода. На Terminal-Bench один запуск правильно выбирал лучший из четырёх методов в 33% случаев против 25% при случайном выборе; для надёжного сравнения такого отрыва требовалось от 5 до 23 независимых запусков в зависимости от бенчмарка.
Крупные выигрыши тоже оказались связаны с качеством проверки. Одно правило, которое подстраивало ответ под особенности оценщика, воспроизводило почти весь эффект полного цикла. После исправления проверки медианный выигрыш сократился с 17,6 до 0,8 процентного пункта: агент учился проходить конкретный оценщик, а не устойчиво решать задачи лучше.
Работу проверяли на семи методах, шести моделях и четырёх бенчмарках. Подробный разбор выбора отдельных улучшений проводили на Terminal-Bench, а сами методы меняли внешние элементы агента при замороженных весах модели. Вывод напрямую относится к системам с таким циклом: прежде чем выбирать новый алгоритм эволюции, нужно измерить разброс повторных запусков и проверить, способен ли оценщик заметить ожидаемый прирост.
Источники
Иллюстрация: рисунок из статьи «The Resolution Hypothesis: Agent Evolution's Key Is Identifying Improvements», Yuanhao Zeng, Shaocheng Lan, Ao Lu и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


