
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Навыки LLM-агентов научились обновлять так, чтобы каждую правку можно было заново проверить в исходном фрагменте задачи. Yan Zhou и соавторы назвали подход EVISKILL: он сохраняет полезные локальные исправления даже после провала общей версии, хотя препринт не рецензирован и все числа в нём получили сами авторы. Для команд это образец более управляемого контура обучения агента на собственном опыте без изменения параметров модели.
Карточка связывает правку с поведением агента
Навык здесь — внешняя инструкция с процедурами, правилами выбора инструментов и способами исправить ошибку. Агент получает её вместе с задачей, поэтому команда может менять его поведение без дообучения базовой модели.
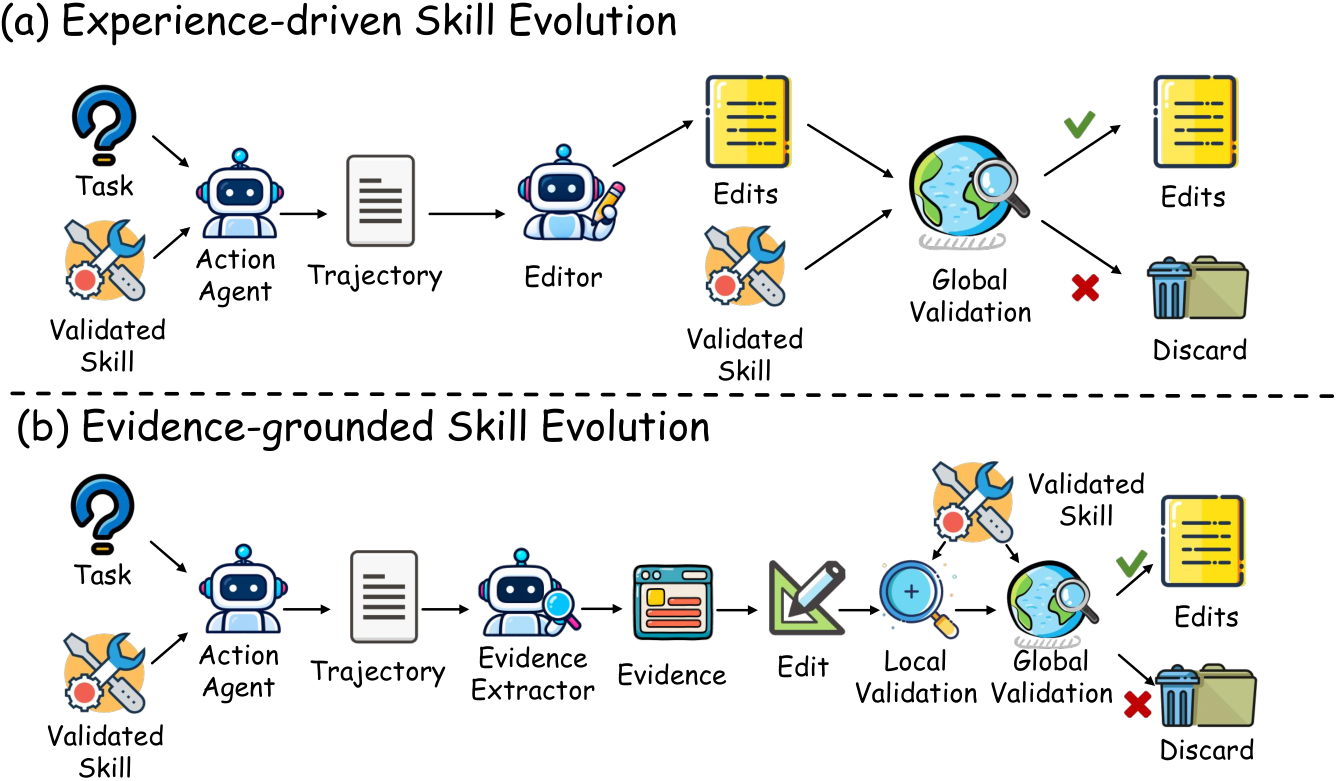
Обычный контур улучшения собирает траектории выполнения, находит неудачные действия и переписывает инструкцию. При этом связь между правкой и породившим её эпизодом легко теряется: в документе остаётся обобщённый совет, но уже нельзя воспроизвести условия, в которых он должен был помочь.
EVISKILL вместо сырой истории создаёт карточку доказательства. В ней лежат предлагаемое исправление и ссылки на конкретные диапазоны шагов в одной или нескольких траекториях. Карточка сохраняет достаточно контекста для повторного запуска, но не заставляет редактор навыка каждый раз разбирать всю историю взаимодействия.
Система различает проверенный и рабочий навык. Проверенный прошёл общую оценку, а рабочий дополнительно содержит временные правки, которые помогли в своих эпизодах, но ещё не доказали пользу на всём наборе задач. Это не даёт локально удачному правилу сразу стать постоянной инструкцией.
Для проверки система восстанавливает состояние перед отмеченным шагом и повторно выполняет только связанный с правкой фрагмент. LLM-оценщик сравнивает исходное и новое поведение: принимает изменение, отклоняет его либо возвращает редактору с указанием конкретного недостатка. Исправленная версия проходит ещё один запуск.
Локальная проверка спасает правки из неудачных версий
Предварительный опыт показал, почему одной генерации исправлений недостаточно. После первого повторного запуска доля правок, отправленных на доработку или отклонённых, достигла 41,8% на AppWorld и 42,5% на ScienceWorld. Даже на ALFWorld проверку не прошли сразу 20,7% предложений.
Эти доли описывают не успех агента на задачах, а качество самих изменений инструкции. Правка могла выглядеть логично при чтении траектории, но не менять нужное действие, нарушать другое правило или не срабатывать в восстановленном состоянии. Повторный запуск проверяет поведенческий эффект, а не убедительность формулировки.
После локальной проверки EVISKILL собирает принятые изменения в новую версию навыка и оценивает её целиком. Если общая метрика не выросла, система снова рассматривает каждую правку отдельно. Подтверждённые изменения остаются во временном журнале и участвуют в следующих циклах, а проверенный навык не меняется.
Так были временно сохранены 96 правок из отклонённых версий. Позднее 72,9% из них вошли в навыки, которые уже прошли общую проверку. Значит, отрицательный результат для пакета изменений плохо подходит как окончательный приговор каждому его элементу.
Карточки тоже живут дольше одного цикла. Новые траектории могут показать, что старой правке не хватает условия или что несколько наблюдений поддерживают одно общее правило. EVISKILL возвращает такое доказательство редактору, вместо того чтобы заново извлекать вывод из полной истории.
Планы меняет не алгоритм, а устройство контура улучшения
EVISKILL не предлагает новую базовую модель и не заменяет обычную оценку качества продукта. Работа показывает, как разделить локальный вопрос «исправила ли правка нужное поведение» и глобальный вопрос «стала ли вся версия навыка лучше». Если свести их к одной итоговой метрике, полезные изменения будут исчезать вместе с неудачными пакетами.
Для системы, где агенты регулярно выполняют похожие процессы, из работы следует практическая архитектура: версионировать внешние инструкции, хранить происхождение каждой правки, уметь восстанавливать промежуточное состояние и вести отдельный журнал временно принятых изменений. Такой журнал нельзя подмешивать в проверенную версию без общей оценки.
Цена этого контроля — дополнительные вызовы агента, редактора и модели-оценщика. Повторяются только отмеченные диапазоны шагов, а не обязательно вся задача, однако продукту всё равно понадобится воспроизводимая среда. Если состояние внешнего сервиса нельзя восстановить, ключевой механизм EVISKILL теряет часть пользы.
Метод проверяли на трёх интерактивных средах — AppWorld, ScienceWorld и ALFWorld — с шестью базовыми моделями. Анализ переноса правок охватывал четыре цикла улучшения. Эти условия близки к агентам, которые работают с инструментами и длинными последовательностями действий, но не доказывают тот же эффект для произвольных бизнес-процессов.
Поэтому работа меняет планы прежде всего там, где команда уже собиралась улучшать агента по журналам выполнения. Вместо схемы «нашли ошибку — переписали навык — приняли или выбросили всю версию» стоит заложить проверяемую единицу изменения: правку, связанный с ней контекст и результат повторного запуска.
Источники
Иллюстрация: рисунок из статьи «EVISKILL: Grounding Skill Evolution in Replayable Evidence», Yan Zhou, Yili Wang, Yiwei Dai и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


