
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Агента научили одновременно улучшать собственную модель и программу, которая управляет его подсказками, инструментами, контекстом и ходом выполнения. Evo² набрала 82,1% на Polyglot против 62,6% у сильнейшего базового метода. Такой контур может заменить раздельную настройку модели и управляющей обвязки (harness), хотя работа не рецензирована и числа получили сами авторы.
Обвязка даёт модели опыт для следующей правки
Обычный самообучающийся агент накапливает улучшения одним из двух способов. Команда либо дообучает модель на её удачных решениях, либо оставляет веса неизменными и переписывает код вокруг модели: подсказки, вызовы инструментов, управление контекстом и обработку результатов.
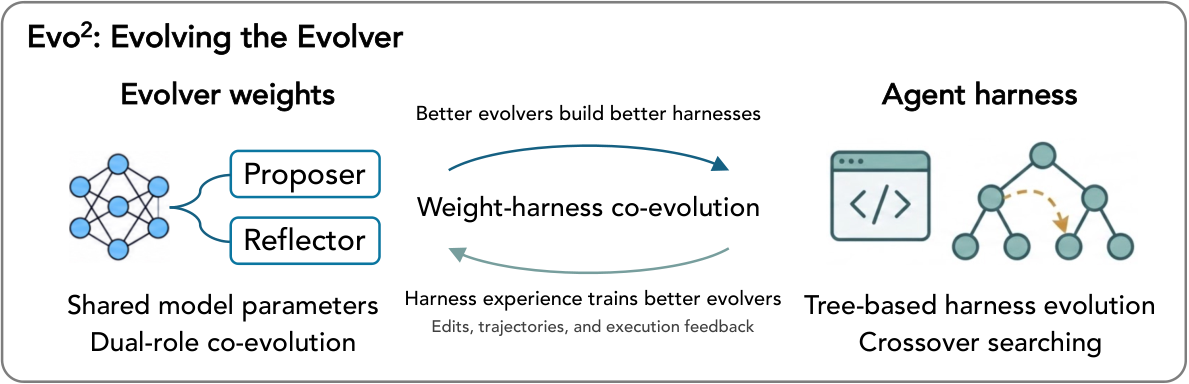
Evo² связывает эти процессы. Исполнитель задач остаётся фиксированным, поэтому разница в результате показывает эффект от новой версии обвязки. Сами правки, ошибки запуска и изменения качества затем становятся материалом для обучения модели, которая продолжит поиск.
Одна модель играет две роли. Предлагающая сторона меняет обвязку самостоятельно или выполняет конкретное указание. Проверяющая сторона читает правку, трассировку выполнения и итоговую оценку, после чего советует исправить изменение, сохранить его или перенести подход из другой ветки поиска.
Ветки образуют дерево версий. Если одна из них нашла полезный механизм, проверяющая сторона может предложить встроить его в другую ветку, а предлагающая адаптирует код к новому окружению. Так поиск не теряет удачные решения, которые появились вне текущей последовательности правок.
Награда обеих ролей зависит от того, как изменилась оценка агента на одинаковых задачах и при сопоставимых условиях. Нерабочие изменения, пустые правки и файлы, которые нельзя запустить, получают штраф. Это связывает обучение не с убедительностью рассуждения модели, а с выполнением кода.
Модель учится и предлагать изменения, и оценивать их
Для обновления весов авторы разработали EvoTIDE. Сначала модель проходит обучение с учителем на удачных правках и полезных рекомендациях, затем обе роли поочерёдно обучаются через групповую относительную оптимизацию стратегии (GRPO).
Во время обучения одной роли замороженная копия модели выполняет вторую. После очередного раунда копию обновляют, поэтому более точные рекомендации постепенно создают лучшие примеры для редактора, а более качественные правки — новые случаи для проверяющей стороны.
EvoTIDE также сохраняет частично удачные попытки. Если модель внесла несколько рабочих изменений, а затем сформировала некорректную команду, система возвращается к последнему применённому изменению и заново генерирует окончание. Если правка описана в рассуждении, но не оформлена как команда, её извлекают и всё равно проверяют запуском.
На SWE-bench Verified Evo² закрыла 48,3% задач против 41,0% у HGM. На LiveCodeBench разрыв оказался меньше: 58,0% против 56,0% у DGM. Отдельное сравнение при одинаковом поиске показало, что обучение весов добавило 16,3 процентного пункта на Polyglot — здесь совместный контур дал заметную часть результата.
Границы проверки достаточно широки для сравнения подходов, но всё ещё привязаны к исследовательской установке. Основные опыты провели с Qwen3.8-27B на Polyglot, SWE-bench Verified и LiveCodeBench, сравнив Evo² с SICA, DGM, HGM и GEA. Дополнительно подход проверили на задачах памяти LoCoMo и LongMemEval, а GPT-5-mini и Claude Haiku 4.5 использовали с фиксированными весами; в опытах с закрытыми моделями менялась только обвязка.
Совместный контур меняет процесс разработки, но не выбор базовой модели
Работа предлагает пересмотреть границу между дообучением модели и разработкой агентского кода. Если продукт уже умеет автоматически оценивать результат, команде выгоднее хранить правки обвязки, трассировки и оценки как единый набор опыта, а не вести поиск подсказок отдельно от обучения.
Для такой схемы нужен воспроизводимый исполнитель: одинаковые задачи для родительской и дочерней версий, проверка запуска, журнал изменений и возможность восстановить промежуточное состояние. Без внешней оценки Evo² не сможет отличить полезную правку от убедительно описанной, но бесполезной.
Командам, которые работают только через API закрытой модели, доступна часть подхода: разделение ролей, дерево вариантов, анализ трассировок и перенос решений между ветками. Эксперименты с GPT-5-mini и Claude Haiku 4.5 показывают, что для этого не обязательно менять веса.
Если веса доступны, правки обвязки можно превратить в обучающий сигнал для следующего раунда поиска. Это не требует менять базовую модель или переносить продукт на новый стек, но меняет устройство контура улучшений: версия агентского кода становится не только результатом эксперимента, но и источником данных для модели, которая проведёт следующий.
Источники
Иллюстрация: рисунок из статьи «Evo$^2$: Evolving the Evolver through Weight-Harness Co-Evolution», Chejian Xu, Shujian Zhang, Wenxuan Zhou и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


