
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
LLM-агента научили менять представление о среде без обновления параметров базовой модели. На ALFWorld EvoBelief поднял долю успешных задач на 31,3 процентного пункта относительно неизменяемой модели среды; работа не рецензирована, и все числа получили сами авторы. Для продуктовых команд это предлагает другой контур самообучения: не копить советы из прошлых запусков, а вести внешнюю базу проверяемых правил.
Гипотеза не влияет на действия, пока не выдержит проверку
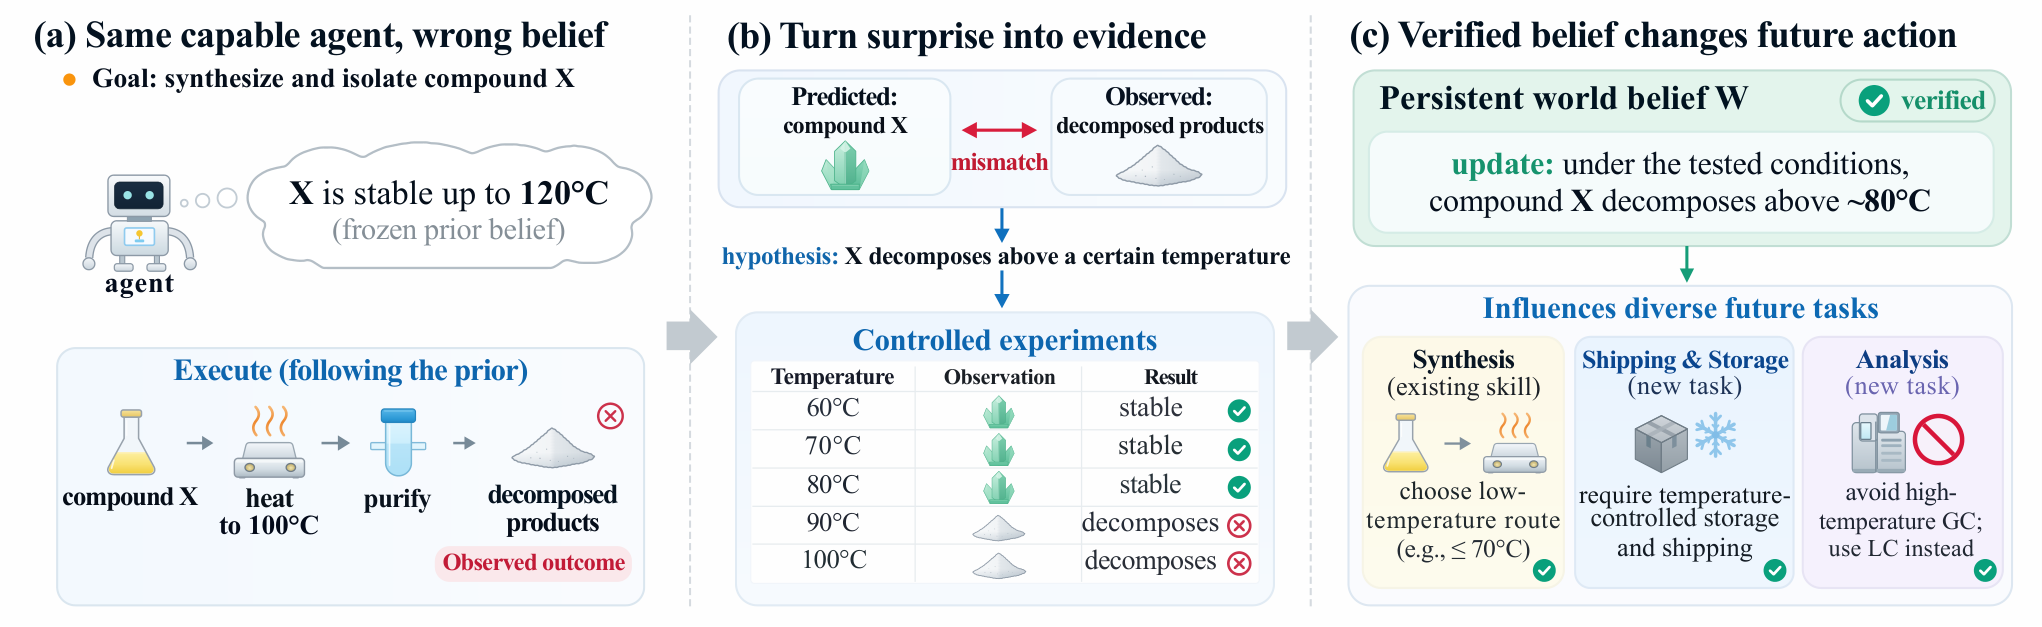
Обычная память агента сохраняет траектории, выводы или готовые приёмы. Такой подход исправляет поведение после ошибки, но не обязательно объясняет, почему среда дала неожиданный результат. Исправление «нагревать слабее» помогает одной задаче, а правило о температуре разложения вещества может изменить синтез, хранение и анализ.
EvoBelief разделяет текущее состояние эпизода и постоянную модель среды. Первое хранит объекты, отношения и ход задачи, а после завершения эпизода очищается. Второе переживает перезапуски и содержит правила о том, как среда отвечает на действия.
Новое правило начинается с опровержимой гипотезы: при заданных условиях действие должно дать наблюдаемый результат. Гипотезу создаёт расхождение между прогнозом и фактическим исходом либо неизвестная величина, от которой зависит следующее решение. Один неожиданный исход не считается доказательством.
Подтверждение приходит из обычных действий или отдельного эксперимента. Перед экспериментом агент фиксирует, какой результат поддержит гипотезу, а какой её опровергнет. Эксперимент допускается, только если ответ способен изменить решение, готового правила ещё нет, а необходимую проверку можно выполнить в среде.
Чтобы гипотеза получила право влиять на планы, её должны независимо подтвердить разные эпизоды, привязки к объектам и проверки. Контрпример сужает область действия правила или лишает его этого права. Повторные противоречия могут вывести правило из использования, но журнал доказательств сохраняется.
Базовая LLM при этом остаётся замороженной. Сначала она предлагает действия без доступа к накопленным правилам, затем EvoBelief проверяет применимость подтверждённых знаний и при необходимости меняет прогноз или короткий план. Связь между правилом, доказательствами и изменённым решением остаётся доступной для разбора.
Метод проверяли в симуляторах разных типов: ALFWorld включал 134 ранее не показанные задачи, ScienceWorld — 90 задач, MiniGrid — 240 эпизодов на набор начальных состояний, DiscoveryWorld — 12 новых экземпляров на каждый уровень. Claude Haiku 4.5 и GPT-5.4 работали в статичных средах, при скрытой смене правил и в задачах на поиск научных закономерностей.
Проверяемые правила помогли и при переносе, и при смене среды
На ALFWorld без памяти переходов у действующего агента EvoBelief с Claude Haiku 4.5 обошёл сопоставимую неизменяемую модель среды на 23,9 процентного пункта. Методы запускали через одинаковый интерфейс и с одинаковыми бюджетами. Подтверждённые правила применялись в последующих задачах, в том числе за пределами семейства, где они появились.
В MiniGrid среда без предупреждения меняла ключ, который открывает дверь. EvoBelief находил контрпримеры, отзывал устаревшее правило и подтверждал новое. Варианты без активных экспериментов или без применения выученных правил не воспроизводили этот выигрыш, поэтому одного накопления записей оказалось недостаточно.
В Reactor Lab из DiscoveryWorld агент строил количественные законы, проверял их на отложенном объекте и только после этого рассчитывал параметры реактора. Он завершил 83,3% задач обычного уровня и 58,3% усложнённых, тогда как у всех сопоставленных базовых методов результат составил 0%. Здесь различие особенно заметно: задача требовала не вспомнить удачное действие, а вывести зависимость и проверить прогноз, который мог оказаться неверным.
Архитектуру долгоживущих агентов стоит разделить на память и убеждения
Работа меняет планы команд, которые строят агентов для повторяющихся операций в одной среде. История действий и библиотека навыков не заменяют модель того, как эта среда отвечает на команды. Ошибочное обобщение в общей памяти может перейти в несколько процессов, тогда как EvoBelief не разрешает неподтверждённой записи управлять действиями.
Практическая схема состоит из отдельного хранилища правил, области их применимости, ссылок на доказательства и статуса проверки. Поверх него нужен шлюз допуска: правило меняет прогноз или план только после независимого подтверждения. Ещё один контур должен находить контрпримеры и отзывать устаревшие знания, иначе самообучение превращает прежний опыт в постоянную ошибку.
Активные проверки требуют действий в среде и расходуют рабочий бюджет, поэтому в продукте им понадобятся ограничения безопасности и стоимости. В статье перечислены дополнительные вызовы LLM и действия агента, но они не сведены к цене эксплуатации. Перенос на реальные программные и физические системы остаётся следующим шагом: текущие результаты получены на интерактивных бенчмарках.
Главный результат не в конкретном механизме хранения. EvoBelief разделяет появление догадки и право действовать на её основе. Для систем, которые должны учиться во время эксплуатации, это делает внешний мир не набором воспоминаний, а источником правил, которые можно проверить, сузить и отменить.
Источники
Иллюстрация: рисунок из статьи «EvoBelief: Falsifiable World Models for Self-Improving LLM Agents», Janet Wang, Jiang Guo, Yi Xiang и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


