
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Интерфейс между ИИ-агентом и системой проверки доказательств научились улучшать автоматически. В препринте, который не рецензировали и где приведены замеры самих авторов, получившийся MCP-сервер обошёл два других интерфейса по доле решённых задач, стоимости и времени на четырёх моделях. Команды могут проверять инструменты агента так же, как модели: добавлять по одному и оставлять только те, которые улучшают итоговый результат.
Как модель выращивала интерфейс по одному инструменту
ИИ-агент не обращается к Rocq напрямую. Между ними работает MCP-сервер: он передаёт команды системе доказательств, возвращает состояние доказательства и определяет, сколько контекста получит модель. От состава и формата этих инструментов зависят число запросов к модели, расход токенов и время работы.
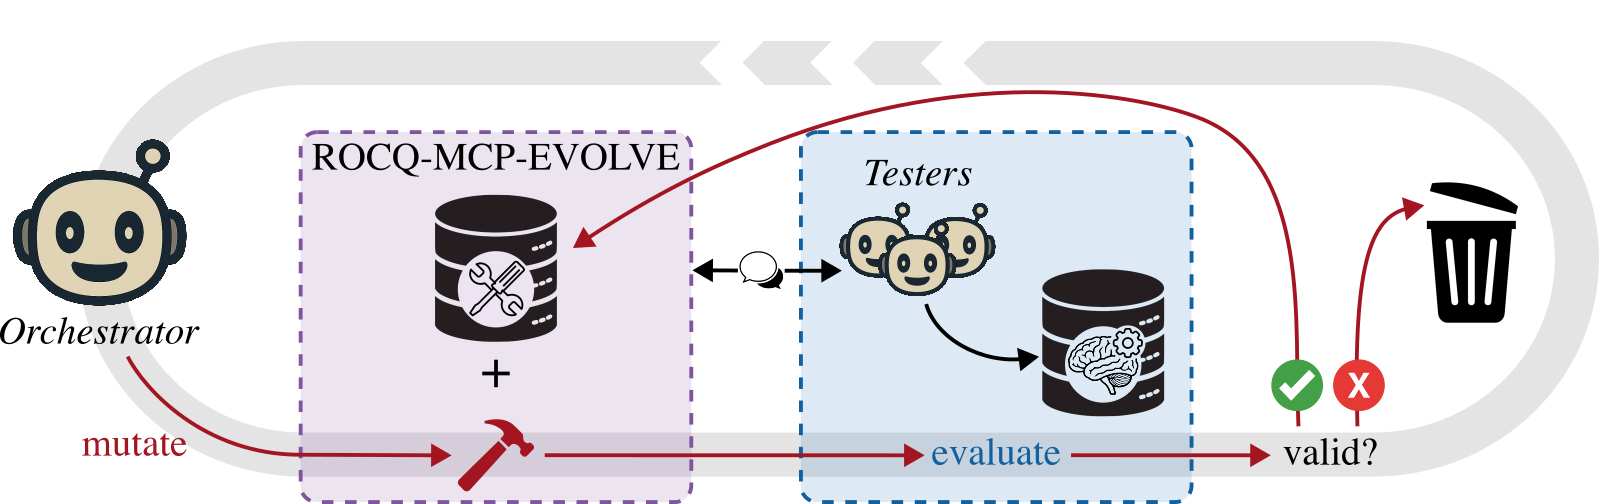
Отправной точкой стал сервер с единственным инструментом — полной компиляцией файла. Claude Fable 5 выступал организатором эксперимента: изучал журналы предыдущих запусков, предлагал одно изменение, реализовывал его и запускал проверку. Claude Haiku 4.5 и Claude Sonnet 5 пытались решать одни и те же задачи до и после изменения.
Система учитывала три показателя: долю решённых задач, среднюю стоимость успешного решения и затраченное на него время. Главным критерием сначала была доля решений. Стоимость и время помогали выбрать между вариантами, которые давали сопоставимый результат.
Основной набор включал 60 задач разной сложности. На каждую попытку агент получал не более 300 секунд и 30 обращений к серверу. Отдельные изменения проверяли на школьных олимпиадных задачах, примерах из библиотеки MathComp и проектах из нескольких файлов.
Успех нельзя было заявить простым ответом агента. Проверяющая система заново собирала доказательство в чистом каталоге, запрещала незавершённые фрагменты и дополнительные аксиомы, а затем проверяла допущения средствами Rocq. Для проектов она также запускала тесты против собранной библиотеки.
Интерактивное состояние оказалось полезнее поиска
По мере добавления инструментов доля успешных попыток на основном наборе выросла с 33% до 54%. Итоговый сервер хранит текущий этап доказательства, позволяет применить тактику, посмотреть новую цель и откатить неудачный шаг. Агенту больше не приходится после каждого изменения заново компилировать весь файл.
Один вызов Rocq благодаря живой сессии сократился примерно с 266 миллисекунд до 1 миллисекунды. Выигрыш складывается не только из работы самого доказателя: короткий ответ сервера занимает меньше контекста, поэтому модель получает меньше повторяющегося текста и быстрее выбирает следующий шаг.
Не все правдоподобные функции помогли. Инструмент поиска подходящих лемм агенты использовали часто, но доля решений не выросла. Режим совместной работы нескольких агентов ухудшил результат, а извлечение похожих примеров не прошло установленный порог. Метод отсеял функции, которые выглядели полезными по журналам работы, но не улучшали завершение задач.
На отдельной тестовой части miniF2F-Rocq итоговый сервер сравнили с минимальной обёрткой над компилятором и существующим rocq-mcp. rocq-mcp-evolve показал лучший результат по всем трём показателям у моделей из семейств Claude и GPT. Тот же порядок сохранился в проектах из нескольких файлов, построенных поверх MathComp.
Когда этот подход меняет план разработки агента
Работа предлагает практический порядок проектирования инструментов. Сначала команда фиксирует минимальный интерфейс, набор задач и критерий успеха. Затем более сильная модель предлагает одно изменение, более дешёвые модели проходят прежний набор, а система принимает или откатывает изменение по заранее заданным правилам.
Такой процесс полезнее проектирования по перечню функций. Часто используемый инструмент может не повышать вероятность успеха, а небольшое изменение формата ответа — сокращать контекст и ускорять весь цикл. Поэтому аналитика вызовов нужна для гипотез, но решение стоит принимать по завершённым задачам, стоимости и времени.
Проверяли прежде всего формальные доказательства в Rocq: математические упражнения и несколько проектов из связанных файлов. Финальную версию заморозили до запуска на отдельной тестовой части, поэтому изменения не подгоняли под неё. При этом наборы для развития интерфейса были подобраны вручную, а проектные задания сгенерировала модель и проверили люди.
Инструменты перенесли в Lean без отдельного цикла эволюции. На выбранной части PutnamBench перенос снизил стоимость и время успешного решения, но уступил специализированному lean-lsp-mcp по доле решённых задач. Значит, готовый набор инструментов можно использовать как стартовую точку, но для другого доказателя его стоит выращивать заново на собственных задачах.
Для команд, которые уже строят агентов поверх Rocq или Lean, работа меняет приоритет: сначала имеет смысл оптимизировать обратную связь от доказателя, а не сразу менять модель. Для других агентных систем переносим сам экспериментальный цикл — фиксированный набор заданий, независимая проверка результата и поочерёдное принятие изменений.
Источники
Иллюстрация: рисунок из статьи «Growing an Agent/Prover Interface: Evolutionary Tool Design for Cost-Efficient Theorem Proving in Rocq and Lean», Jules Viennot, Guillaume Baudart, Marc Lelarge, CC BY-SA 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


