
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
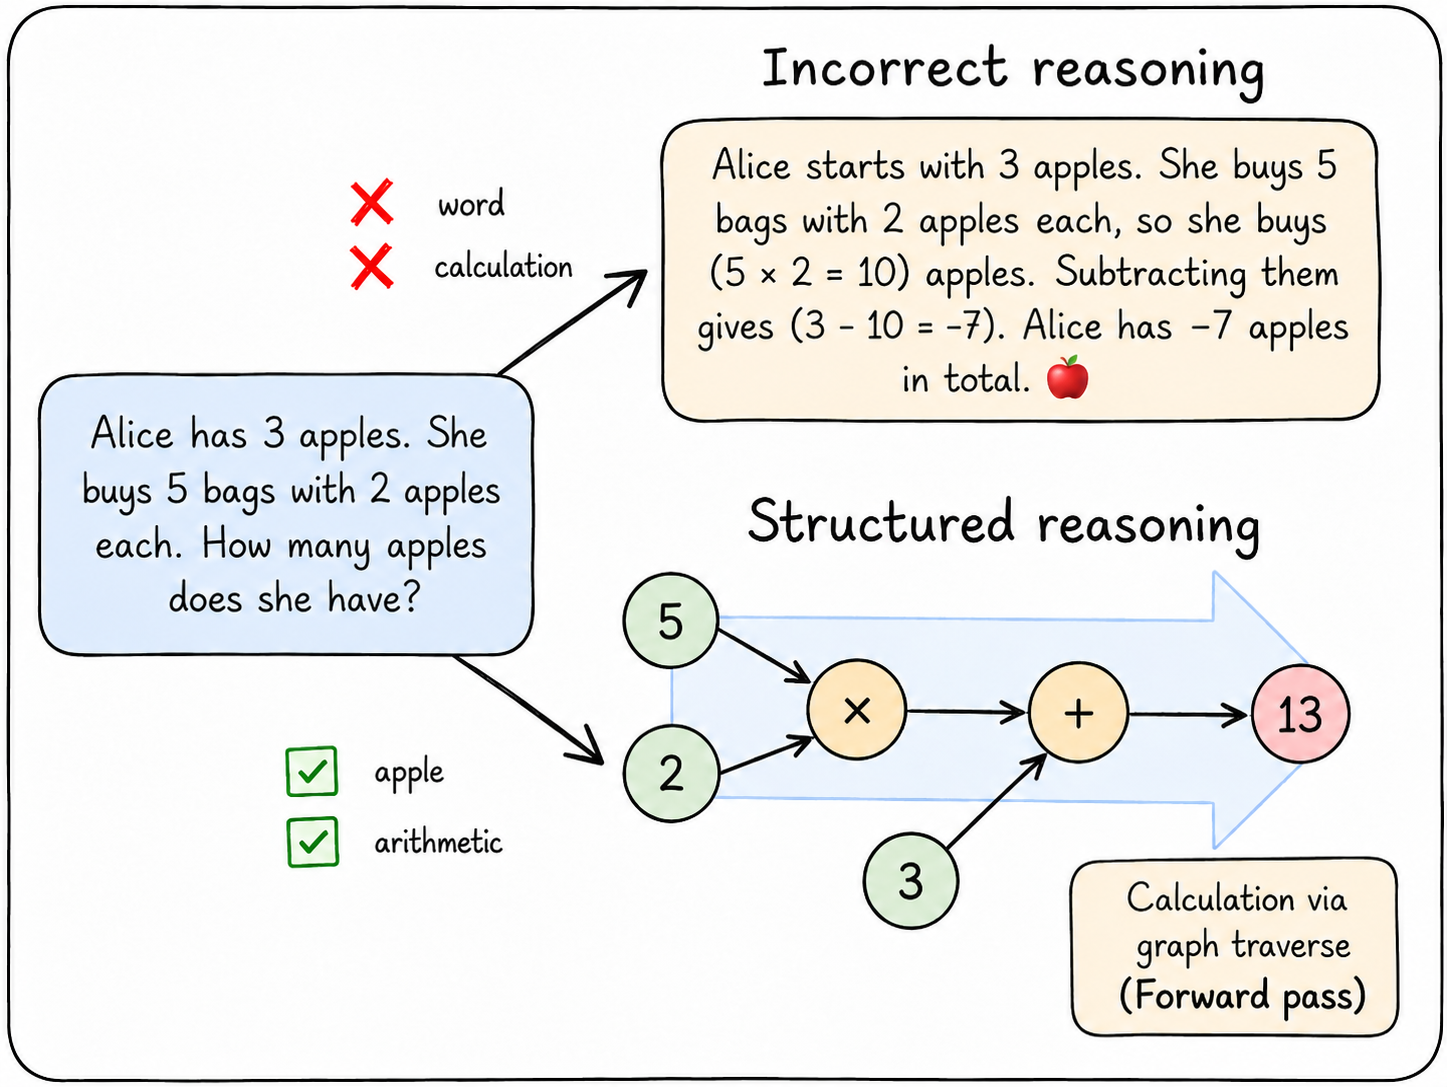
LLM научили заменять свободную текстовую цепочку рассуждений исполнимым графом, который явно связывает исходные данные, операции и итог. Во всех пяти наборах задач обучение с подкреплением улучшило результат относительно обучения только на размеченных графах, хотя работа не рецензирована, а числа получили сами авторы. Такой формат позволяет вычислять ответ обычным интерпретатором и проверять каждый промежуточный шаг.
Как ответ становится результатом графа
В обычной цепочке рассуждений модель пишет объяснение на естественном языке, а затем выдаёт ответ. Текст может выглядеть убедительно, но система не знает, использовала ли модель эти шаги или подобрала ответ другим путём.
В предложенном формате модель возвращает список узлов в JSON. Одни узлы содержат исходные значения, другие задают операции, а ссылки между ними показывают зависимости. Граф не содержит циклов, поэтому исполнитель последовательно вычисляет узлы и берёт значение последнего как ответ.
Для арифметической задачи граф может отдельно хранить цену, количество и скидку, затем связать их операциями умножения и вычитания. Если модель перепутала аргументы или сослалась на отсутствующий узел, ошибка обнаруживается при проверке структуры или исполнении, а не после разбора текстового объяснения.
Команда MIPT и AIRI обучала модели в два этапа. Сначала модель настраивали на примерах из задачи, эталонного графа и ответа. Затем применяли GRPO — метод обучения с подкреплением, который сравнивает несколько вариантов ответа одной модели и повышает вероятность более удачных.
Награда учитывала корректность JSON, возможность исполнить граф, правильность результата и совпадение промежуточных узлов с эталоном. Для логических доказательств вместо числовых операций проверяли выбранные факты и связи между шагами. Во время обучения для одной задачи модель создавала 16 кандидатов.
Графы сократили ответы, но не заменили обычный GRPO
В лучших условиях графовый подход сокращал число сгенерированных токенов до 6,1 раза относительно обычного GRPO. Экономия возникает не из-за сжатого текстового объяснения: модель вообще не пишет его, а перечисляет только узлы и зависимости, нужные исполнителю.
На iGSM, где арифметические задачи создаются процедурно и содержат лишние данные, средняя точность выросла с 47% после обучения на графах до 59% после графового GRPO. На ProofWriter метод также лучше строил полные доказательства, где одновременно должны совпасть исходные факты, промежуточные выводы и структура связей.
Преимущество не распространяется на все способы обучения. На MATH обычный GRPO получил 61%, а графовый вариант — 19%. Формальная структура помогает контролировать вычисление, но может мешать там, где модели выгоднее свободно выбирать способ решения или использовать знания, усвоенные до настройки.
Проверка зависимости ответа от графа дала более практичный результат. После изменения узла или операции модели, прошедшие графовый GRPO, чаще меняли ответ в соответствии с новым результатом исполнения. Значит, граф чаще участвовал в вычислении, а не служил объяснением, составленным после ответа.
GSM8k+ показал обратный случай. В нём авторы переопределили смысл арифметических знаков, чтобы знакомый ответ из GSM8k стал неверным. Qwen3-4B строила граф по новым правилам, но в отдельном текстовом поле продолжала выдавать исходный запомненный ответ. Само наличие графа поэтому ещё не гарантирует, что другой вывод модели зависит от него.
Метод проверяли на трёх наборах арифметических задач и двух наборах формальных доказательств, используя Gemma 2, Llama 3.2, Falcon 3 и Qwen3. Границы работы проходят по типу задачи: решение должно раскладываться на явные операции или зависимости между утверждениями. Открытые рассуждения на естественном языке в эксперименты не входили.
Когда граф стоит закладывать в архитектуру продукта
Работа меняет планы систем, где важен не текст рассуждения, а воспроизводимый результат: расчётов, правил ценообразования, проверки ограничений и формальных доказательств. Для них граф можно сделать контрактом между LLM и обычным программным кодом.
Модель в такой архитектуре не должна одновременно быть автором вычисления и окончательного ответа. Она строит граф, валидатор проверяет формат и допустимые операции, исполнитель вычисляет результат, а продукт показывает или использует именно его. Случай GSM8k+ показывает, почему отдельному ответу модели доверять нельзя, даже если рядом лежит правильный граф.
Поменяется и подготовка данных. Одних пар «задача — ответ» недостаточно: для первого этапа нужны эталонные графы с промежуточными узлами. При этом эксперимент с удалением отдельных наград показал, что совпадение узлов с эталоном не всегда повышает точность, тогда как проверка формата и правильного результата влияла сильнее.
Для продукта это скорее основание для ограниченного прототипа, чем для замены существующего контура рассуждений. Сначала стоит выбрать процесс, который уже можно представить ориентированным графом, задать небольшой набор операций и сравнить точность, длину вывода и долю неисполняемых графов с текущей схемой. Для универсального помощника или задач без формальной структуры эта работа пока не даёт достаточного основания менять архитектуру.
Источники
Иллюстрация: рисунок из статьи «Structural Chain-of-Thought: Reasoning with Executable Computational Graphs», Petr Senatorov, Karim Vafin, Elena Tutubalina и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


