
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
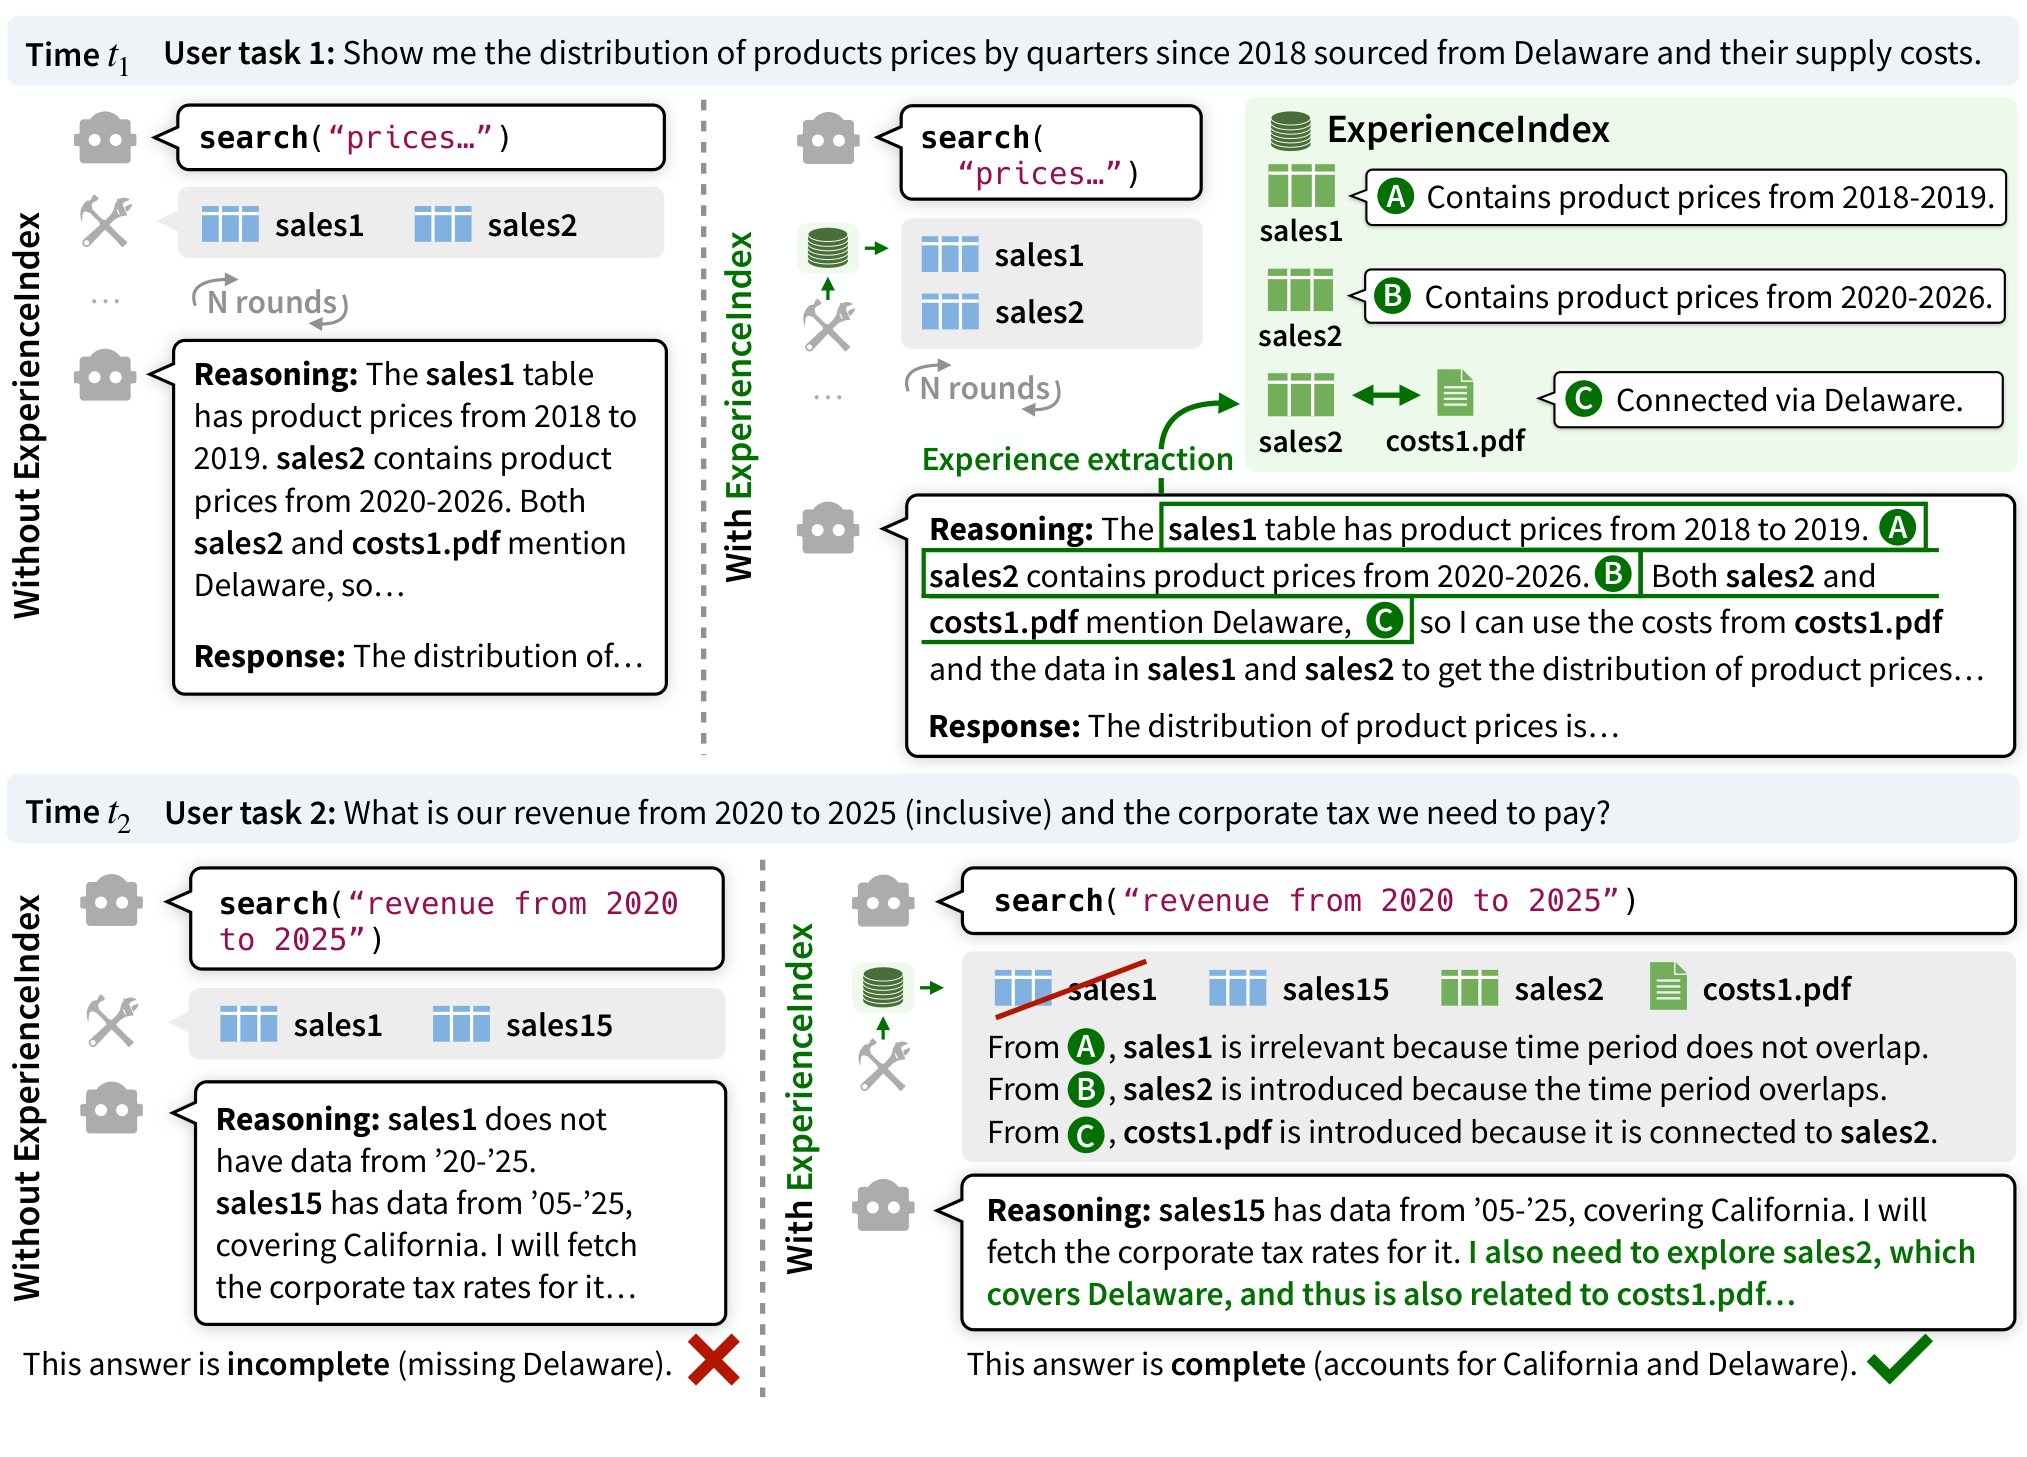
Для ИИ-агентов предложили память, которая сохраняет не общий ход рассуждения, а опыт работы с конкретными документами, таблицами и файлами. В нерецензированном препринте команды MIT и партнёров, где числа получили сами авторы, ExperienceIndex повысил качество ответов до 11 баллов и сократил стоимость новых запросов до 50,5%. Такой слой можно добавить поверх существующего поиска, не перестраивая агента и не обрабатывая весь корпус заранее.
Память хранит вклад документа и связи с соседями
Обычный агент при каждой задаче заново обходит корпус: формулирует поисковые запросы, читает найденные материалы и проверяет перекрёстные ссылки. Память о предпочтениях пользователя или общих приёмах рассуждения здесь помогает мало. Агенту нужно помнить, что лежит в конкретном файле, для каких задач он уже пригодился и с какими другими файлами связан.
ExperienceIndex сохраняет опыт на двух уровнях. Для отдельного артефакта — документа, таблицы или файла с кодом — система записывает описание прошлой задачи, краткое объяснение вклада артефакта и использованные фрагменты с указанием их расположения. Например, запись может сообщать, что таблица содержит продажи за нужный период, а налоговый документ не упоминает требуемый штат.
Второй уровень описывает пары артефактов. Такая запись фиксирует, что две таблицы можно соединить по определённым столбцам или что документ связан с таблицей через общую организацию, территорию либо другой объект. Эти связи нужны для полноты: поиск может найти первый материал, а память добавит второй, без которого ответ останется частичным.
При новом запросе система сначала ищет похожие записи по их векторным представлениям. Затем отдельная LLM классифицирует найденные артефакты как релевантные, нерелевантные или сомнительные. Для релевантных материалов ExperienceIndex проходит по сохранённым связям и проверяет соседние артефакты тем же способом.
Результат попадает в два места: в начальный контекст модели и в ответы поисковых инструментов. После завершения задачи система извлекает новый опыт из хода работы и ставит обновление памяти в очередь. Перед использованием агент сверяет старые записи с текущим содержимым артефакта и при расхождении доверяет самому артефакту.
Экономия появляется на повторных задачах
В среднем ExperienceIndex улучшил итоговую оценку ответа на 3,9% относительно сильнейшего варианта сравнения EnrichIndex. Одновременно текущие расходы на обработку запросов снизились на 20,8%. В эту стоимость входит работа агента во время новой задачи, поэтому результат отражает сокращение повторного поиска и чтения, а не только более дешёвое хранение.
Разница с EnrichIndex начинается на этапе подготовки корпуса. EnrichIndex заранее просматривает каждый документ и создаёт дополнительные аннотации. ExperienceIndex обрабатывает только артефакты, которые встретились в выполненных задачах, поэтому его расходы на построение индекса оказались в 115 раз ниже, а хранилище — в 73 раза меньше.
Память переносилась между типами задач. Опыт, собранный при переводе запросов на естественном языке в SQL на Spider, помогал отвечать на фактологические вопросы MMQA по тем же таблицам. Следовательно, запись привязана не к формату исходной задачи, а к содержимому общего корпуса.
Авторы также проверили схему «учитель—ученик»: более сильная модель создавала записи, а более слабая использовала их при новых запросах. Слабая модель достигала сопоставимого качества с сильной при меньшей стоимости. Это позволяет вынести дорогое изучение корпуса в отдельный процесс, а пользовательские запросы обслуживать более дешёвой моделью.
Проверка охватывала GPT-5-Mini и Gemini-3-Flash, разные поисковые схемы и корпуса с диалогами, таблицами, научными материалами и кодом. В сравнение вошли агент без памяти, память об общих приёмах рассуждения и предварительное обогащение всего корпуса. Результаты относятся к задачам, где запросы повторно используют общий набор артефактов.
Архитектуру стоит менять вокруг стабильных идентификаторов
Работа меняет планы команд, которые строят поиск по внутренним документам, базе исследований, таблицам или репозиторию. Вместо расширения каждого поискового запроса можно добавить промежуточный слой, который накапливает знания по мере реального использования корпуса. Это убирает обязательную предварительную обработку всех материалов и позволяет начать с пустой памяти.
Для внедрения поисковая система должна возвращать стабильный идентификатор вместе с содержимым артефакта. Хранилищу понадобятся записи об отдельных материалах, связи между их идентификаторами и векторный поиск по описаниям прошлых задач. Обновление можно выполнять после ответа, поэтому оно не обязано увеличивать задержку пользовательского запроса.
Отдельно следует сохранить проверку старого опыта по текущему документу. Без неё ошибка модели или изменившийся файл превращают память в источник устаревших подсказок. Эксперимент с удалением этой проверки снизил качество ответов, поэтому для рабочей системы это часть основного контура, а не дополнительная мера.
Если каждый запрос работает с новым корпусом, ExperienceIndex почти нечего переиспользовать. Метод рассчитан на повторяемый доступ к одним и тем же материалам: договорной базе, документации, таблицам аналитики или коду продукта. Чем больше задач прошло через такой корпус, тем полезнее становится накопленный слой.
Источники
Иллюстрация: рисунок из статьи «ExperienceIndex: Artifact-Grounded Memory», Peter Baile Chen, Geoffrey X. Yu, Xinming Liu и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


