
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
У языковых агентов обнаружили два разных вида забывания: сначала модель перестаёт находить ранее выученный навык, а затем теряет и способность его исполнить. В препринте команды Harbin Institute of Technology, Great Bay University и Zhejiang University правильное имя навыка подняло точность выполнения с 0 до 69,85%, хотя работа не рецензирована и все числа получили сами авторы. Разделение этих сбоев позволяет не переучивать всю модель, а отдельно защищать исполнение и обновлять доступ к нему.
Правильное имя возвращает забытый навык
Работа рассматривает внутреннее усвоение навыков: процедурные инструкции переносят в параметры модели, чтобы при работе не искать и не добавлять в контекст внешнюю карточку навыка. Агент получает только исходный запрос и должен сам выбрать операции, заполнить аргументы и построить последовательность действий.
При последовательном обучении новым семействам навыков старые способности быстро переставали проявляться. На контрольной точке модель не выполнила точно ни один из 408 старых запросов. Когда к тем же запросам добавили каноническое имя нужной процедуры, точность выросла с 0 до 69,85%.
Имя не содержало аргументов, шагов или готового результата. Оно лишь указывало, какую процедуру нужно вызвать. Поэтому исполнение в параметрах модели ещё сохранялось, но связь между формулировкой запроса и нужным навыком уже разрушилась.
Этот опыт не доказывает, что адрес — нейтральная подсказка: каноническое имя раскрывает идентификатор требуемой операции. Авторы используют его как диагностический тест. Если подсказка возвращает результат, сломан доступ; если не возвращает, повреждено само исполнение.
При дальнейшем обучении переставала помогать и подсказка. Такой порядок повторился для SFT, GRPO и SKILL0: сначала модель теряла адрес навыка, затем — условную способность выполнить процедуру по правильному адресу. Значит, единая метрика итогового ответа скрывает два разных источника ошибки.
FSM замораживает исполнителей, но продолжает учить адресацию
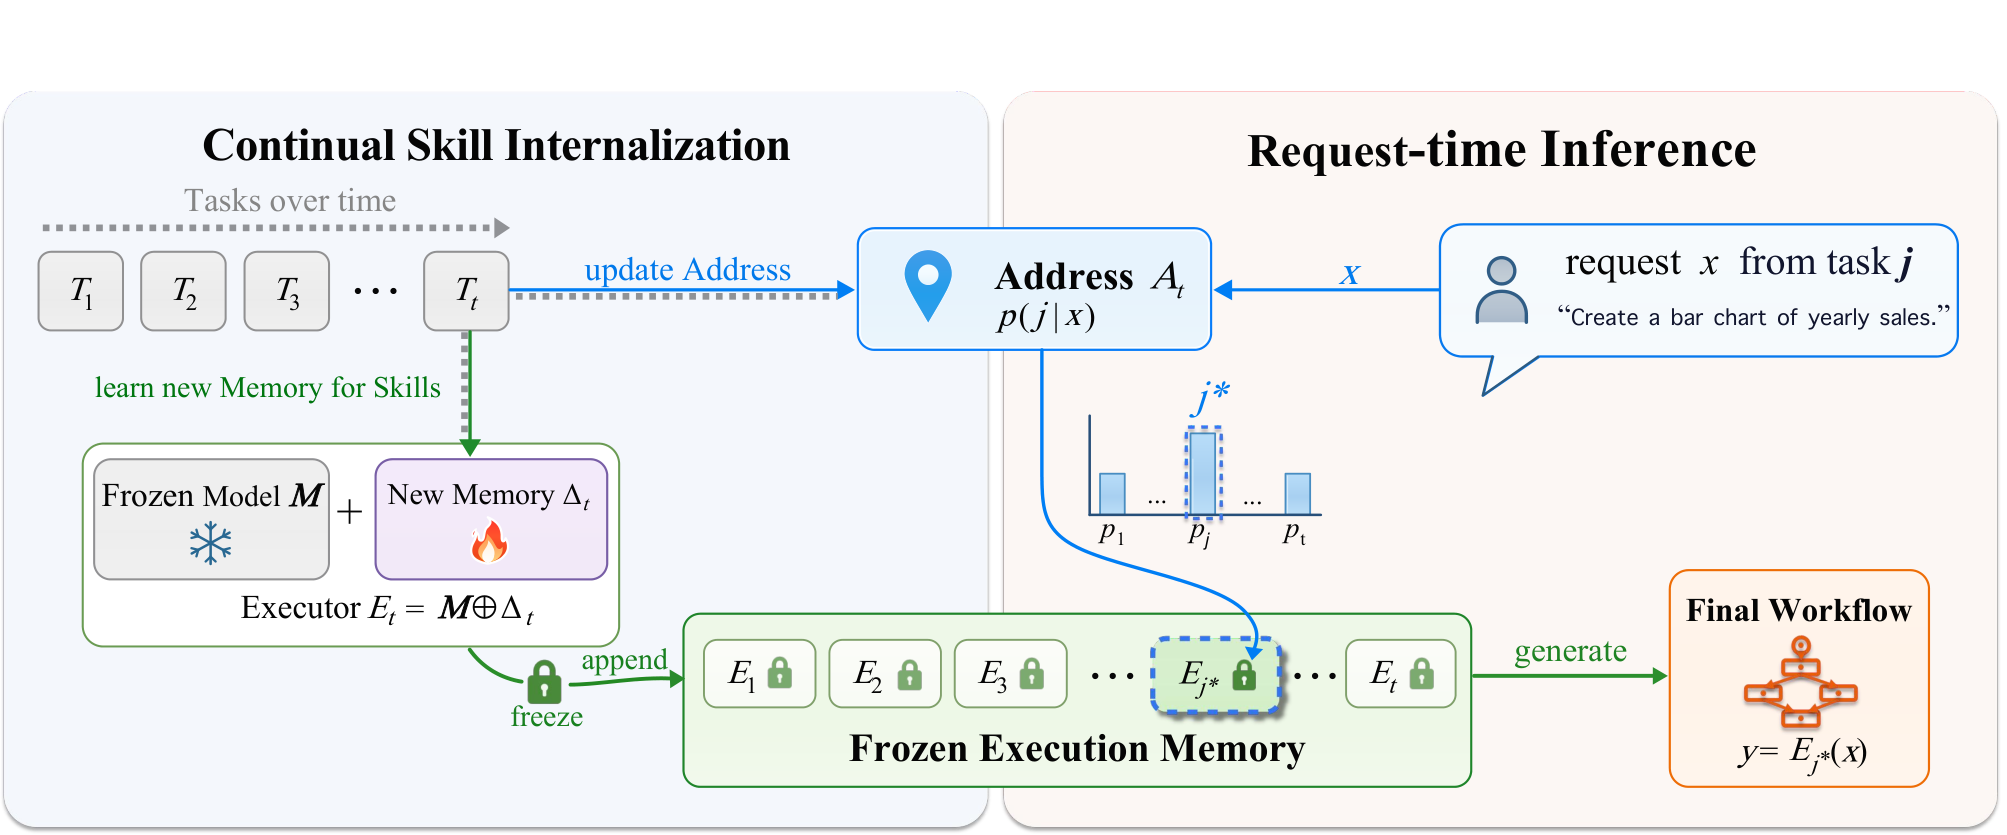
Factorized Skill Memory, или FSM, делит память агента на адресную и исполнительную. Адресная память сопоставляет запрос с семейством навыков. Исполнительная состоит из отдельных LoRA-адаптеров, каждый из которых хранит процедуры одного семейства.
На очередном этапе FSM обучает новый адаптер только на текущих данных, затем замораживает его и добавляет в банк исполнителей. Старые адаптеры больше не меняются. Параллельно адресная память учится направлять новые запросы в нужный модуль и после обновления не хранит прежние запросы или траектории выполнения.
Во время работы лёгкий классификатор выбирает один исполнительный модуль, после чего модель делает одну генерацию. Выбор модуля ещё не решает задачу: внутри него агент должен определить конкретные операции, связать их между собой и подставить значения из запроса.
Метод проверяли на 100 навыках TaskBench, разделённых на пять последовательных семейств; основные сравнения провели на Qwen3-8B в разных порядках обучения. Точное совпадение засчитывали только тогда, когда модель целиком воспроизводила требуемый граф действий. FSM получила в среднем 65,95% и обошла сильнейший вариант без старых примеров, Progressive-LoRA, на 14,3 процентного пункта.
Такая постановка проверяет запросы, чьи операции лежат внутри одного семейства. Адресная память всегда выбирает один модуль, поэтому результаты не показывают, как схема поведёт себя, если один рабочий процесс требует навыков сразу из нескольких модулей.
Планы стоит менять только для непрерывно обучаемых агентов
Для системы с постоянным набором процедур работа почти ничего не меняет. Внешний поиск карточек навыков или обычный выбор инструмента остаётся проще, если инструкции можно хранить отдельно и передавать модели при каждом вызове.
FSM становится практичной архитектурной гипотезой, когда агент регулярно получает новые процедуры, старые обучающие данные хранить нельзя, а добавлять длинные инструкции в каждый запрос нежелательно. В такой системе полезно разделить изменяемый маршрутизатор и замороженные исполнители, а не продолжать дообучать один общий набор параметров.
Цена разделения — растущий банк адаптеров. Один использованный в работе LoRA-модуль добавляет 15,34 млн параметров, а весь банк занимает 0,94% общей модели. При этом вычисления на запрос не растут вместе с банком: активируется только выбранный адаптер и выполняется одна генерация.
Ближайший практический шаг — не переносить FSM целиком, а добавить двойную проверку удержания навыков. Сначала агент выполняет старый запрос без подсказки, затем получает точное имя процедуры. Если второй вариант исправляет ответ, команде следует улучшать маршрутизацию; если оба дают сбой, нужно изолировать параметры исполнителя или возвращать старые примеры в обучение.
Переходить на такую схему только по итогам этой работы рано: её проверили на одном наборе процедур с заранее заданным делением на семейства. Но сам диагностический разрез уже полезен для архитектуры — ошибка выбора навыка и ошибка его выполнения требуют разных исправлений.
Источники
Иллюстрация: рисунок из статьи «When Skills Remain But Access Fails: Factorized Skill Memory for Continual Skill Internalization», Haomiao Qiu, Yining Tang, Hongyi Wan и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


