
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Итоговый балл длинного ИИ-агента не доказывает, что он лучше соперника: разница может появиться из-за входных данных, бюджета или способа оценки. В препринте, который не проходил рецензирование и приводит числа, полученные самими авторами, новый тест превратил обычную таблицу лидеров в частичный порядок, где часть сравнений пришлось отклонить. Для команд это меняет не выбор конкретной модели, а схему испытаний перед таким выбором.
Окно сравнения отделяет этап от его окружения
Агент для обзора литературы последовательно ищет статьи, отбирает их, извлекает факты, строит план и пишет текст. Финальная оценка смешивает качество всех этапов. Если один агент получил готовую библиографию, а другой искал источники сам, более высокий балл первого ещё ничего не говорит о качестве его поиска или написания текста.
Авторы называют свой подход составной управляемостью (compositional controllability). Сначала оценщик задаёт окно сравнения: один этап, несколько этапов или весь агент. Для окна фиксируют общий вход и способ измерить результат на выходе.
То, что находится внутри окна, считается проверяемой способностью. Всё снаружи относят к помехам: различиям во входных материалах, последующей обработке, доступном бюджете и протоколе запуска. Поэтому при сравнении модулей написания текста поиск должен дать им одинаковые материалы. При сравнении целых систем разные способы поиска, напротив, остаются внутри окна и входят в оцениваемую способность.
До просмотра итоговых баллов оценщик задаёт допустимый радиус помех. Если внешние различия нельзя удержать в этих пределах, метод отказывается сравнивать системы. Это принципиально отличается от обычной проверки статистической значимости: больше заданий уменьшит случайную погрешность, но не исправит систематически разные входы.
Для допустимой пары разница должна превышать сумму статистической погрешности и радиуса помех. В противном случае результат остаётся неопределённым. Вместо обязательного места в таблице система получает интервал возможных мест, совместимый только с подтверждёнными отношениями между парами.
Обычная таблица присвоила победы несопоставимым системам
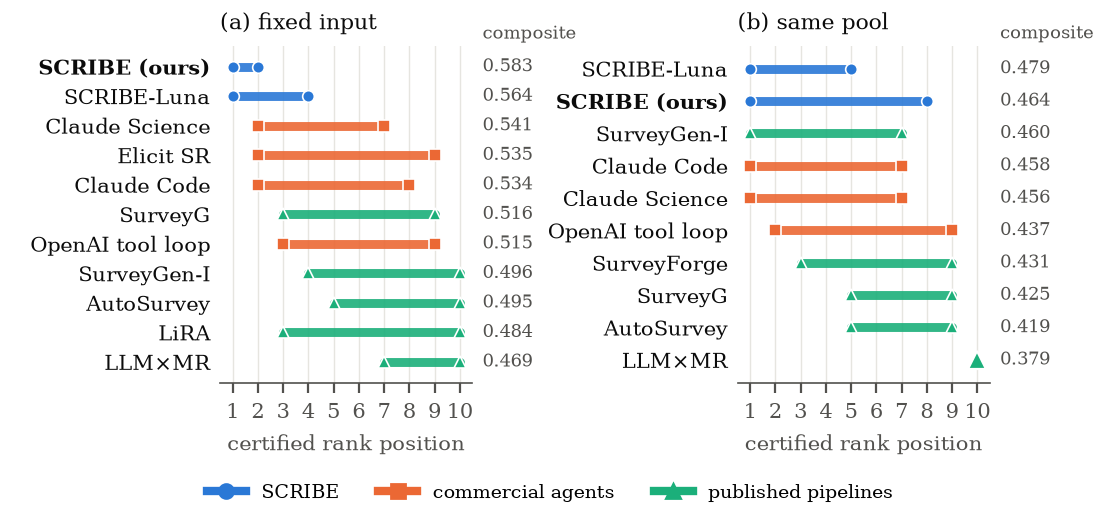
В сравнении опубликованных решений обычный статистический анализ нашёл победителя в 14 из 21 пары. Проверка допустимости отказалась сравнивать 11 пар, включая все пары с системой, которая возглавляла исходную таблицу. Только она получила библиографию целевого обзора, поэтому её преимущество нельзя было отделить от преимущества во входных данных.
Отказ не означает, что системы равны или что лидер слабее. Он означает более узкую вещь: проведённый эксперимент не позволяет приписать разницу выбранному этапу. Чтобы сравнивать именно устройство конвейера, авторы требовали одинаковых входов и одной базовой модели; при проверке целого агента модель можно включить внутрь окна.
Тот же принцип применили к обучению SCRIBE на Qwen3.8-27B. Каждый этап начинался с зафиксированного артефакта, а награда измерялась на его выходе, а не только по готовому обзору. При одинаковых материалах SCRIBE получил подтверждённый интервал мест [1,2] и оказался выше проверенных опубликованных решений, а также агентов Claude и OpenAI. Сравнение с тем же агентным каркасом без обучения осталось неопределённым.
Командам стоит менять протокол испытаний, а не стек
Работу проверяли на BioLitBench — наборе из 2 042 биомедицинских статей, представленных как графы утверждений и связей. Системы запускали либо с общей библиографией, либо с самостоятельным поиском по одному зафиксированному корпусу. Сравнение охватывало опубликованные конвейеры, коммерческие агенты и SCRIBE.
Такой масштаб позволяет проверить метод на длинном прикладном процессе, но не превращает результат в универсальный рейтинг агентов. Оценка показывает согласие текста с содержанием человеческих обзоров. Она не подтверждает клиническую корректность, безопасность или то, что агент действительно опирался на выданные источники.
Практический вывод касается архитектуры испытаний. Если команда выбирает между агентными конвейерами, ей стоит заранее записать, что именно сравнивается: поиск, синтез, написание или весь процесс. Затем нужно зафиксировать вход этапа, базовую модель, бюджет, способ наблюдения за выходом и правило для длины результата.
Последний пункт способен перевернуть таблицу. При ограничении длины AutoSurvey занимал третью позицию среди систем с готовой библиографией, а без ограничения вышел на первое место. Его медианный отчёт содержал около 250 000 слов против диапазона 10 000–47 000 у остальных. Оба результата отвечают на разные продуктовые вопросы, поэтому правило длины нужно выбирать до просмотра оценок.
Если система уже разделена на этапы с сохраняемыми артефактами, подход можно встроить без смены моделей: воспроизводить общий вход, оценивать выход каждого этапа и оставлять спорные пары без победителя. Для закрытых сервисов без доступа к промежуточным состояниям метод полезен прежде всего на уровне целого агента. Работа не даёт готового отраслевого стандарта, но предлагает проверяемое правило: сначала доказать сопоставимость условий и только потом ранжировать результаты.
Источники
Иллюстрация: рисунок из статьи «What Can a Leaderboard Certify? Compositional Controllability for Fair Evaluation and Training of Biomedical Literature-Review Agents», Zhaowei Han, Xiang Zhang, Lingxiao Guan и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


