
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Контур обучения с подкреплением удалось собирать автоматически: от входных данных и награды до алгоритма и настроек обучения. На задаче Adroit Hand Relocate система FARL достигла 97,1% успешных попыток после 5 млн шагов против 0% у Eureka и LiMEN; это результат препринта, который не прошёл рецензирование и приводит замеры самих авторов. Для команд это расширяет область автоматизации: LLM может искать не отдельную функцию награды, а согласованную конфигурацию всего эксперимента.
Награда, наблюдения и алгоритм зависят друг от друга
Обычно автоматизированный поиск в обучении с подкреплением меняет один слой системы. Eureka генерирует программы награды, а LiMEN подбирает награду вместе с представлением наблюдений, но оставляет алгоритм и его настройки фиксированными.
Такое разделение упрощает поиск, но плохо работает при неоднозначном сбое. Если агент не выполняет задачу, причина может быть в награде, которая поощряет побочное поведение, в недостаточных входных данных или в алгоритме, который не осваивает предложенный интерфейс. Изменение одного компонента также меняет полезность остальных.
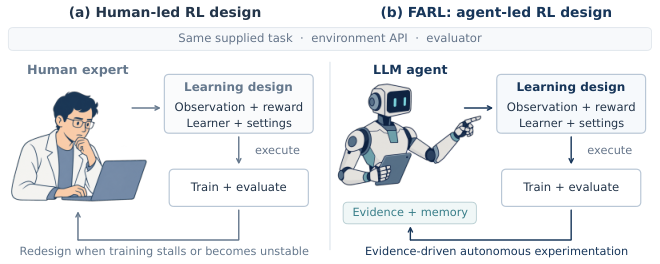
FARL рассматривает всё это как единое пространство дизайна. Система получает описание задачи, API среды, разрешённые поля наблюдений, действия, фиксированную функцию оценки и предел вычислений. Затем она создаёт программу подготовки наблюдений, программу награды, выбирает алгоритм обучения, сеть, настройки и способ исследования среды.
Программы наблюдений могут выбирать координаты или вычислять расстояния и разности. Награда может учитывать переходы между состояниями, действия и историю текущего эпизода. Один и тот же вариант награды остаётся в банке компонентов, даже если не сработал с конкретным алгоритмом: FARL может позднее проверить его в другой комбинации.
FARL превращает поиск в серию проверяемых экспериментов
Сначала случайные действия и небольшой пробный агент собирают траектории. Они показывают, какие изменения состояния вообще доступны и на каком этапе агент перестаёт продвигаться. В экспериментах без экспертной конфигурации предложения создавала модель с обозначением gpt-5.4.
Кандидаты проходят обучение поэтапно. Короткий запуск проверяет, исполняется ли конфигурация и появляются ли промежуточные навыки. Нулевой итоговый результат на этой стадии ещё не исключает вариант: медленно обучающийся агент может позднее обойти раннего лидера.
Система сохраняет не только лучшие конфигурации. Она оставляет кандидатов, которые продолжают улучшаться, представляют другой способ решения или нужны как контроль для проверки гипотезы. Это защищает поиск от преждевременного выбора одной награды или одного алгоритма.
Диагностическая LLM сопоставляет кривые обучения, статистику оптимизатора, промежуточные этапы поведения и итоговую оценку. Если агент касается объекта, но не переносит его к цели, система может проверить две разные причины: награда не поощряет удержание или наблюдения плохо описывают направление к цели. Для сравнения FARL фиксирует остальные компоненты, предсказывает ожидаемое изменение поведения и запускает контрольный вариант.
Результат вместе с условиями попадает в экспериментальную память. Неудача не превращается в безусловный запрет: запись указывает, с каким алгоритмом, бюджетом и интерфейсом проверяли компонент. Для задач с редкими поздними состояниями FARL также использует обученную политику как временного помощника, но итогового агента оценивает самостоятельно с обычного начального состояния.
Работа оправдывает пилот, но не сокращает вычислительный бюджет
Метод проверяли на DoorKey, Ant, Meta-World Door-Open и Adroit Hand Relocate. Набор охватывает навигацию, перемещение, открывание двери и манипуляцию роботизированной кистью. В одних опытах готовые экспертные награды и дополнительные признаки скрывали, в других разрешали использовать их как исходную конфигурацию.
Без экспертного дизайна FARL завершил DoorKey, тогда как выбранные конфигурации Eureka и LiMEN задачу не завершили. На Ant агент прошёл в 3,3 раза дальше Eureka при сопоставимом бюджете обучения выбранной политики. На более простой Door-Open все автоматизированные методы справились, поэтому преимущество проявилось прежде всего там, где приходится согласовывать несколько частей контура.
Цена результата — широкий поиск. На Adroit Hand Relocate полный поиск FARL потребовал 408,4 млн взаимодействий со средой против 55 млн у LiMEN, то есть примерно в семь раз больше. Сравнение отдельных итоговых политик этого расхода не показывает: значительная часть вычислений ушла на отклонённые варианты и контрольные эксперименты.
Работа меняет планы команд, у которых основная сложность лежит не в обучении готовой политики, а в формулировке задачи. Вместо последовательной ручной настройки награды, признаков и алгоритма можно строить единый автоматизированный цикл с фиксированной внешней оценкой, журналом гипотез и повторным использованием компонентов.
Начинать разумно с ограниченного пилота, где результат можно однозначно измерить и где симулятор позволяет дешёво запускать параллельные варианты. FARL пока подтверждает подход на конкретных средах и алгоритмах из Stable-Baselines3. Эти опыты не показывают, что такой поиск окупится в среде с дорогими физическими испытаниями или медленной обратной связью, но дают архитектуру для автоматизации самого процесса проектирования.
Источники
Иллюстрация: рисунок из статьи «FARL: A Fully Automated Pipeline of RL Interface and Solver Design», Tianyu Jin, Liuyu Xiang, Chaowen Yang и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


