Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Поиск перспективных молекул, белковых структур и изображений в скрытом пространстве генеративной модели удалось ускорить так, что служебные расчёты занимают меньше секунды на шаг. В препринте Donney Fan и соавторов, который не прошёл рецензирование и приводит числа из замеров самих авторов, новый подход работает как минимум в 100 раз быстрее сравненных методов при сопоставимом или лучшем качестве найденных вариантов. Для команд это снимает прежний конфликт: оценка кандидата может занимать секунды, а выбор следующего кандидата — минуты.
Почему оптимизация проигрывала простому перебору
Генеративная модель переводит числовой вектор из скрытого пространства в молекулу, изображение или другую структуру. Программная проверка присваивает результату оценку, после чего байесовская оптимизация строит дешёвую модель этой оценки и направляет следующие запросы в перспективные области.
Обычно такой дешёвой моделью служит гауссовский процесс. После каждого нового результата его нужно заново настроить, а затем численно найти точку, где функция выбора обещает лучший баланс между исследованием неизвестных областей и улучшением уже найденного решения.
Эти расчёты плохо сочетаются с дешёвыми проверками. При умеренном размере задачи настройка гауссовского процесса может занимать от 20 минут, тогда как генерация и оценка молекулы укладываются в 3 секунды и составляют около 0,2% всего цикла. Параллельная случайная выборка в такой ситуации успевает проверить больше вариантов, хотя расходует их менее экономно.
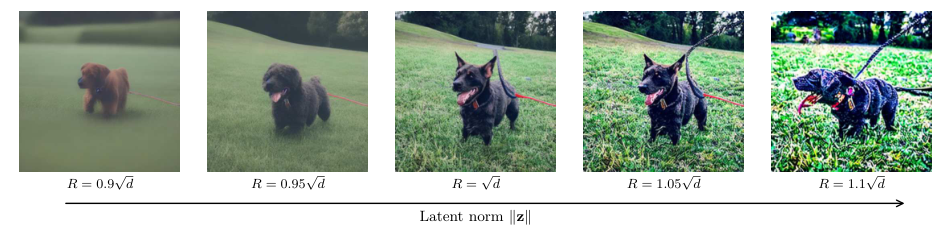
Проблему усиливает форма области поиска. Генеративные модели обычно обучаются на распределениях, где векторы сосредоточены в тонком сферическом слое. Стандартная оптимизация ищет внутри куба и часто уходит далеко от этого слоя: декодер получает непривычные входы, создаёт бессмысленные варианты, а несовершенная функция оценки иногда присваивает им высокий балл.
Сфера превращает многомерный поиск в короткие вычисления
Новый метод оставляет поиск на всей поверхности сферы, соответствующей типичной норме скрытых векторов. Это не только удерживает запросы в знакомой генеративной модели области, но и создаёт симметрию, которой нет у куба или у части сферы, полученной его геометрическим преобразованием.
Вместо гауссовского процесса используется линейная модель. Она предсказывает оценку кандидата по направлению его скрытого вектора. Такой выбор выглядит жёстким, но на сфере модели не нужно описывать изменения вдоль радиуса, а именно они часто толкают обычную оптимизацию к границам и нетипичным результатам.
Симметрия упрощает оба дорогих этапа. Среднее значение модели вычисляется напрямую, а уровень шума подбирается одномерным численным поиском. Основную матричную операцию выполняют один раз и затем используют повторно.
Функции выбора следующего кандидата тоже не требуют многомерного градиентного спуска с перезапусками. Для выборки Томпсона достаточно взять случайный вектор весов из распределения модели и спроецировать его на сферу. Максимум ожидаемого улучшения сводится к нескольким матричным операциям и одномерному поиску.
В результате вычислительная сложность по числу накопленных наблюдений снижается с кубической до линейной в заявленном авторами режиме. Оптимизация перестаёт быть отдельной тяжёлой системой рядом с генератором и функцией оценки.
Когда подход меняет архитектуру поискового контура
Метод проверяли на молекулярных задачах GuacaMol, поиске структуры белка с Boltz-2, генерации изображений Stable Diffusion 1.5 и синтетических функциях. В сравнение вошли случайная выборка, TuRBO, Vanilla BO, Linear (Warped) и CMA-ES; на самых крупных задачах часть альтернатив уже нельзя было запускать с приемлемой стоимостью шага.
В скрытом пространстве Stable Diffusion размерностью 16 384 метод находил изображения с более высокой оценкой, чем случайная выборка. Полный цикл при этом занимал в 2–3 раза больше времени, а не на порядки больше, как прежние последовательные схемы.
В задаче с Boltz-2 расчёты оптимизатора занимали в среднем 0,5 секунды на шаг против 5,1 секунды у самой функции оценки. Здесь решение о следующем запросе уже не определяет пропускную способность контура.
Практический пересмотр планов оправдан, если продукт перебирает варианты через заранее обученный генератор, быстро оценивает их программным способом и сейчас использует случайную выборку из-за накладных расходов байесовской оптимизации. В таком контуре сферический линейный метод можно рассматривать как промежуточный вариант: он направляет поиск по накопленным результатам, но сохраняет стоимость, близкую к генерации без адаптации.
Метод рассчитан на достаточно гладкую зависимость оценки от направления в скрытом пространстве. Резкие разрывы, множество разнесённых максимумов и задачи типа «иголки в стоге сена» хуже соответствуют линейной модели. Сферическое ограничение также сохраняет область вероятных генераций, но не гарантирует, что лучший по целевой функции вариант лежит именно там; поэтому подход не рассчитан на намеренный поиск далёких от обучающего распределения конструкций.
Источники
Иллюстрация: рисунок из статьи «Search at the Cost of Sampling: Nearly-Instant Latent Space Bayesian Optimization», Donney Fan, Colin Doumont, Aleksandra Kalisz и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.