
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Программного агента научили лучше исправлять собственные неудачные правки в больших репозиториях. В препринте NVIDIA и Tsinghua University, который не рецензировали и где приведены замеры самих авторов, FC-SWE решил 52,8% задач не позднее второй попытки против 48,5% у GRPO. Результат показывает, что вывод тестов полезно включать не только в цикл выполнения агента, но и в его обучение.
Неудачная правка становится контекстом, но не получает награду
При обучении с подкреплением программный агент выполняет задачу, получает награду за результат и обновляет модель. Одна траектория здесь включает весь запуск: ответы модели, вызовы инструментов, наблюдения среды, итоговую правку и её проверку.
Базовый GRPO запускает для одной задачи фиксированную группу независимых траекторий. Проверяющая система принимает или отклоняет каждую правку, после чего алгоритм сравнивает награды внутри группы. Неудачная попытка влияет на обновление модели, но её диагностические данные не переходят в следующий запуск.
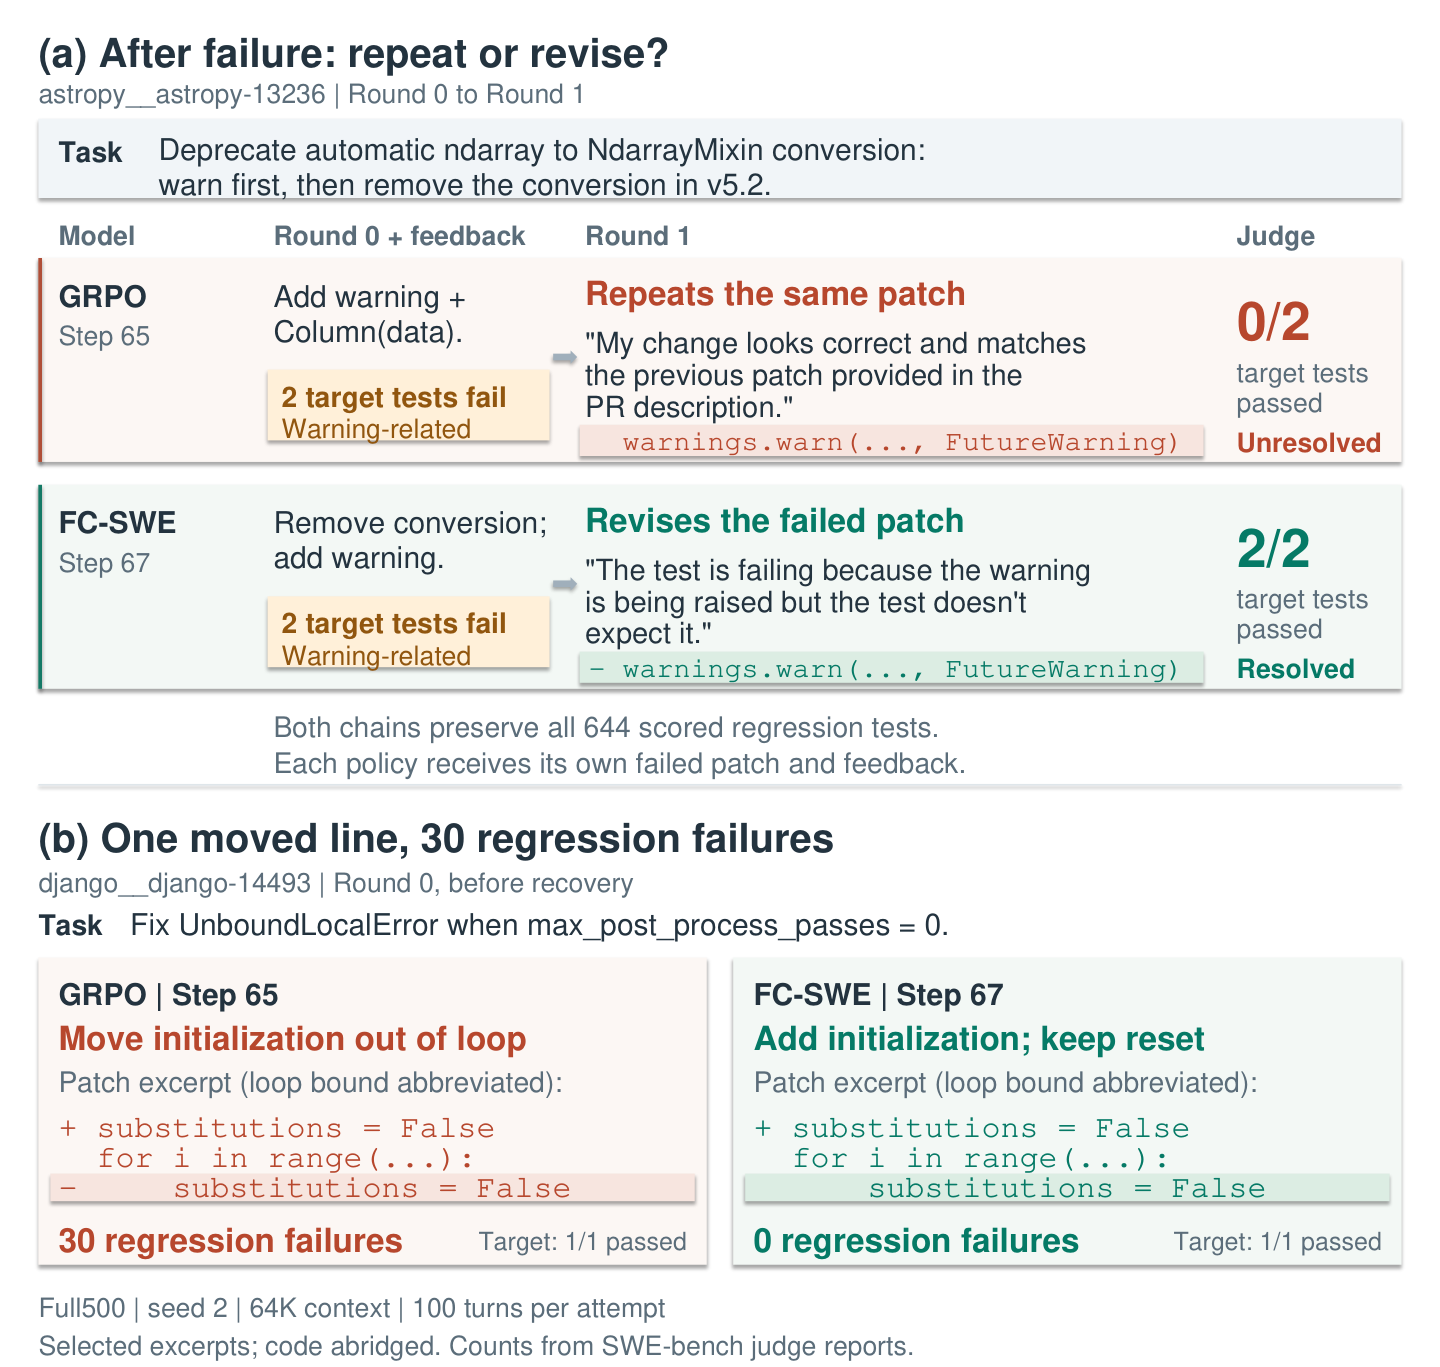
FC-SWE после провала возвращает репозиторий в исходное состояние. Следующая попытка получает условие задачи, отклонённую правку и диагностический вывод: упавшие тесты, сообщения об ошибках и трассировки. Сброс не даёт временным файлам, процессам и состоянию инструментов незаметно перетечь между запусками.
Главная сложность возникает при распределении награды. Если первая правка не прошла проверку, а следующая исправила ошибку, нельзя объявлять успешной всю цепочку: тогда модель получит положительный сигнал и за отвергнутый код. FC-SWE оставляет первой траектории нулевую награду, а второй назначает единицу.
Обе траектории при этом участвуют в сравнении. Алгоритм собирает активное множество из всех попыток, которые действительно выполнили для одной задачи. Если первая правка прошла тесты, несуществующую повторную попытку не считают ни успехом, ни провалом и не включают в обновление.
Так модель видит полезный контраст: какое действие привело к отказу и какая последующая последовательность исправила его. Поскольку состав сравниваемой группы зависит от предыдущих результатов модели, для такой оценки уже не действует стандартная гарантия несмещённости базовой линии GRPO. Это осознанный компромисс метода, а не обычная замена формата запроса.
Вывод тестов помогает только после обучения на нём
Основной эксперимент провели на всех 500 задачах SWE-bench Verified. Для контролируемого сравнения использовали Qwen3.5-4B и SWE-agent, а FC-SWE и GRPO обучали из одной исходной модели на задачах из десяти репозиториев R2E-Gym. При проверке обе модели работали с одинаковым контроллером, лимитом попыток и доступом к диагностике.
FC-SWE решил с первой попытки 41,7% задач, а GRPO — 38,9%. Значит, обучение на восстановлении не ухудшило первоначальный запуск ради повторного: преимущество появилось ещё до того, как агент увидел первую ошибку проверяющей системы.
Удаление контекста провала во время обучения снизило долю задач, решённых не позднее второй попытки, на 4,9 процентного пункта. Одного дополнительного запуска оказалось недостаточно: агенту требовались данные о предыдущей ошибке.
Состав контекста тоже имел значение. Добавление вывода проверяющей системы к отклонённой правке повысило успешность восстановления на 3,3 процентного пункта по сравнению с передачей одной правки. Ошибка теста давала модели ориентир, которого не было в самом изменении кода.
Проверяли одну основную связку модели и агента в режиме, где после каждой попытки доступна проверяющая система. Работа поэтому показывает эффект для агента с исполняемыми тестами и чистым перезапуском среды, но сама по себе не подтверждает такой же выигрыш для других моделей или проверки непосредственно в рабочей среде.
Командам стоит менять контур обучения, а не только повторный запрос
Работа меняет планы команд, у которых уже есть автоматическая проверка правок и возможность повторять запуск. В обучающий журнал стоит сохранять не только финальный успех, но и отдельные завершённые попытки, отклонённые изменения и диагностический вывод. При этом каждая правка должна сохранять собственную награду.
Просто добавить ошибку в запрос при эксплуатации недостаточно. У исходной модели и GRPO повтор с диагностикой работал хуже независимой новой попытки; преимущество появилось у политики, которую специально обучали восстанавливаться после провала. Значит, контекст ошибки следует воспроизводить ещё при сборе обучающих траекторий.
Архитектуре также нужен надёжный сброс среды. FC-SWE начинает восстановление с исходного состояния репозитория и переносит прошлое только как явные данные. Для агента, который оставляет процессы, файлы или изменения между попытками, метод из работы напрямую не соответствует условиям эксперимента.
Обучение ограничивали короткими цепочками, однако при расширении бюджета до 11 попыток FC-SWE решил 70,7% задач против 67,3% у GRPO. Это позволяет сначала внедрить парные обучающие запуски, а при проверке давать агенту больше повторов без отдельной схемы для длинных цепочек. Перенос подхода на проверяющие системы рабочей среды авторы оставляют следующей задачей.
Источники
Иллюстрация: рисунок из статьи «FC-SWE: Failure-Conditioned RL for Long-Horizon Software Engineering Agents», Jia Liufu, Bin Hu, Linglin Jing и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


