
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
При федеративном обучении языковая модель может сама лишить себя полезных подсказок учителя: усреднённое обновление меняет траектории, из которых берутся следующие примеры. В препринте Jinqian Chen, Jihua Zhu и Chang Liu, который не прошёл рецензирование и все числа для которого получили сами авторы, метод FedTOPS прибавил к FedAvg от 4,56 до 14,57 процентного пункта. Для таких систем величина шага становится частью механизма сбора данных, а не только настройкой оптимизатора.
Как агрегация задерживает следующую подсказку
Работа рассматривает федеративную дистилляцию по собственным траекториям модели. Клиенты хранят разные наборы запросов, запускают общую модель, получают от более сильного учителя распределения следующих токенов и локально обновляют ученика. Затем сервер усредняет обновления через FedAvg.
В обычном федеративном обучении набор примеров после усреднения не меняется. Здесь обновлённый ученик сам генерирует последовательности для следующего раунда. Поэтому он одновременно учится и определяет, на каких состояниях учитель сможет обучать его дальше.
Проблема возникает, когда модели сначала нужна промежуточная способность, чтобы добраться до полезной части решения. Например, пока ученик не освоил ранний шаг рассуждения, его ответы редко доходят до места, где учитель может показать следующий шаг. Если усреднение замедляет освоение первой способности, следующий набор траекторий содержит меньше полезных состояний.
Так обычное отставание после агрегации превращается в обратную связь. Модель медленнее движется к нужному состоянию, реже генерирует его, получает меньше подходящих подсказок и ещё сильнее отстаёт в следующем раунде.
Авторы воспроизвели этот механизм в решаемой теоретической модели, где у клиентов один учитель, общая оптимальная точка и устойчивые локальные обновления. Все варианты в итоге сходятся к одной цели, но за ограниченный бюджет обучения FedAvg позже получает доступ к полезному сигналу. Если источник примеров зафиксировать и отвязать от модели, дополнительное отставание исчезает.
Шаг обучения управляет и параметрами, и будущими данными
На малом шаге FedAvg уступил независимому локальному обучению на MATH500 на 0,60 процентного пункта по Avg@8. После трёхкратного увеличения шага тот же способ агрегации уже опередил локальное обучение на 10,51 пункта. Avg@8 показывает среднюю долю правильных решений среди восьми попыток модели.
Шаг обучения выполняет здесь две связанные задачи. Сначала он определяет, насколько модель усвоит текущую подсказку. Затем — сможет ли обновлённая модель дойти до состояний, в которых появятся новые подсказки. Малый стабильный шаг не обязательно безопасен: он может не вывести ученика к нужным траекториям за отведённое время.
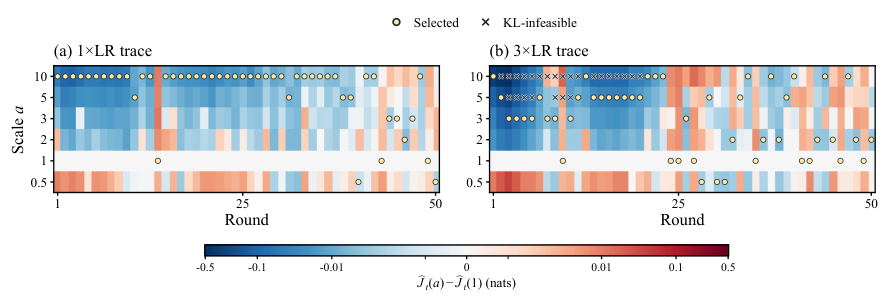
FedTOPS не меняет направление обновления FedAvg, а выбирает, насколько далеко по нему пройти. Перед локальным обучением клиенты сохраняют часть уже сгенерированных позиций и ответы учителя. Сервер проверяет на этом кеше несколько величин шага и выбирает вариант, который лучше согласуется с учителем, но не меняет распределение следующих токенов слишком резко ни у одного клиента.
Для проверки кандидатов не нужны новые траектории и повторные запросы к учителю: метод использует сохранённые ответы. Однако он добавляет вычисления прямого прохода модели, а приведённые замеры времени не позволяют считать их прямым замедлением относительно FedAvg.
Когда результат меняет план разработки
Работа меняет план для систем, где клиенты не передают запросы на сервер, но совместно обучают модель на её собственных ответах. В таком контуре нельзя подбирать локальный шаг только по текущей функции потерь. Нужно также проверять, какие траектории создаст агрегированная модель в следующем раунде.
Практический вариант — вынести величину серверного шага в сам алгоритм и пересчитывать её по ходу обучения. Зафиксированный множитель тоже помогал в отдельных режимах, но подходящий масштаб менялся вместе с локальным шагом и стадией обучения. Ограничение изменения отдельно для каждого клиента защищает от ситуации, когда средний показатель скрывает слишком большой сдвиг на одном наборе запросов.
Переносить результат на любой федеративный проект пока рано. Эксперименты охватили математические задачи, трёх полностью участвующих клиентов, семейство Qwen и по одному запуску каждой конфигурации. Учителем служил Qwen3-8B, учениками — Qwen3-0.6B-Base и Qwen3-1.7B-Base; обновлялись адаптеры LoRA, а качество проверяли на шести наборах задач.
Для обучения на фиксированных данных описанной петли нет: агрегированная модель не определяет состав следующей порции примеров. Но если продукт собирает новые ответы, действия или цепочки рассуждений текущей версией модели, проверка будущего распределения данных должна войти в тестирование агрегации наравне с качеством текущего обновления.
Источники
Иллюстрация: рисунок из статьи «Trapped by Their Own Rollouts: Understanding Aggregation--Rollout Feedback in Federated On-Policy Distillation», Jinqian Chen, Jihua Zhu, Chang Liu, CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


