
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Генераторы с малым числом шагов удалось настраивать по парным предпочтениям, даже когда модель не позволяет напрямую вычислить вероятность конкретного результата. Хотя работа команды KAIST, MongooseAI и Omelet не рецензирована и числа получили сами авторы, на изображениях FestDPO обошёл PSO и DrPO, а на белковых структурах — DrPO. Метод расширяет выбор архитектур для продуктов, которым нужны быстрая генерация и настройка по человеческим оценкам.
Как выборка заменяет недоступную вероятность
Прямая оптимизация предпочтений (DPO) учит модель на тройках: условие, предпочтительный результат и отклонённый результат. Для каждого результата метод сравнивает его вероятность у обучаемой и исходной моделей. Так DPO сдвигает распределение в сторону предпочтений, но не даёт модели слишком далеко уйти от исходного поведения.
У многих генераторов с малым числом шагов такую вероятность вычислить нельзя. Они преобразуют шум в готовый результат напрямую или через несколько переходов, но не предоставляют плотность распределения, которую требует обычная формула DPO. Подходы для диффузионных моделей тоже подходят не всегда: им нужна доступная траектория удаления шума.
FestDPO вместо точного расчёта берёт набор результатов от двух генераторов: обучаемого и его замороженной исходной версии. Затем метод оценивает, насколько плотно их результаты располагаются рядом с предпочтительным и отклонённым примерами. Для этого используется ядерная оценка плотности: близкие образцы дают больший вклад, далёкие — меньший.
Обе модели получают одинаковые исходные шумы. Оценённые плотности подставляются в формулу DPO, после чего градиент проходит только через обучаемый генератор. Модель постепенно приближает свои результаты к предпочтительным примерам и отдаляет от отклонённых, тогда как исходная версия остаётся точкой отсчёта.
Расстояние считают не обязательно в исходных данных. Сравнение отдельных пикселей плохо отражает смысл изображения, а координаты белковой структуры меняются при повороте всей молекулы. Поэтому FestDPO переносит образцы в пространство признаков заранее обученного кодировщика и оценивает плотность уже там. Кодировщик становится частью метода: он определяет, какие результаты считаются похожими.
Авторы также доказывают, что при росте выборки такая оценка сходится к обычной функции потерь DPO, если плотности непрерывны и выполняются условия сходимости. Это объясняет целевое поведение метода, но не гарантирует, что малая выборка даст тот же результат в любой предметной области.
На изображениях выросли человеческие оценки, на белках — нужная структура
Метод проверяли на четырёх синтетических генераторах, двух моделях преобразования текста в изображение — SDXL-Turbo и SDXL-DMD2 — и генераторе белкового каркаса RMF-S. Для изображений модели обучали на предпочтениях Pick-a-Pic v2 и сравнивали с PSO и DrPO. В белковой задаче FestDPO сопоставляли с исходной моделью и DrPO.
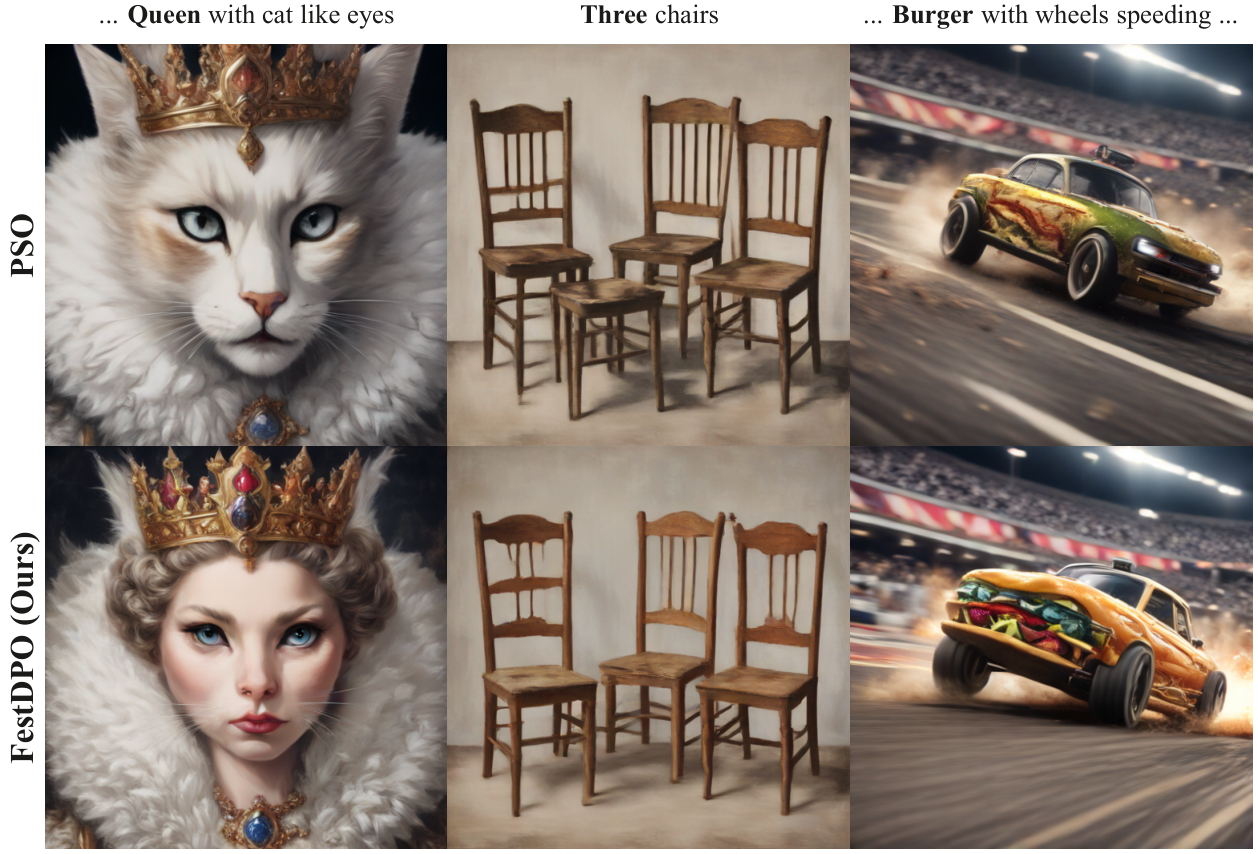
В человеческой оценке изображений FestDPO получил за соответствие запросу 4,199 балла против 3,767 у ближайшего соперника PSO. Метод лидировал и по автоматическим оценкам на тестовых запросах из Pick-a-Pic v2, Parti-Prompts и HPSv2. Этот результат важнее отдельных примеров из статьи: оценщики видели изображения в случайном порядке и не знали, каким методом они созданы.
В генерации белковых каркасов доля аминокислотных остатков в β-слоях выросла до 29,5% против 21,8% у DrPO. FestDPO также снизил расхождение между сгенерированным каркасом и структурой, восстановленной через обратное проектирование последовательности. Разнообразие оказалось выше, чем у DrPO, но ниже, чем у исходной RMF-S.
Эти проверки охватывают изображения и белковые структуры, но используют заранее подготовленные парные предпочтения и подходящие кодировщики признаков. Заявление о переносимости между семействами моделей пока опирается на этот набор задач и одномерный синтетический опыт.
Когда FestDPO меняет архитектурный план
Работа меняет план, если команда выбирает быстрый неявный генератор, но ожидает позже настраивать его по пользовательским сравнениям. Раньше такой выбор мог закрыть путь к DPO или потребовать метода, привязанного к диффузионной траектории. FestDPO показывает другой путь: достаточно получать образцы и пропускать их через дифференцируемый генератор.
За универсальность приходится платить дополнительными генерациями во время обучения. Для каждой пары предпочтений нужны выборки от текущей и исходной моделей, а затем — признаки кодировщика. В опыте с изображениями число образцов меняли от 8 до 24: качество по PickScore менялось слабо, поэтому оценка плотности не потребовала сотен результатов на один пример.
В архитектуре стоит заранее выделить три компонента: неизменяемую исходную модель, набор парных предпочтений и кодировщик, расстояния в котором соответствуют продуктовой задаче. Последний компонент особенно важен для специализированных данных. Если кодировщик смешивает разные по смыслу результаты, FestDPO будет уверенно оптимизировать неверную близость.
Для моделей с доступной вероятностью обычный DPO остаётся прямее: выборочная оценка добавляет вычисления и приближение. FestDPO полезен именно там, где быстрый генератор уже выбран из-за стоимости выдачи, а его неявная природа мешает последующей настройке по предпочтениям.
Источники
Иллюстрация: рисунок из статьи «FestDPO: Few-step Generator Alignment with Direct Preference Optimization», Jaewoo Lee, Kyuil Sim, Hyeongyu Kang и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


