Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Повторяющиеся ошибки системы ответов по финансовой отчётности научились превращать в отдельные исправления поведения, а не в очередную правку общего запроса к модели. В препринте команды SimpleWay.AI и нескольких университетов, который не рецензирован и содержит замеры самих авторов, FinSkillOps поднял взвешенную оценку правильности с 3,70 до 4,55 по шкале до пяти. Для продуктовой команды это превращает самоулучшение из накопления инструкций в управляемый выпуск версий.
Ошибка становится патчем с узкой областью действия
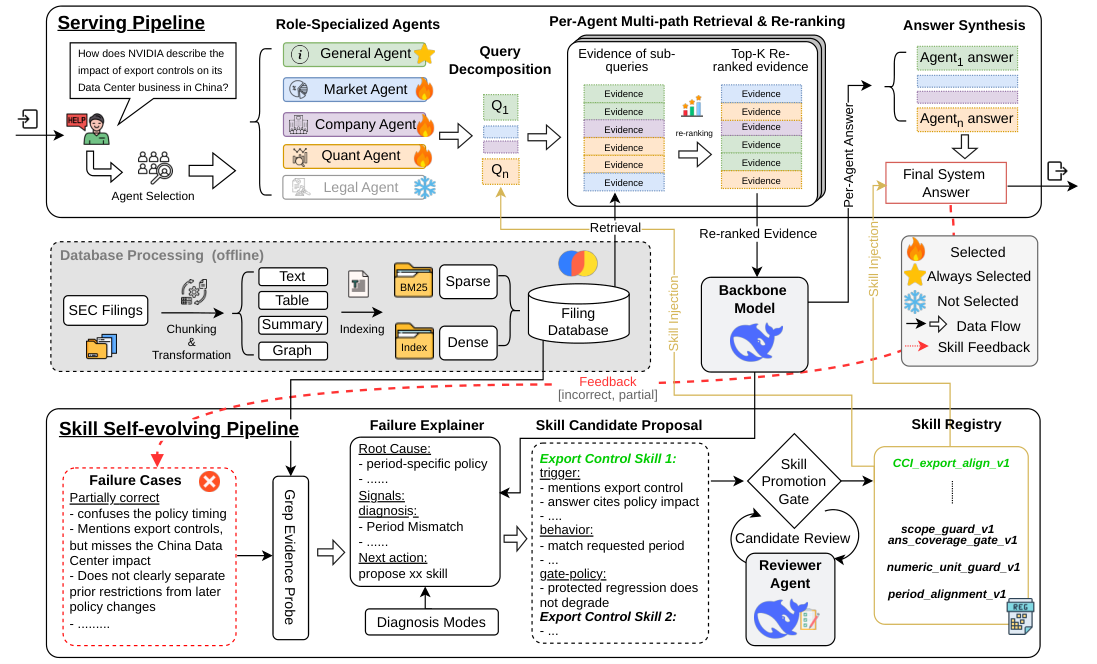
FinSkillOps отвечает на вопросы по документам SEC через несколько специализированных агентов. Они разбивают запрос, ищут сведения разными способами и собирают итоговый ответ. Система хранит текстовые блоки, таблицы и краткие описания разделов вместе с периодом, компанией и типом содержимого.
Главная часть работы начинается после неудачного ответа. Система сопоставляет его с найденными фрагментами отчётности и определяет причину: перепутан период, выбрана другая компания, утверждение не подтверждено источником или расчёт сделан с неверными величинами. Это важнее общей метки «ответ неправильный»: исправление арифметики не должно менять правила выбора отчётного периода.
Для повторяющейся причины модель составляет навык — инструкцию на естественном языке. В записи указаны условия применения, исключения, защита от ложного срабатывания и место в цепочке ответа. Навык может повлиять на разбиение запроса перед поиском либо на финальную сборку утверждений после получения документов.
Новый навык сначала проверяют на примерах с той же ошибкой. Затем систему прогоняют по защищённому набору ранее правильных и рискованных случаев: ни один правильный ответ не должен испортиться. Отдельные отрицательные примеры проверяют, не включается ли инструкция для запросов за другой период, по нескольким компаниям или там, где исправлять ничего не требуется.
Принятый патч получает версию и попадает в реестр. Новая версия может заменить старую, один навык — поглотить другой, а неиспользуемую инструкцию можно удалить после отдельной проверки. В рабочую систему поступает зафиксированный снимок реестра, поэтому фоновая диагностика не меняет поведение ответов сама по себе.
Большинство предложенных исправлений не дошло до рабочей системы
Один замороженный реестр показал лучшую взвешенную правильность и согласованность с эталонными ответами на шести наборах задач. Преимущество оказалось заметнее на внутренних наборах, чем на публичных. По дополнительным критериям результат был неоднородным: конкуренты иногда лучше передавали информацию, рассуждали или формулировали ответ яснее.
В эксплуатационном прогоне система приняла только шесть из 33 предложенных навыков. Доля ответов, которые модель-оценщик не признала полностью правильными, снизилась с 20% до 12,5% на контрольном потоке. Строгий отсев здесь выглядит не побочным эффектом, а центральной частью метода.
Проверка отбрасывала правки, которые помогали целевым примерам, но портили соседние сценарии. Например, инструкция жёстко удерживать одну строку таблицы мешала вопросам, где требовалось собрать величины из нескольких строк. Другая заставляла систему чрезмерно дробить простые запросы и уводила поиск от нужного фрагмента.
Сильнее всего на внутренней проверке помогало выравнивание отчётных периодов. Навык требовал выбирать сведения за период из вопроса, а при конфликте процентов с исходными суммами — заново считать доли по величинам одного периода. Так патч задавал не готовый ответ, а процедуру проверки, которую можно повторить на других документах.
Планы меняет не генерация навыков, а контур их выпуска
Работа предлагает практичную архитектуру для систем, где ошибки повторяются, а неправильный ответ нельзя исправлять ценой новых поломок. Вместо автоматического дописывания общего запроса команде нужен журнал причин, реестр версий, целевые проверки, защищённые случаи и отрицательные примеры. Без этого самоулучшение остаётся неконтролируемым редактированием поведения.
Такой контур можно строить отдельно от обучения модели. Навыки представляют собой инструкции, а диагностика и их подготовка идут вне обработки пользовательского запроса. Это упрощает откат и аудит: для каждого изменения можно сохранить исходные ошибки, результаты испытаний и причину принятия или отказа.
Цена подхода не сводится к тексту навыков. FinSkillOps использовал примерно вчетверо больше токенов, чем FinSage, хотя отдельную стоимость патчей авторы не измеряли. Основную нагрузку создаёт вся многоагентная цепочка, поэтому реестр навыков нельзя считать способом автоматически сократить расходы на ответы.
Проверки охватывали ответы по отчётности SEC на публичных и внутренних наборах, а среди сравнений были Naive RAG, FinSage, FinGPT, MoA и FinDebate. Последовательный прогон также менял маршрутизацию запросов и диагностику ошибок, поэтому он показывает улучшение системы целиком, а не изолированный эффект текстовых патчей. Перенос схемы на поддержку, юридический поиск или внутреннюю аналитику потребует собственных типов ошибок и защищённых наборов.
Источники
Иллюстрация: рисунок из статьи «FINSKILLOPS: A Self-Evolving Multi-Agent System for SEC Filing QA», Yanzhang Ma, Zhenghan Tai, Hanwei Wu и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.