
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Кодирующего агента научили находить шаг, который ведёт к провалу, и исправлять продолжение вместо полного перезапуска задачи. В препринте Jingxuan Xu и коллег, который не рецензирован и где числа получили сами авторы, одна ветка FLARE превзошла пять полных повторов при пятикратном сокращении расхода токенов. Один диагностический компонент работает и во время выполнения задачи, и при последующем обучении агента.
RADAR превращает завершённую траекторию в диагноз каждого шага
Обычная проверка репозитория даёт агенту редкий сигнал: исправление либо прошло тесты, либо нет. Если ошибка проявилась в конце длинной последовательности, такой ответ не показывает, где агент выбрал неверный план, пропустил нужный файл или не проверил внесённое изменение.
В FLARE обучающие сигналы готовит RADAR. Сначала он сжимает каждый шаг до трёх элементов: намерения агента, выполненного действия и полученного результата. Это убирает второстепенные подробности, но сохраняет причинную связь между командами, ответами инструментов и состоянием задачи.
Для неудачных траекторий RADAR идёт от конечного сбоя назад. Он использует различия в исправлениях и результаты тестов, чтобы найти шаги, которые создали или усилили ошибку. Каждому такому шагу назначают уровень риска, тип ошибки и текстовый диагноз; независимые дефекты могут получить отдельные корневые точки.
Успешные траектории обрабатывают иначе. RADAR намеренно искажает план, важное наблюдение, действие или самокоррекцию, затем продолжает выполнение от этой точки. Если агент редко восстанавливается, ошибку считают критической. Так набор охватывает не только сбои, которые уже встретились в исходных запусках.
Финальный диагноз переписывают так, чтобы он опирался только на задачу, текущий шаг и предшествующую историю. Будущие результаты, эталонное исправление и окончательный вердикт используют для разметки, но удаляют из ответа, доступного во время работы. Дополнительный фильтр ищет такие утечки, хотя формальной гарантии их полного отсутствия метод не даёт.
На полученных примерах дообучают Qwen3.5-4B как генеративную модель вознаграждения GRM. Она не должна самостоятельно исправлять репозиторий: её узкая задача — определить риск, классифицировать ошибку и объяснить, какое решение увело агента в сторону.
Один диагноз управляет выполнением, отбором данных и обучением
Во время работы GRM асинхронно проверяет уже завершённый шаг, пока основной агент готовит следующий. Безопасное продолжение проходит без изменений. При критическом риске FLARE отклоняет ещё не выполненное следующее действие и генерирует его заново с учётом диагноза. Уже исполненную команду система не отменяет.
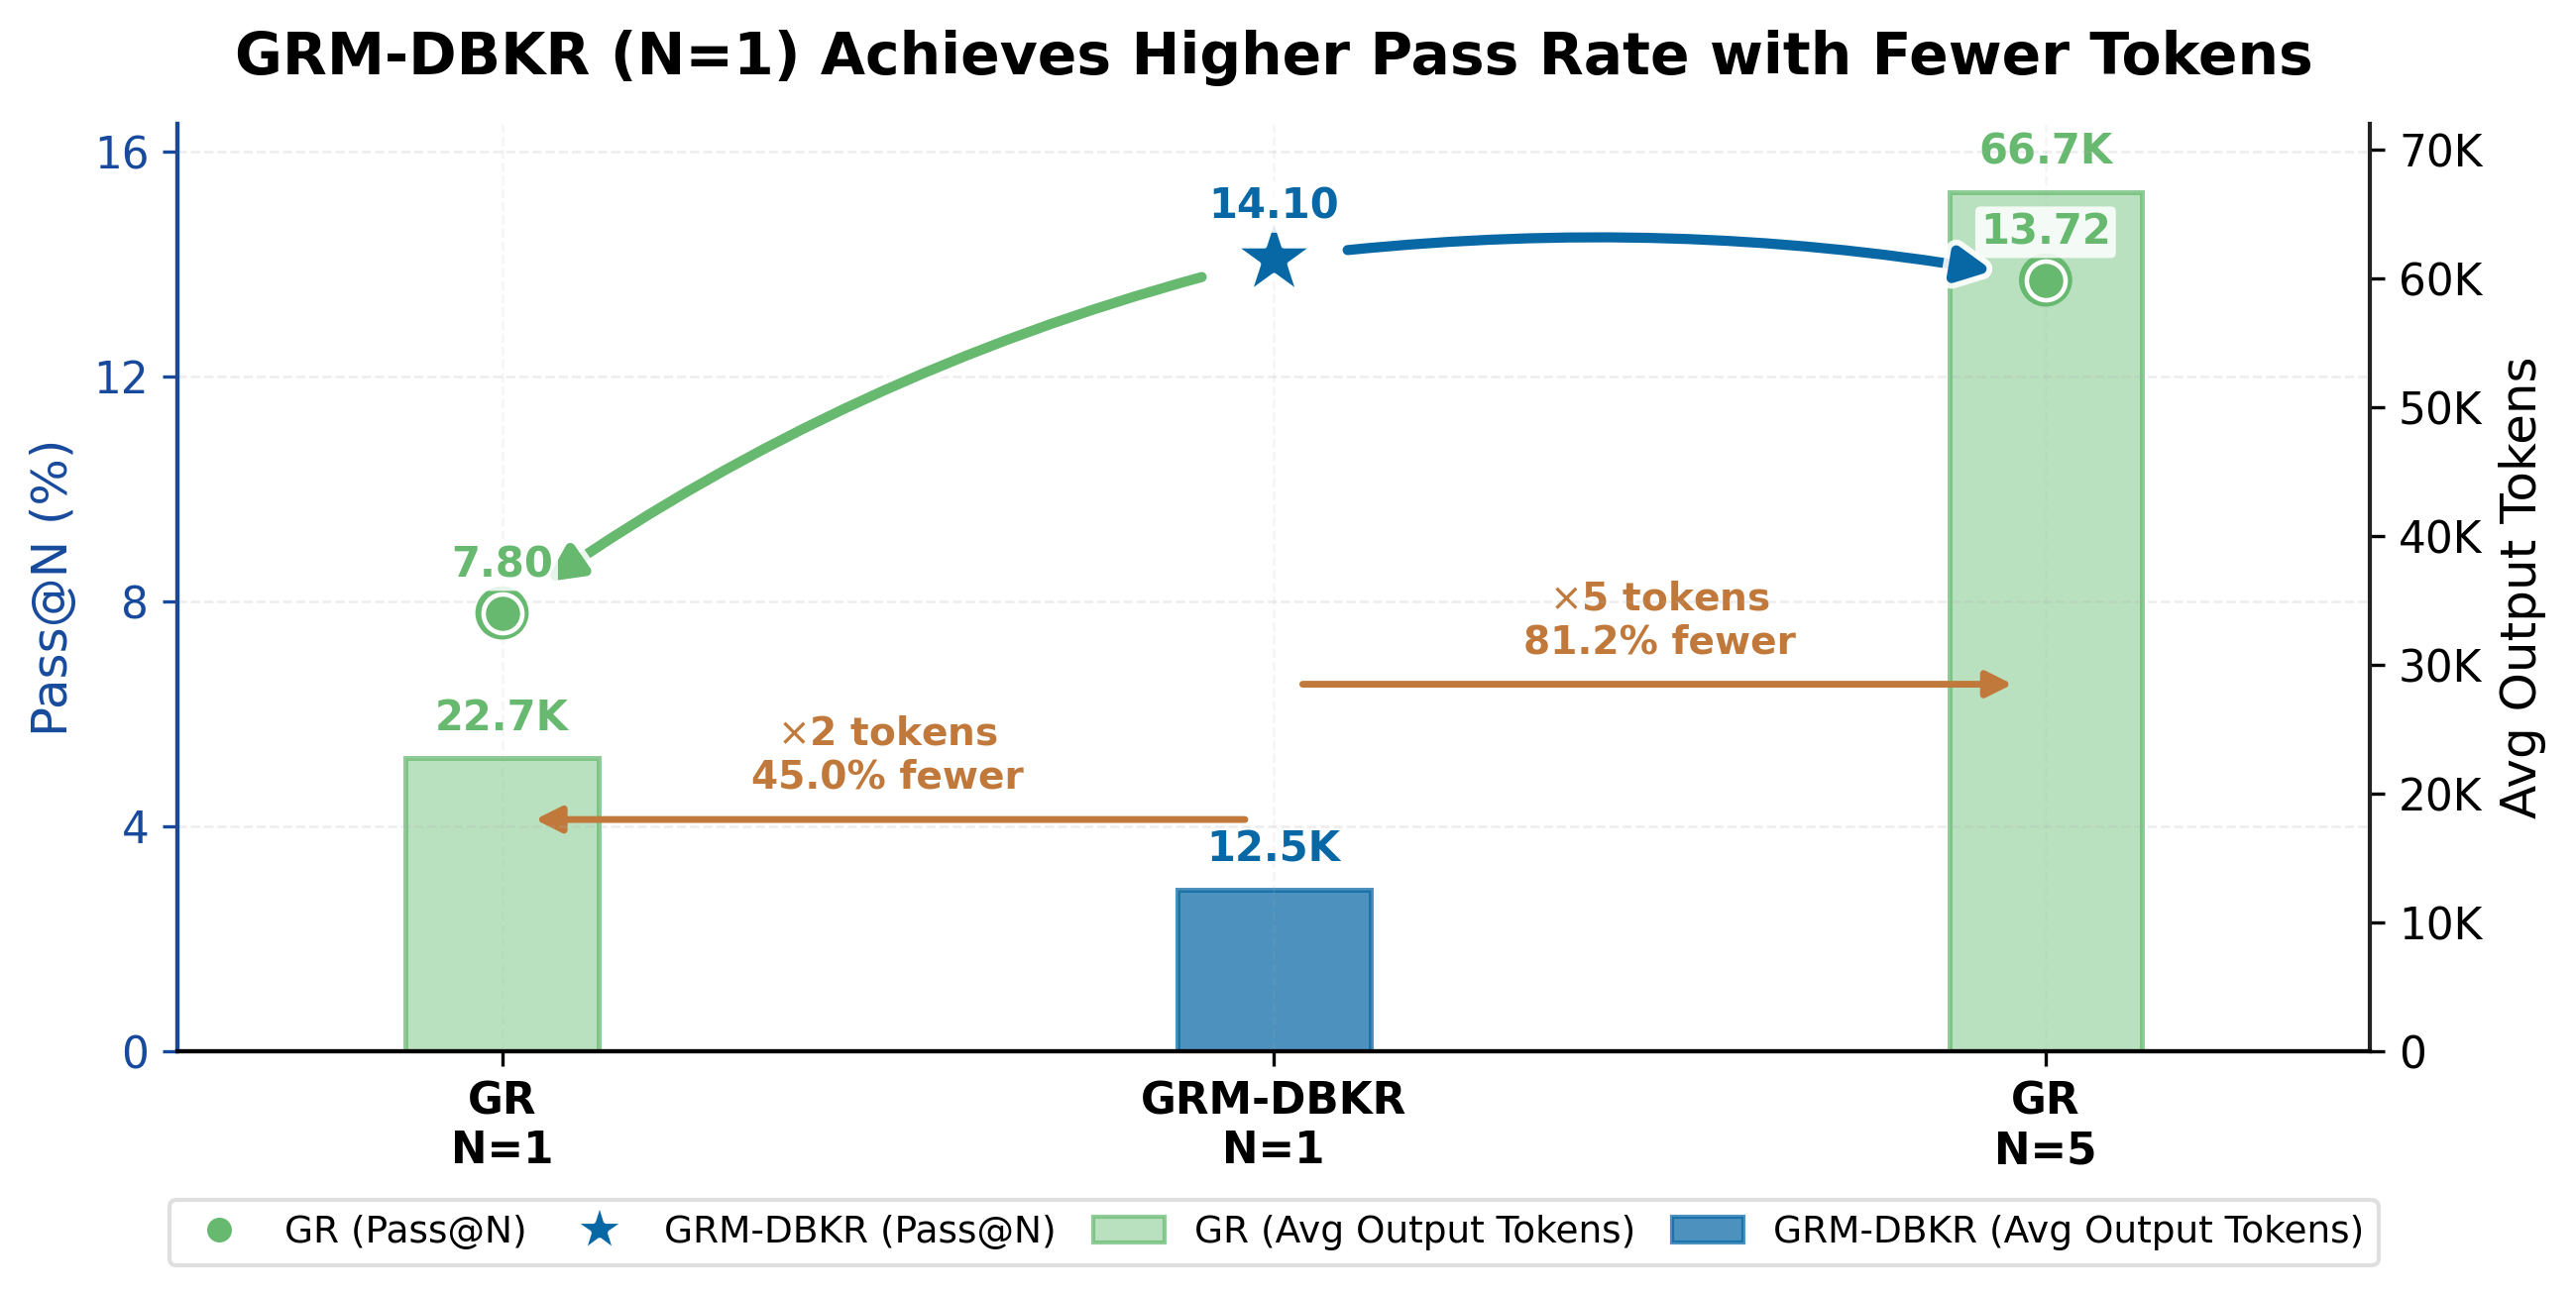
Одна направленная ветка FLARE показала лучший результат, чем пять глобальных повторов с начала задачи, а базовый агент израсходовал примерно в пять раз меньше выходных токенов. Экономия возникает не из более коротких ответов, а из того, что система сохраняет полезный префикс траектории и повторяет только продолжение после найденной точки сбоя.
При обучении с учителем тот же сигнал превращается в оценку всей траектории. Формула учитывает серьёзность и тип ошибки, её положение, редкость действия и повторение одинаковых сбоев. Отбор примеров по этой оценке повысил среднюю долю решённых задач на 19,13% относительно случайного отбора.
В обучении с подкреплением безопасные шаги получают положительный сигнал, а ошибочные — штраф, связанный с их серьёзностью и наблюдаемой способностью агента восстановиться. Такое плотное вознаграждение дополняет итоговый ответ «пройдено или провалено» и дало средний относительный прирост 9,19% против обучения только по конечному результату.
FLARE стоит проверять как общий слой, а не как замену основного агента
Архитектурный вывод работы — диагностическую модель можно переиспользовать на всём цикле. Вместо отдельных компонентов для перезапуска, отбора демонстраций и расчёта награды команда поддерживает одну структуру сигнала: когда вмешаться, что исправить и насколько поощрить шаг.
Подход проверяли на SWE-bench Verified, SWE-bench Pro, SWE-bench Multilingual и SWE-Compass. В запусках участвовали каркасы Cline и Claude Code, а также GLM-5, Kimi K2.5, Qwen3.5-Plus и DeepSeek V3.2. Для эксперимента с обучением с учителем использовали Qwen3-30B-A3B, поэтому результаты описывают репозиторные задачи и конкретные сочетания моделей, а не любых агентов с инструментами.
Наибольший смысл эксперимент с FLARE имеет там, где полные повторы дороги, а система хранит подробную историю действий и умеет продолжать работу от контрольной точки. Диагноз помогает перенаправить жизнеспособное решение, но не добавляет основному агенту способности написать исправление, которого тот в принципе не умеет находить.
Для продуктовой команды работа меняет скорее устройство эксперимента, чем выбор базовой модели. При сравнении агентов стоит измерять не только долю решённых задач, но и расход токенов на восстановление после ошибки; обучающие траектории — ранжировать по качеству процесса, а не только по финальному прохождению тестов.
Источники
Иллюстрация: рисунок из статьи «FLARE: A Full-Lifecycle Dense Supervision Paradigm for Long-Horizon Coding Agents via Generative Reward Model», Jingxuan Xu, Gang Wu, Yanan Wu и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


