
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Генерацию диффузионных LLM удалось ускорить без дообучения и вспомогательной модели. Flash-dLLM от VILA Lab и MBZUAI в лучшем замере работал в 11 раз быстрее прежнего метода, хотя препринт не прошёл рецензирование и все числа получили сами авторы. Работа показывает, что узким местом таких моделей может быть не вычисление, а движение данных в памяти GPU.
KV-кэш экономит вычисления, но перегружает память
Диффузионная LLM не пишет текст строго слева направо. Она начинает с замаскированной последовательности, предсказывает сразу несколько позиций, а затем уточняет результат за несколько шагов. Из-за этого модель многократно возвращается к одной последовательности, причём набор изменившихся токенов на каждом шаге различается.
Кэш ключей и значений (KV-кэш) хранит промежуточные данные механизма внимания, чтобы не вычислять их заново. В диффузионной модели кэш приходится часто читать и частично обновлять. Обычная реализация отдельно запускает проекцию запросов, ключей и значений, позиционное кодирование RoPE, запись в кэш и само внимание.
Между этими операциями промежуточные результаты попадают в высокоскоростную память GPU, а следующая операция считывает их обратно. Вычислений становится меньше, но обмен данными начинает занимать основное время.
Компонент Flash-Cache объединяет проекцию, RoPE и запись в одну операцию на GPU. Промежуточные ключи и значения остаются во внутренней памяти вычислительного блока и сразу попадают в кэш. Планировщик внимания дополнительно разбивает запросы на блоки, поэтому элементы одного пакета могут находиться на разных шагах генерации без выравнивания до общей длины.
Flash-Cache также обновляет не все декодированные позиции. В средних слоях модели 32 токена с наибольшим вниманием собирали до 50% его общего веса. Метод отслеживает такие позиции вместе с текущим окном масок, а остальные обслуживает из кэша без повторного вычисления.
Одна модель готовит токены и проверяет себя
Параллельная генерация ускоряет диффузионную LLM, но создаёт зависимость между ошибками. Если модель одновременно раскрывает несколько масок, каждый токен предсказывается без учёта соседних токенов, которые будут приняты на том же шаге. Поэтому прежние методы оставляли только варианты с уверенностью выше заданного порога, а остальные откладывали.
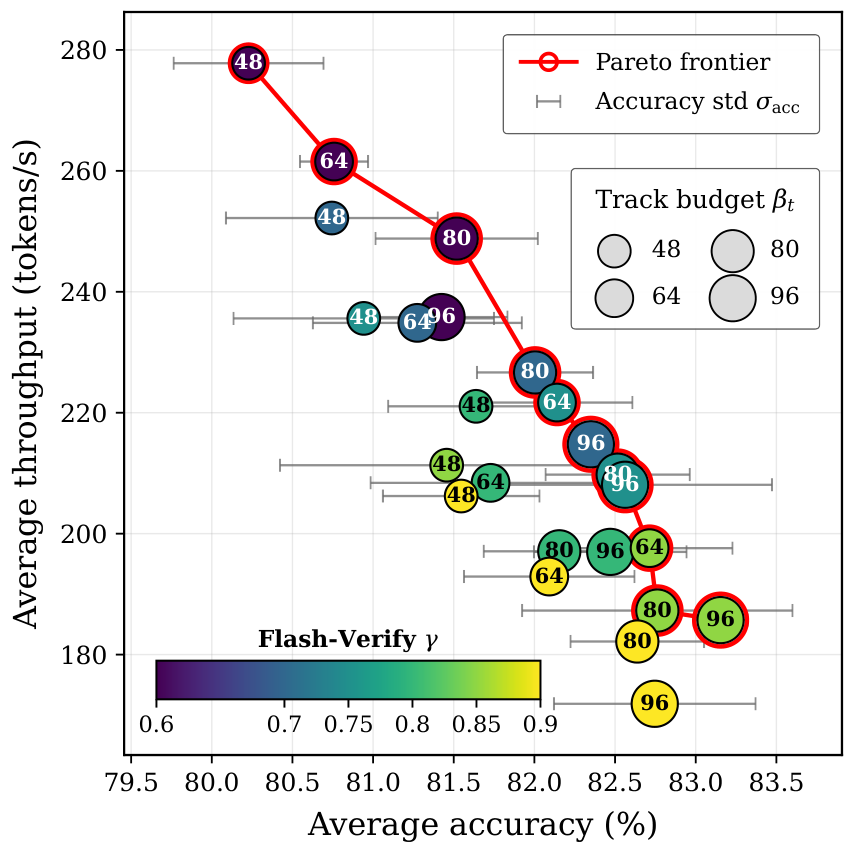
Flash-Verify использует отложенные варианты как черновик. Для каждого кандидата модель получает два представления одной позиции: в первом находится предложенный токен, во втором остаётся маска. Маска внимания не позволяет этим представлениям напрямую влиять друг на друга.
Токен принимается, если оба представления дают одинаковый ответ, а уверенность варианта с маской проходит порог. Проверка идёт слева направо и прекращается при первом расхождении. Та же диффузионная LLM выступает и генератором черновика, и проверяющей моделью, поэтому системе не нужен отдельный компактный генератор.
Дополнительный проход требует вычислений, но позволяет принять больше токенов за один цикл шумоподавления. Экономия возникает сразу в двух местах: Flash-Cache сокращает обмен с памятью, а Flash-Verify уменьшает число циклов до готового ответа.
Работа меняет план оптимизации, но не выбор класса модели
Метод проверяли на LLaDA-1.5, на математических задачах GSM8K и генерации кода HumanEval. Его сравнивали с методами ускорения диффузионных LLM, включая Elastic-Cache, Fast-dLLM и FreeDave. Это тест инфраструктуры внутри одного класса моделей, а не сравнение диффузионной архитектуры с промышленными серверами авторегрессионных LLM.
На GSM8K полный Flash-dLLM обошёл Elastic-Cache в 5,1 раза. Одно объединение операций Flash-Cache ускорило соответствующий участок в 1,37 раза на RTX 3090. При пакете из 16 запросов система заняла около 26 ГБ памяти GPU вместо 50 ГБ у Fast-dLLM. Точность на выбранных задачах при этом осталась на уровне сильнейших сравниваемых методов.
Для команды, которая уже строит продукт на диффузионной LLM, работа меняет порядок действий. Сначала стоит измерить чтение и запись KV-кэша, число запусков операций GPU и различия между запросами внутри пакета. Простое добавление кэша может не ускорить систему, если сэкономленные вычисления заменит лишний обмен с памятью.
Следующий кандидат на оптимизацию — совместная работа кэша и параллельного декодирования. Если развивать их отдельно, проверка дополнительных токенов снова увеличит движение данных. Flash-dLLM показывает архитектуру, где объединённая операция, блочный планировщик и самопроверка используют один формат кэша.
Внедрение потребует собственной операции для GPU и изменений в контуре выполнения модели: это не настройка порога через API. Командам на обычных авторегрессионных LLM работа не даёт основания менять архитектуру продукта. Она делает практичнее уже выбранную диффузионную модель и предлагает конкретный путь от исследовательского декодера к пакетному обслуживанию.
Источники
Иллюстрация: рисунок из статьи «Flash-dLLM: IO-Aware KV Caching and Parallel Decoding for Fast, Memory-Efficient Diffusion LLMs», Quan Nguyen-Tri, Mukul Ranjan, Zhiqiang Shen, CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


