
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
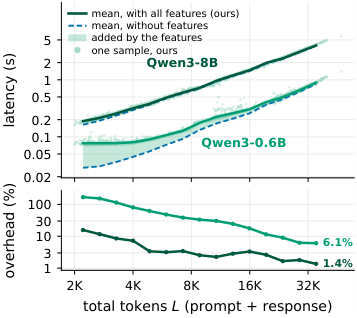
Проверять, подтверждён ли ответ исходным контекстом, можно с гораздо меньшим расходом памяти. В препринте команды Applied AI Institute, Yandex и Risk AI Research Lab, который не прошёл рецензирование и содержит замеры самих авторов, накладные расходы на извлечение признаков снизились с 16% до 1,4% по мере роста последовательности. Это делает отдельный компактный детектор практичнее для длинных ответов и систем с поиском по базе знаний.
Матрицу внимания заменили статистиками внутри FlashAttention
Детектор получает контекст и готовый ответ, пропускает их через отдельную замороженную модель и оценивает, насколько ответ опирается на контекст. Модель, которая сгенерировала ответ, может оставаться закрытой: доступ к её весам, вероятностям и механизму внимания не нужен.
Такие детекторы используют не всю матрицу внимания, а сводные признаки. Например, они измеряют, какая доля внимания токенов ответа приходится на исходный контекст, насколько внимание распределено между токенами и не стягивается ли оно к отдельным позициям.
Обычная реализация сначала сохраняет полную матрицу, а затем вычисляет статистики. Память при этом растёт квадратично с длиной последовательности, хотя итоговый набор признаков растёт линейно.
FlashAttention обрабатывает запросы и ключи плитками, сразу нормализует веса и не сохраняет матрицу целиком. Авторы встроили вычисление статистик в этот проход и разделили признаки по стоимости.
- Слитное вычисление. Масса внимания на контексте, энтропия, максимальный вес и эффективное число значимых позиций накапливаются одновременно с нормализацией. Дополнительные оценки внимания не нужны.
- Точечное чтение. Вес предыдущего токена, диагональный вес или внимание к началу последовательности восстанавливаются после прохода из запросов, ключей и сохранённого нормализатора.
- Повторный проход. Суммы по столбцам требуют ещё раз вычислить все оценки внимания, но матрицу по-прежнему не хранят.
- Плотный путь. Признаки, которым нужна вся структура графа внимания, всё ещё требуют материализации матрицы.
Разделение важно для проектирования детектора: признаки первых двух классов можно собирать почти по умолчанию, а признаки с повторным проходом стоит добавлять только после проверки их вклада в качество.
Вычислительные замеры провели на NVIDIA H100 NVL с пакетной обработкой одного примера и форматом bf16. Реализация на Triton извлекала признаки опубликованных детекторов из всех голов и слоёв Qwen3-8B; контекст и завершённый ответ обрабатывались целиком, а не по одному токену во время генерации.
Линейная память меняет предел длины ответа
Главный выигрыш дала не задержка, а память. На самом тяжёлом рассмотренном примере плотный путь добавил 2,1 ГиБ, тогда как новая реализация заняла 23 МиБ. Разрыв увеличивается вместе с произведением длины контекста и длины ответа, потому что новая схема хранит результаты на токен ответа, а не все пары токенов.
На коротких входах выигрыш по времени скрадывает фиксированный расход оболочки Python и синхронизации с GPU. С ростом последовательности полезная работа начинает доминировать, поэтому относительная цена извлечения признаков падает.
Сами признаки внимания тоже оказались полезны для классификации. Их добавление к скрытым состояниям и вероятностям токенов статистически значимо улучшило F1 в 6 из 12 сочетаний набора данных и прокси-модели и ни разу значимо не ухудшило результат. F1 объединяет точность с полнотой и показывает, насколько детектор одновременно избегает ложных тревог и находит неподтверждённые ответы.
Проверку качества провели на RAGTruth QA, HaluBench и TRIVIA+ с замороженными моделями семейства Qwen3. Сравнение охватывало компактные прокси, специализированные проверяющие модели и LLM, которым задавали инструкцию оценить ответ.
Для пакетной проверки архитектуру уже можно пересмотреть
Работа поддерживает архитектуру, в которой генератор и проверяющий компонент разделены. Генератор может быть внешним API, а собственная компактная модель читает сохранённые контекст и ответ, извлекает внутренние признаки и передаёт их небольшому обученному классификатору.
Такой вариант подходит для проверки готовых ответов: контроля результатов поиска по базе знаний, пакетного аудита диалогов и фильтра перед отправкой ответа. Qwen3-4B в этой роли обошёл сильнейшую из сравниваемых моделей-оценщиков на двух из трёх наборов, поэтому увеличивать детектор до размера генератора не обязательно.
Менять работающий контур генерации ради этой реализации пока рано. Ядро обрабатывает полный ответ за один вызов и не встроено в пошаговую генерацию; оно также не поддерживает скользящее окно и некоторые варианты ограничения весов внимания. Текущая оболочка добавляет заметный постоянный расход на коротких запросах.
Кроме того, прокси требует отдельного прохода модели и размеченных примеров для обучения классификатора. Он проверяет поддержку ответа переданным контекстом, а не истинность утверждений вообще, поэтому не заменяет фактологическую проверку.
Практический план — сначала собирать дешёвые слитные и точечные признаки на собственной выборке запросов. Повторный проход имеет смысл включать, только если признаки по столбцам дают измеримый прирост F1, а задержку и память следует проверять на реальном распределении длин, а не на среднем запросе.
Источники
Иллюстрация: рисунок из статьи «FlashAttention with Statistics: Low-Overhead Attention Features for Compact Hallucination Detectors», Andrei Volodichev, Maksim Savichev, Nikita Sviridov и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


