
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Историю действий LLM-агента научились сокращать без обучения отдельного модуля. В работе Microsoft FOCUS одновременно уменьшил контекст и повысил долю выполненных задач, хотя препринт не рецензирован и все замеры провели сами авторы. Такой слой можно подключить к закрытой модели через API, не собирая отдельный набор данных.
Важность шага определяет будущий план
История агента растёт после каждого обращения к инструменту: модель рассуждает, выполняет действие и получает ответ среды. Чем длиннее задача, тем больше старых сообщений приходится снова передавать модели. Это увеличивает расход токенов, задержку и нагрузку механизма внимания, которая растёт быстрее длины контекста.
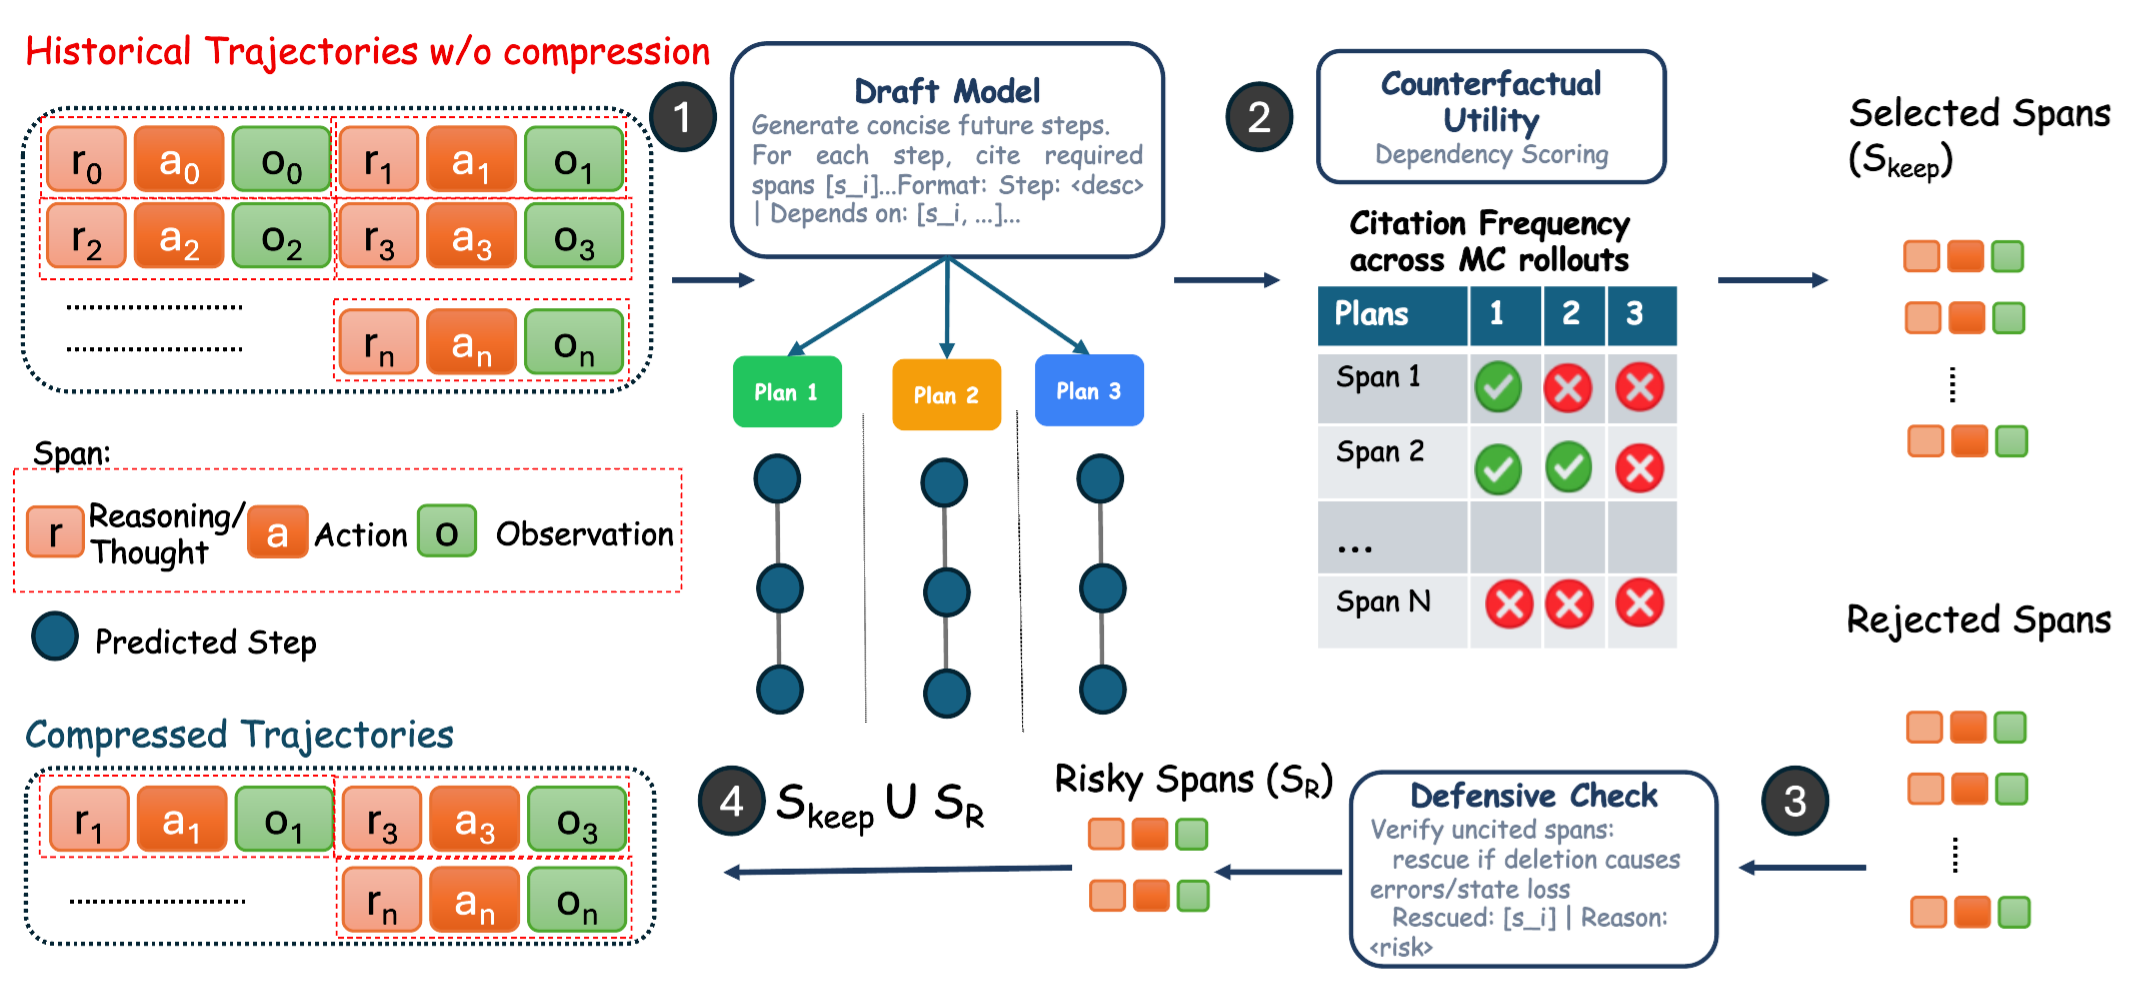
FOCUS делит историю не на отдельные токены, а на законченные шаги. Каждый шаг содержит рассуждение, действие или вызов инструмента и полученный результат. Поэтому модуль не может случайно оставить половину команды, удалить аргумент API или отделить сообщение об ошибке от вызвавшего её действия.
Когда история превышает заданный бюджет, черновая модель строит несколько вариантов дальнейшего плана. Для каждого будущего действия она указывает прошлые шаги, от которых оно зависит. Частота таких ссылок становится оценкой полезности: если разные планы снова обращаются к одному результату или ограничению, этот фрагмент остаётся в контексте.
Это приближает проверку, которую нельзя провести напрямую: изменится ли поведение агента, если удалить конкретный шаг. Вместо перебора будущих траекторий FOCUS смотрит, понадобится ли шаг в вероятных планах. Затем защитная проверка возвращает фрагменты, удаление которых может заставить агента повторить прежнюю ошибку или потерять важное состояние среды.
Сжатие происходит во время выполнения задачи. Политика не фиксируется заранее и может оставить разные части истории для двух внешне похожих запросов, если дальнейшие действия зависят от разных фактов.
Меньше контекста не означало меньше выполненных задач
В лучших конфигурациях FOCUS уменьшил пиковый объём контекста на 48%, а общий расход токенов — на 31%. Доля успешно выполненных задач при этом выросла на величину до 8,9 процентного пункта по сравнению с запуском без сжатия.
На OfficeBench общая стоимость обращений к API снизилась на 37%: дополнительные запросы к черновой модели окупились тем, что основная модель получала меньше входных токенов. Трёх вариантов будущего плана оказалось достаточно для устойчивой оценки; дальнейшие прогоны уже не улучшали результат последовательно.
Метод проверяли на OfficeBench, AppWorld, 8-QA, WebVoyager и τ2-Bench. Набор охватывает вызовы API и инструментов, ответы на вопросы, работу с веб-средой и диалоги из нескольких ходов. В экспериментах сочетали gpt-4.1 и gpt-4.1-mini, а также использовали Qwen3-8B как черновую модель.
Эти границы важны для интерпретации максимальных значений. Результат относится к агентам с длинными структурированными журналами, где старые наблюдения многократно попадают в следующие запросы. Конкретная экономия зависит от среды, длины задачи и выбранного порога сжатия.
FOCUS меняет слой управления контекстом, а не выбор основной модели
Команде не нужно менять основную LLM или получать доступ к её весам. FOCUS не использует внутренние вероятности модели: ему достаточно текстовых запросов и ответов через API. Поэтому метод можно добавить в оркестрацию между журналом агента и формированием следующего запроса.
Для внедрения историю придётся хранить как последовательность устойчиво размеченных шагов, чтобы черновая модель могла ссылаться на них в плане. Если система сейчас складывает все сообщения в одну строку или удаляет отдельные токены, потребуется изменить представление журнала. Вызовы инструментов, их результаты и ошибки должны оставаться цельными блоками.
Новая цена — дополнительные обращения к черновой модели при каждом сжатии. Их можно выполнять параллельно, но задержка и стоимость всё равно зависят от тарифов моделей, частоты сжатия и длины планов. Перед запуском стоит проверить на собственных траекториях три показателя: долю завершённых задач, полный расход токенов и время ответа.
FOCUS не заменяет долговременную память с поиском по документам. Он решает более узкую задачу: очищает рабочую историю текущего процесса, сохраняя факты, которые влияют на следующие действия. Для длинных агентов это повод выделить управление контекстом в отдельный слой, а не сразу увеличивать окно основной модели.
Источники
Иллюстрация: рисунок из статьи «FOCUS: Training-Free Decision-Preserving Context Compression for LLM Agents», Shantanu Dixit, Anson Bastos, Xuchao Zhang и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


